
Failed to create Spark client for Spark session
最近在hive里将mr换成spark引擎后,执行插入和一些复杂的hql会触发下面的异常:
org.apache.hive.service.cli.HiveSQLException: Error while compiling statement: FAILED: SemanticException Failed to get a spark session: org.apache.hadoop.hive.ql.metadata.HiveException: Failed to create Spark client for Spark session c5924990-6187-4a15-a760-ec3b1afbc199
未能创建spark客户端的原因有这几个:
1,spark没有打卡
2,spark和hive版本不匹配
3,hive连接spark客户端时长过短
解决方案:
1,在进入hive之前,需要依次启动hadoop,spark,hiveservice,这样才能确保hive在启动spark引擎时能成功
spark启动:
cd /opt/spark

./sbin/start-all.sh
2,版本问题是最常见也是出现最多的问题,我用的版本依次为hadoop3.3.0,hive3.1.2,spark2.4.7,之前测试过spark3.0.1,发现和hive不兼容
这里还需要注意Apache官网的提供了如图所示的几个spark包版本:

但在集成hive时spark本身不能自带hive配置,所以只有第三个是可以用的,但是我测试了一下在我的电脑上还是报错,所以我选择了自己编译,下载最后一个源码包,解压后进入spark目录
输入命令:
./dev/make-distribution.sh --name without-hive --tgz -Pyarn -Phadoop-3.3 -Dhadoop.version=3.3.0 -Pparquet-provided -Porc-provided -Phadoop-provided
但是发现编译卡住了,原来编译会自动下载maven,scala,zinc,存放在build目录下,如图:
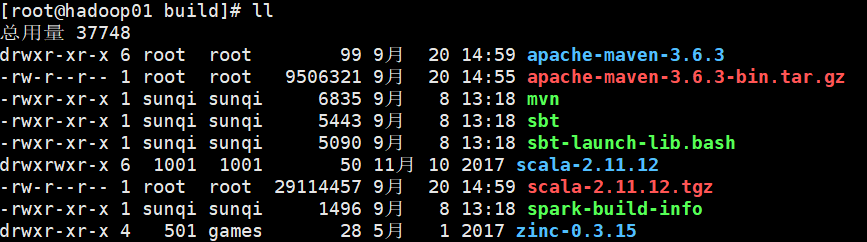
由于下载过于缓慢,这里直接将这三个包放在build目录下,解压好,编译时会自动识别,可以省去很多时间,快速进入编译,需要压缩包的可以关注公众号:Tspeaker97 给我发消息找我要
编译过程比较慢,我花了30分钟才将spark编译好,中间还网络断流卡住失败了一次,如果不能访问外网的,建议将maven镜像改为阿里云。
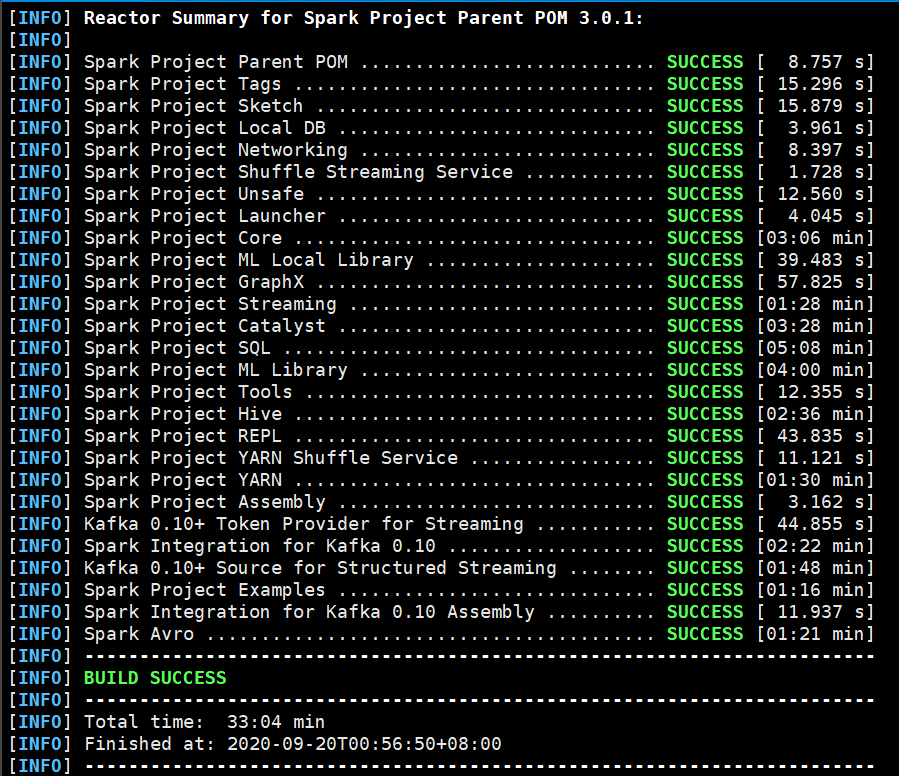
编译完成后在spark目录下就可以看到编译出的tgz包,解压到对应目录:
vim spark-env.sh

插入如下代码:

export SPARK_DIST_CLASSPATH=$(hadoop classpath)
接下来就是hive的设置,这里我用的是公司编译好的版本,大小比Apache官网大一点,想要可以微信扣我
进入hive/conf目录:
vim spark-defaults.conf

插入如下代码:

spark.master                             yarn

spark.eventLog.enabled                   true

spark.eventLog.dir                       hdfs://hadoop01:9820/spark-history

spark.executor.memory                    2g
在hdfs创建对应目录并拷贝jar包:
hadoop fs -mkdir /spark-history

hadoop fs -mkdir /spark-jars

hadoop fs -put /opt/spark/jars/* /spark-jars
在hive/conf/hive-site.xml中增加:(这里特地延长了hive和spark连接的时间,可以有效避免超时报错)
<!--Spark依赖位置-->

<property>

    <name>spark.yarn.jars</name>

    <value>hdfs://hadoop01:9820/spark-jars/*</value>

</property>

<!--Hive执行引擎-->

<property>

    <name>hive.execution.engine</name>

    <value>spark</value>

</property>

<!--Hive和spark连接超时时间-->

<property>

    <name>hive.spark.client.connect.timeout</name>

    <value>100000ms</value>

</property>
然后启动spark服务,hive服务,并进入hive客户端,执行hql:
set hive.exec.mode.local.auto=true;

create table visit(user_id string,shop string) row format delimited fields terminated by '\t';

load data local inpath '/opt/hive/datas/user_id' into table visit;

SELECT t1.shop,

       t1.user_id,

       t1.count,

       t1.rank

FROM

  (SELECT shop,

          user_id,

          count(user_id) COUNT,

          rank() over(partition BY shop ORDER BY count(user_id) DESC) rank

   FROM visit

   GROUP BY user_id,

            shop

   ORDER BY shop ASC, COUNT DESC ) t1

WHERE rank <4;
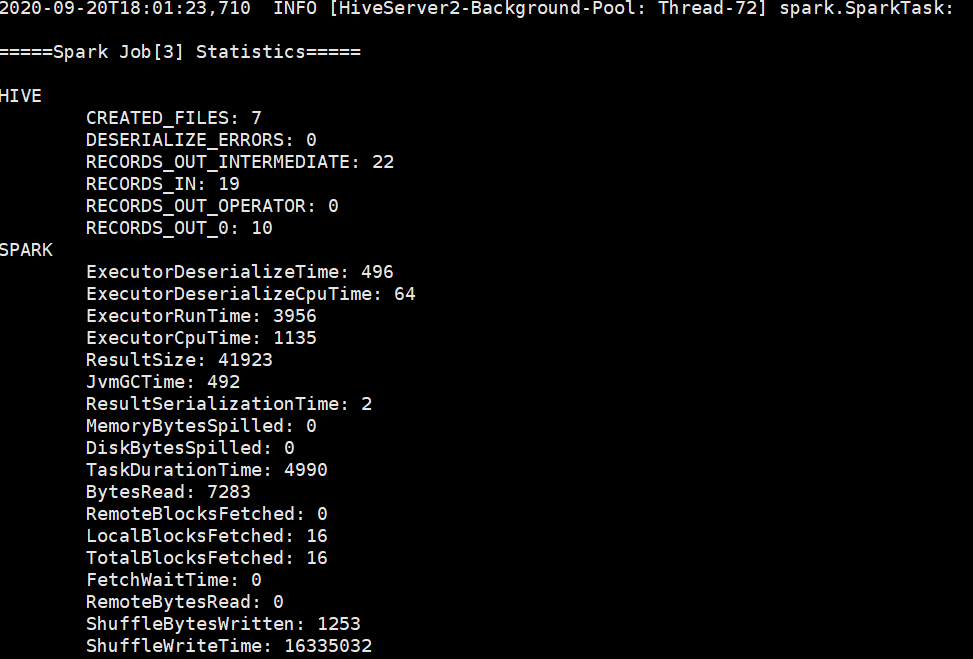
spark引擎成功启动:
如果有其他问题,欢迎叨扰:
Failed to create Spark client for Spark session的更多相关文章
- hive on spark:return code 30041 Failed to create Spark client for Spark session原因分析及解决方案探寻
最近在Hive中使用Spark引擎进行执行时(set hive.execution.engine=spark),经常遇到return code 30041的报错,为了深入探究其原因,阅读了官方issu ...
- AX2012 R3 Data upgrade checklist sync database step, failed to create a session;
最近在做AX2012 R3 CU9 到CU11的upgrade时 (用的Admin帐号), 在Date upgrade 的 synchronize database 这步 跑了一半,报出错误 说“fa ...
- Tensorflow 报错:tensorflow.python.framework.errors_impl.InternalError: Failed to create session.
问题描述 IDE:pycharm,环境中安装tensorflow-gpu 1.8.0 ,Cuda9 ,cudnn 7,等,运行代码 报错如下 tensorflow.python.framework.e ...
- Spark On Yarn报警告信息 WARN yarn.Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
1 贴出完整日志信息 // :: INFO client.RMProxy: Connecting to ResourceManager at hdp1/ // :: INFO yarn.Client: ...
- Spark Client启动原理探索
经过几天闲暇时间的学习,终于又理解的深入了一些,关于Spark Client如何提交作业也更清晰了点. 在整体的流程图上是这样的: 大体的思路就是应用程序通过SparkSubmit提交程序后,自动在当 ...
- 用NFS挂载root出现:NFS: failed to create MNT RPC client, status=-101(-110)
2014-02-18 08:06:17 By Ly #Linux 阅读(78) 评论(0) 错误信息如下: Root-NFS: nfsroot=/home/zenki/nfs/rootfs NFS ...
- spark client + yarn计算
前提:完成hadoop + kerberos安全环境搭建. 安装配置spark client: 1. wget https://d3kbcqa49mib13.cloudfront.net/spark- ...
- 【原创】大数据基础之Spark(1)Spark Submit即Spark任务提交过程
Spark2.1.1 一 Spark Submit本地解析 1.1 现象 提交命令: spark-submit --master local[10] --driver-memory 30g --cla ...
- Docker 搭建Spark 依赖sequenceiq/spark:1.6镜像
使用Docker-Hub中Spark排行最高的sequenceiq/spark:1.6.0. 操作: 拉取镜像: [root@localhost home]# docker pull sequence ...
随机推荐
- 老猿学5G随笔:5G核心网中与用户数据相关的NF功能体UDM、AUSF、PCF、UDR
在业务支撑工作中,与核心网主要的交互包括用户数据管理(含签约关系.策略数据),5G核心网中与用户数据相关的NF功能体包括UDM.AUSF和PCR以及UDR,在此只简单介绍这些NF的功能: UDM:统一 ...
- 第15.20节 PyQt(Python+Qt)入门学习:QColumnView的作用及开发中对应Model的使用
老猿Python博文目录 专栏:使用PyQt开发图形界面Python应用 老猿Python博客地址 一.概述 在Qt Designer的Item Views(Model-based)部件中,Colum ...
- Android基础02
初识安卓的另一个重要的组件---广播. 1.广播的分类 标准广播:是一种完全异步执行的广播,在广播发出之后,所有的广播 接收器几乎都会在同一时刻接收到这条广播消息,因此它们之间没有任何先后顺序可言.这 ...
- FM解析(因子分解机,2010)
推荐参考:(知乎) https://zhuanlan.zhihu.com/p/37963267 要点理解: 1.fm应用场景,为什么提出了fm(和lr的不同点) ctr预测,特征组合,fm的隐向量分解 ...
- typora字体与字体颜色
字体 基本格式:\字体信息{内容} 罗马体\rm \rm{罗马体abc}>>\(\rm{罗马体abc}\) 意大利体\it \it{意大利体}>>\(\it{意大利体}\) 等 ...
- Java并发编程的艺术(三)——synchronized
什么是synchronized synchronized可以保证某个代码块或者方法被一个线程占有,保证了一个线程的可先性.java 1.6之前是重量级锁,在1.6进行了各种优化,就不那么重了,并引入了 ...
- geoserver的demo使用过程
先贴一个效果图,使用的geoserver版本2.18.0,需要对应版本插件netcdf插件[Extensions>Coverage Formats>NetCDF],使用tomcat8进行发 ...
- k8s之yaml文件书写格式
k8s之yaml文件书写格式 1 # yaml格式的pod定义文件完整内容: 2 apiVersion: v1 #必选,版本号,例如v1 3 kind: Pod #必选,Pod 4 metadata: ...
- webstorm2017.02版本如何使用material theme
本想废话一番,表达对material theme的喜欢.还是直接说方法吧~ file-settings-Plugins-Browse repositories-搜索 material theme -选 ...
- Int,String,Integer,double之间的类型的相互转换
Int整数,String字符串之间的类型的转换 int转成String 结果为: String转成int类型 结果为: double转成String 结果为: String转成double 结果为: ...