
how to avoid over-fitting?(机器学习中防止过拟合的方法,重要)
methods to avoid overfitting:
- Cross-Validation : Cross Validation in its simplest form is a one round validation, where we leave one sample as in-time validation and rest for training the model. But for keeping lower variance a higher fold cross validation is preferred.
- Early Stopping : Early stopping rules provide guidance as to how many iterations can be run before the learner begins to over-fit.
- Pruning : Pruning is used extensively while building CART models. It simply removes the nodes which add little predictive power for the problem in hand.
- Regularization : This is the technique we are going to discuss in more details. Simply put, it introduces a cost term for bringing in more features with the objective function. Hence, it tries to push the coefficients for many variables to zero and hence reduce cost term.
参考:
https://www.analyticsvidhya.com/blog/2015/02/avoid-over-fitting-regularization/
1、获取更多数据:解决过拟合最有效的方法
从数据源头获取更多数据
根据当前数据集估计数据分布参数,使用该分布产生更多数据
数据增强(Data Augmentation):通过一定规则扩充数据,比如图像平移、翻转、缩放、切割等
2、改变模型网络结构Architecture
减少网络的层数、神经元个数等均可以限制网络的拟合能力
3、Early stopping
对于每个神经元而言,其激活函数在不同区间的性能是不同的:
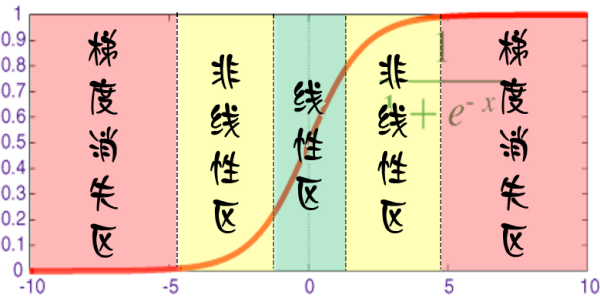
当网络权值较小时,神经元的激活函数工作在线性区,此时神经元的拟合能力较弱(类似线性神经元)。因为我们在初始化网络的时候一般都是初始为较小的权值。训练时间越长,部分网络权值可能越大。如果我们在合适时间停止训练,就可以将网络的能力限制在一定范围内。
3、正则化
4、增加噪声
1)在输入中增加噪声
2)在权值上增加噪声:在初始化网络的时候,用0均值的高斯分布作为初始化。
5、bagging:以随机森林(Rand Forests)为例,就是训练了一堆互不关联的决策树。但由于训练神经网络本身就需要耗费较多自由,所以一般不单独使用神经网络做Bagging。
6、boosting:既然训练复杂神经网络比较慢,那我们就可以只使用简单的神经网络(层数、神经元数限制等)。通过训练一系列简单的神经网络,加权平均其输出。
7、dropout
https://www.zhihu.com/question/59201590
how to avoid over-fitting?(机器学习中防止过拟合的方法,重要)的更多相关文章
- 机器学习中jupyter lab的安装方法以及使用的命令
安装JupyterLab使用pip安装: pip install jupyterlab# 必须将用户级目录添加 到环境变量才能启动pip install --userbinPATHjupyter la ...
- 机器学习中模型泛化能力和过拟合现象(overfitting)的矛盾、以及其主要缓解方法正则化技术原理初探
1. 偏差与方差 - 机器学习算法泛化性能分析 在一个项目中,我们通过设计和训练得到了一个model,该model的泛化可能很好,也可能不尽如人意,其背后的决定因素是什么呢?或者说我们可以从哪些方面去 ...
- 机器学习中的L1、L2正则化
目录 1. 什么是正则化?正则化有什么作用? 1.1 什么是正则化? 1.2 正则化有什么作用? 2. L1,L2正则化? 2.1 L1.L2范数 2.2 监督学习中的L1.L2正则化 3. L1.L ...
- 深度学习中 --- 解决过拟合问题(dropout, batchnormalization)
过拟合,在Tom M.Mitchell的<Machine Learning>中是如何定义的:给定一个假设空间H,一个假设h属于H,如果存在其他的假设h’属于H,使得在训练样例上h的错误率比 ...
- MIT一牛人对数学在机器学习中的作用给的评述
MIT一牛人对数学在机器学习中的作用给的评述 转载自http://my.oschina.net/feedao/blog/52252,不过这个链接也是转载的,出处已经无从考证了. 感觉数学似乎总是不 ...
- 机器学习中的相似性度量(Similarity Measurement)
机器学习中的相似性度量(Similarity Measurement) 在做分类时常常需要估算不同样本之间的相似性度量(Similarity Measurement),这时通常采用的方法就是计算样本间 ...
- paper 127:机器学习中的范数规则化之(二)核范数与规则项参数选择
机器学习中的范数规则化之(二)核范数与规则项参数选择 zouxy09@qq.com http://blog.csdn.net/zouxy09 上一篇博文,我们聊到了L0,L1和L2范数,这篇我们絮叨絮 ...
- paper 126:[转载] 机器学习中的范数规则化之(一)L0、L1与L2范数
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数
L1正则会产生稀疏解,让很多无用的特征的系数变为0,只留下一些有用的特征 L2正则不让某些特征的系数变为0,即不产生稀疏解,只让他们接近于0.即L2正则倾向于让权重w变小.见第二篇的推导. 所以,样本 ...
随机推荐
- docker系列之网络配置
docker 网络配置 docker 安装后, 会自动在系统做一个网桥配置 docker0 . 其容器都会分配到此网桥配置下的独立, 私有 IP 地址. 如果你要自己配置桥接, 也可以把 docker ...
- rom bist scripts
rom bist 的input 有rom_content file .校验rom还坏,主要通过signature比较.signature跟rom content file 一一对应的. rom bis ...
- python列表的增删改查用法
列表,元组 查 索引(下标) ,都是从0开始 切片 .count 查某个元素的出现次数 .index 根据内容找其对应的位置 "haidilao ge" in a 增加 a.app ...
- django第三天(路由基础和路由分配)
路由基础 url(正则路径,视图函数地址,默认关键字参数,路由别名) 路由由上而下匹配, ""可以匹配任意路由 "^$"来匹配"/" url ...
- teatime、
Python之路,Day7 - 面向对象编程进阶 本节内容: 面向对象高级语法部分 经典类vs新式类 静态方法.类方法.属性方法 类的特殊方法 反射 异常处理 Socket开发基础 作业:开发一个 ...
- url编码&&PHP大法&&这个看起来有点简单&&HTML 中有用的字符实体
URL编码 Url编码通常也被称为百分号编码(Url Encoding,also known as percent-encoding),是因为它的编码方式非常简单,使用%百分号加上两位的字符——012 ...
- 45个有用的JavaScript技巧
众所周知,JavaScript是世界上最流行的变成语言,不管是web网页,手机APP(例如PhoneGap或Appcelerator),还是服务器端(例如NodeJS或Wakanda)还有许多其他的实 ...
- PHP 页面跳转的三种方式
第一种方式:header() header()函数的主要功能是将HTTP协议标头(header)输出到浏览器. 语法: void header ( string $string [, bool $re ...
- HDU-4825 Xor Sum,字典树好题!
Xor Sum 一遍A了之后大呼一声好(keng)题!debug了两小时~~~~百度之星资格赛,可以. 题意:给你一个n个元素的数组,m次查询,每次输入一个数k要求从数组中找到一个数与k异或值最大,输 ...
- 【Go】并发编程
Go语言宣扬用通讯的方式共享数据. Go语言以独特的并发编程模型傲视群雄,与并发编程关系最紧密的代码包就是sync包,意思是同步.同步的用途有两个,一个是避免多个线程在同一时刻操作同一个数据块,另一个 ...