
Hadoop & Spark & Hive & HBase
Hadoop:http://hadoop.apache.org/docs/r2.6.4/hadoop-project-dist/hadoop-common/SingleCluster.html
bin/hdfs namenode -formatsbin/start-dfs.sh
bin/hdfs dfs -mkdir /userbin/hdfs dfs -mkdir /user/<username>these are for testing:
bin/hdfs dfs -put etc/hadoop inputbin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.4.jar grep input output 'dfs[a-z.]+'bin/hdfs dfs -cat output/*testing results:
6 dfs.audit.logger4 dfs.class3 dfs.server.namenode.2 dfs.period2 dfs.audit.log.maxfilesize2 dfs.audit.log.maxbackupindex1 dfsmetrics.log1 dfsadmin1 dfs.servers1 dfs.replication1 dfs.fileHistoryServer
./sbin/mr-jobhistory-daemon.sh start historyserverSpark:start:
./sbin/start-slaves.sh spark://<your-computer-name>:7077You will see:
- Alive Workers: 1
This is for testing:
./bin/spark-shell --master spark://<your-computer-name>:7077You will see the scala shell.use :q to quit.
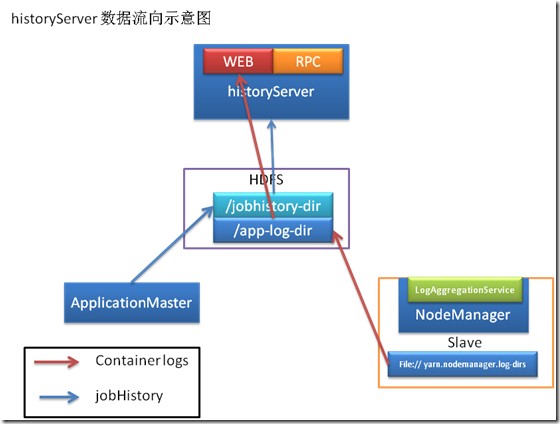
To see the history:
http://spark.apache.org/docs/latest/monitoring.html
http://blog.chinaunix.net/uid-29454152-id-5641909.html
http://www.cloudera.com/documentation/cdh/5-1-x/CDH5-Installation-Guide/cdh5ig_spark_configure.html
./sbin/start-history-server.sh
jdbc:mysql://localhost:3306/hivedb?useSSL=false&createDatabaseIfNotExist=true
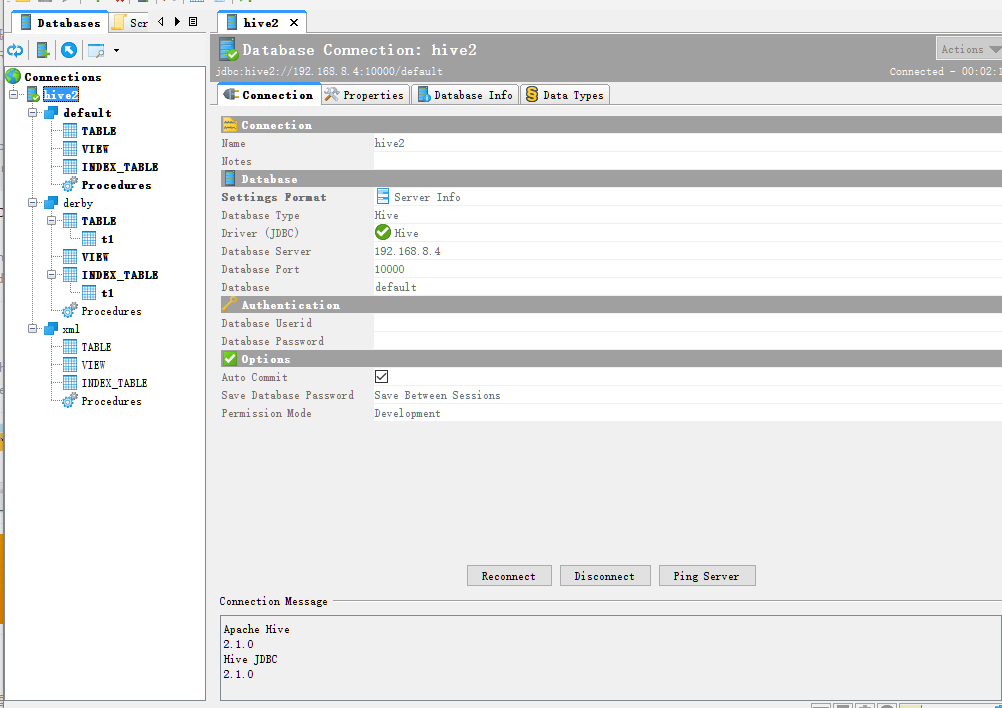
nohup hiveserver2 &
User: is not allowed to impersonate anonymous (state=,code=0)
HWI WAR file not found at
Problem: failed to create task or type componentdef- Or:
./bin/start-hbase.sh
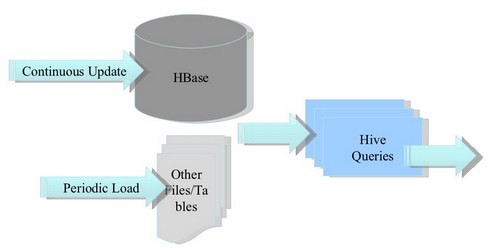
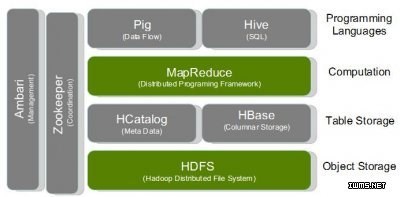
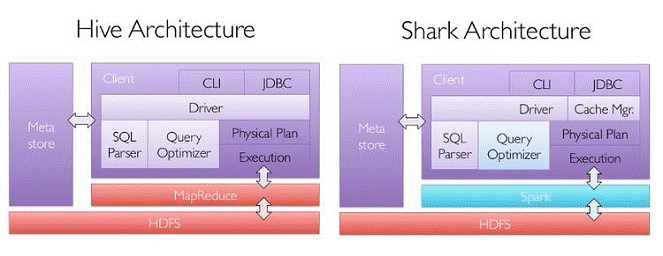
Hive & Shark & SparkSQL

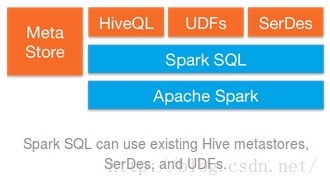
Spark SQL架构如下图所示:
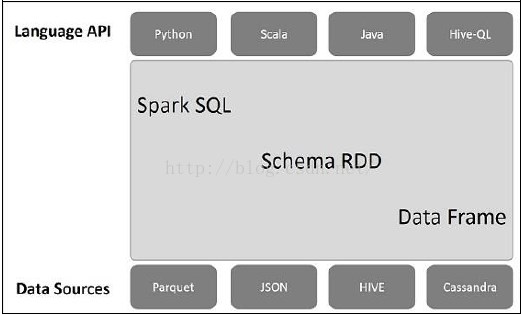
http://blog.csdn.net/wzy0623/article/details/52249187
- queryserver.py start
- jdbc:phoenix:thin:url=http://localhost:8765;serialization=PROTOBUF
phoenix-sqlline.py localhost:2181
Hadoop & Spark & Hive & HBase的更多相关文章
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- HADOOP+SPARK+ZOOKEEPER+HBASE+HIVE集群搭建(转)
原文地址:https://www.cnblogs.com/hanzhi/articles/8794984.html 目录 引言 目录 一环境选择 1集群机器安装图 2配置说明 3下载地址 二集群的相关 ...
- hadoop之hive&hbase互操作
大家都知道,hive的SQL操作非常方便,但是查询过程中需要启动MapReduce,无法做到实时响应. hbase是hadoop家族中的分布式数据库,与传统关系数据库不同,它底层采用列存储格式,扩展性 ...
- 大数据学习系列之九---- Hive整合Spark和HBase以及相关测试
前言 在之前的大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 中介绍了集群的环境搭建,但是在使用hive进行数据查询的时候会非常的慢,因为h ...
- Hadoop + Hive + HBase + Kylin伪分布式安装
问题导读 1. Centos7如何安装配置? 2. linux网络配置如何进行? 3. linux环境下java 如何安装? 4. linux环境下SSH免密码登录如何配置? 5. linux环境下H ...
- 【原创】大叔问题定位分享(16)spark写数据到hive外部表报错ClassCastException: org.apache.hadoop.hive.hbase.HiveHBaseTableOutputFormat cannot be cast to org.apache.hadoop.hive.ql.io.HiveOutputFormat
spark 2.1.1 spark在写数据到hive外部表(底层数据在hbase中)时会报错 Caused by: java.lang.ClassCastException: org.apache.h ...
- Docker搭建大数据集群 Hadoop Spark HBase Hive Zookeeper Scala
Docker搭建大数据集群 给出一个完全分布式hadoop+spark集群搭建完整文档,从环境准备(包括机器名,ip映射步骤,ssh免密,Java等)开始,包括zookeeper,hadoop,hiv ...
- 大数据技术生态圈形象比喻(Hadoop、Hive、Spark 关系)
[摘要] 知乎上一篇很不错的科普文章,介绍大数据技术生态圈(Hadoop.Hive.Spark )的关系. 链接地址:https://www.zhihu.com/question/27974418 [ ...
- spark读取hbase形成RDD,存入hive或者spark_sql分析
object SaprkReadHbase { var total:Int = 0 def main(args: Array[String]) { val spark = SparkSession . ...
随机推荐
- windows安装tesseract-OCR及使用
tesseract是Python的一个OCR(光学字符识别)库 首先下载tesseract的exe安装文件 https://github.com/UB-Mannheim/tesseract/wik ...
- ui2-3
2016.9讲义 一.课程的主要内容和目的 二.课程所用工具软件——Photoshop CS6 1. Photoshop 的发展史 1990.2,ps1.0问世,1991.2,PS2.0发行,此后,进 ...
- 洛谷P3830 [SHOI2012]随机树(期望dp)
题面 luogu 题解 第一问: 设\(f[i]\)表示\(i\)步操作后,平均深度期望 \(f[i] = \frac {f[i - 1] * (i - 1)+f[i-1]+2}{i}=f[i-1]+ ...
- centos 7修改系统支持中文编码
2019-03-14 查看系统现支持编码 }[root@web dc2-user]#locale LANG=en_US.UTF- LC_CTYPE="en_US.UTF-8" LC ...
- mono for android读书笔记之真机调试(转)
调试环境: 1.软件:monodevelop v3.0.3.5 2.硬件:华为C8650s手机一部,数据线一根,thinkpad e420笔记本电脑一台 调试的应用程序有一个Activity,Acti ...
- (转)Asp.Net Mvc视图引擎Razor介绍
Asp.Net Mvc视图引擎Razor介绍 1.Razor介绍 程序园原创,转载请注明:http://www.kwstu.com/ArticleView/dabaomvc_2014082408205 ...
- 用Akka构建一个简易的分布式文件系统
本来初期打算用Hadoop 2,可是后来有限的服务器部署了Solr Cloud,各种站点,发现资源不够了,近10T的文件,已经几乎把服务器的磁盘全部用光.想来想去,由于目前架构基于Scala的,所以还 ...
- Code First配合Entity Framework Power Tools Beta 4使用
基于现有数据库生成POCO数据类和数据库上下文需要借助Visual Studio一个扩展插件-- Entity Framework Power Tools(一个Code First反向工程工具).只要 ...
- i.mx6 Android5.1.1 servicemanager本地服务
接在之前的 i.mx6 Android5.1.1 初始化流程之init进程 i.mx6 Android5.1.1 初始化流程之init.rc解析 servicemanager是由init创建的本地服务 ...
- Redis常用命令整理
doc 环境下使用命令: keys 命令 ? 匹配一个字符 * 匹配任意个(包括0个)字符 [] 匹配括号间的任一个字符, ...