
搭建Elasticsearch 5.4分布式集群
多机集群中的节点可以分为master nodes和data nodes,在配置文件中使用Zen发现(Zen discovery)机制来管理不同节点。Zen发现是ES自带的默认发现机制,使用多播发现其它节点。只要启动一个新的ES节点并设置和集群相同的名称这个节点就会被加入到集群中。
Elasticsearch集群中有的节点一般有三种角色:master node、data node和client node。
- master node:master几点主要用于元数据(metadata)的处理,比如索引的新增、删除、分片分配等。
- data node:data 节点上保存了数据分片。它负责数据相关操作,比如分片的 CRUD,以及搜索和整合操作。这些操作都比较消耗 CPU、内存和 I/O 资源;
- client node:client 节点起到路由请求的作用,实际上可以看做负载均衡器。( 对于没有很多请求的业务,client node可以不加,master和data足矣)
二、基于2.X的集群配置
选取10.90.4.9这台机器做为client node,elasticsearch.yml中的配置如下:
cluster.name: ucas

node.name: node-09

node.master: true

node.data: false

network.host: 0.0.0.0

discovery.zen.ping.unicast.hosts: ["10.90.4.9"]

discovery.zen.ping.multicast.enabled: true
注意端口不是9200,而是9300。也可以不写端口。
启动10.90.4.9上的es服务器,现在只是一个单机集群。
在10.90.4.8这台机器上配置好同样的ES作为master node,elasticsearch.yml中的配置如下:
cluster.name: ucas

node.name:  node-08

node.master: true

node.data: true

network.host: 0.0.0.0

discovery.zen.ping.unicast.hosts: ["10.90.4.9"]

discovery.zen.ping.multicast.enabled: true
10.90.4.7作为data node,配置如下:
cluster.name: ucas

node.name: node-07

node.master: false

node.data: true

network.host: 0.0.0.0

discovery.zen.ping.unicast.hosts: ["10.90.4.9"]

discovery.zen.ping.multicast.enabled: true访问http://10.90.4.9:9200/_plugin/head/
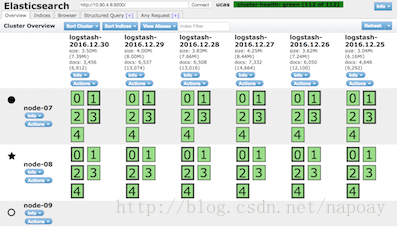
如图,node-09为client节点,不存储数据。
三、基于5.4的多机集群配置
ELasticsearch 5.4要求JDK版本最低为1.8,由于服务器上的JDK版本为1.7并且Java环境变量写在/etc/profile里面,改JDK会影响其他程序,这次基于5.4在我的mac和另外一台Ubuntu 做测试。
mac上的本机ip为192.168.1.111,设为master节点,配置如下:
cluster.name: my-application

node.name: node-111

network.host: 192.168.1.111

http.port: 9200

http.cors.enabled: true

http.cors.allow-origin: "*"

node.master: true

node.data: true

discovery.zen.ping.unicast.hosts: ["192.168.1.111"]
Ubuntu机器的ip位192.168.1.102,配置如下:
cluster.name: my-application

node.name: node-102

network.host: 192.168.1.102

http.port: 9200

http.cors.enabled: true

http.cors.allow-origin: "*"

node.master: false

node.data: true

discovery.zen.ping.unicast.hosts: ["192.168.1.111"]
先启动mac上的master,再启动Ubuntu上的slave节点,观察输出,会有一个node-102探测到master节点的提示:
2017-06-07T11:33:39,369][INFO ][o.e.c.s.ClusterService ] [node-102] detected_master {node-111}{3dQd1RRVTMiKdTckM68nPQ}{H6Zu7PAQRWewUBcllsQWTQ}{192.168.1.111}{192.168.1.111:9300}, added {{node-111}{3dQd1RRVTMiKdTckM68nPQ}{H6Zu7PAQRWewUBcllsQWTQ}{192.168.1.111}{192.168.1.111:9300},}, reason: zen-disco-receive(from master [master {node-111}{3dQd1RRVTMiKdTckM68nPQ}{H6Zu7PAQRWewUBcllsQWTQ}{192.168.1.111}{192.168.1.111:9300} committed version [8]])'- 1
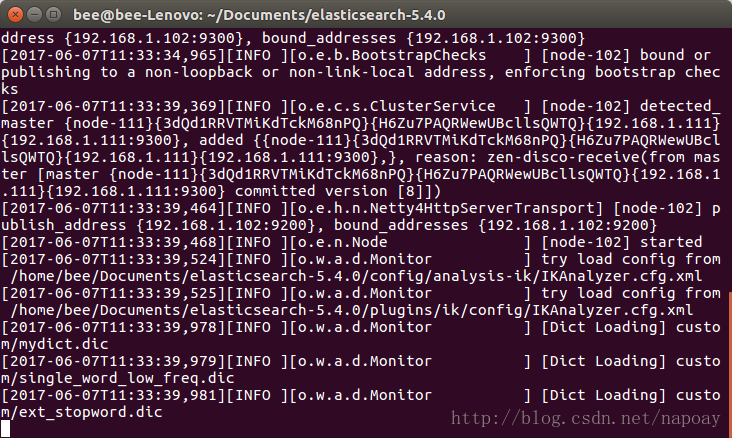
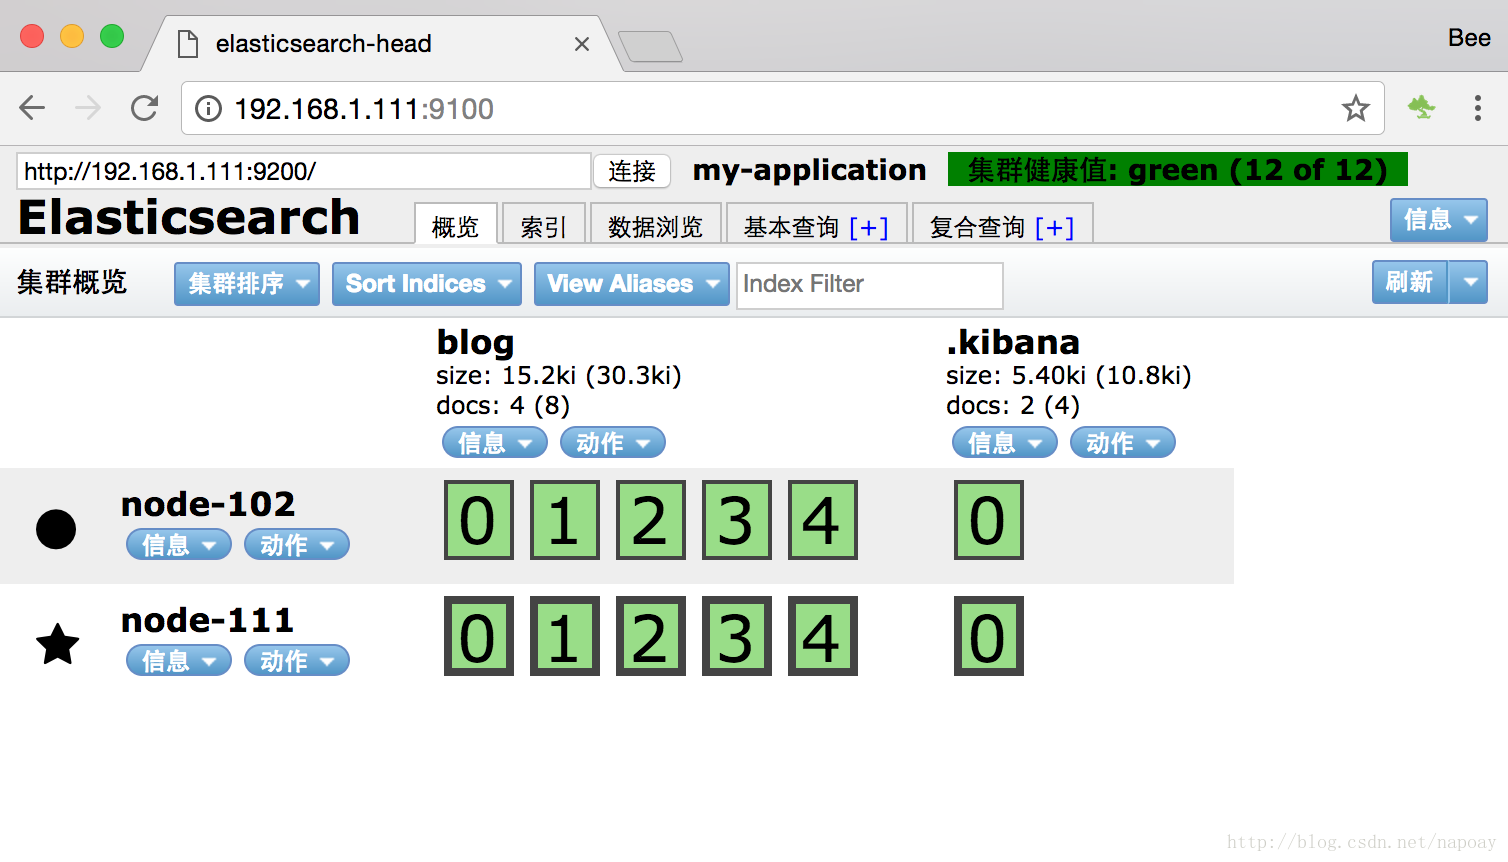
访问head,一个master一个slave组成集群,界面如下:
四、基于5.4的单机多节点集群配置
如果想要在一台机器上启动多个节点,步骤如下:
- 复制一份ELasticsearch的安装包
- 修改端口,比如一个是9200,一个是9205
- 删除data目录下的数据(如果是新解压的安装包就不必了)
搭建Elasticsearch 5.4分布式集群的更多相关文章
- 亿级Web系统搭建:单机到分布式集群
亿级Web系统搭建:单机到分布式集群 当一个Web系统从日访问量10万逐步增长到1000万,甚至超过1亿的过程中,Web系统承受的压力会越来越大,在这个过程中,我们会遇到很多的问题.为了解决这些性能压 ...
- ElasticSearch 高可用分布式集群搭建,与PHP多线程测试
方案: 使用HAproxy:当其中一台ElasticSearch Master宕掉时,ElasticSearch集群会自动将运行正常的节点提升为Master,但HAproxy不会将失败的请求重新分发到 ...
- [转]亿级Web系统搭建:单机到分布式集群
当一个Web系统从日访问量10万逐步增长到1000万,甚至超过1亿的过程中,Web系统承受的压力会越来越大,在这个过程中,我们会遇到很多的问题.为了解决这些性能压力带来问题,我们需要在Web系统架构层 ...
- 亿级Web系统搭建:单机到分布式集群【转】
当一个Web系统从日访问量10万逐步增长到1000万,甚至超过1亿的过程中,Web系统承受的压力会越来越大,在这个过程中,我们会遇到很多的问题.为了解决这些性能压力带来问题,我们需要在Web系统架构层 ...
- Ganglia环境搭建并监控Hadoop分布式集群
简介 Ganglia可以监控分布式集群中硬件资源的使用情况,例如CPU,内存,网络等资源.通过Ganglia可以监控Hadoop集群在运行过程中对集群资源的调度,作为简单地运维参考. 环境搭建流程 1 ...
- 一张图讲解最少机器搭建FastDFS高可用分布式集群安装说明
很幸运参与零售云快消平台的公有云搭建及孵化项目.零售云快消平台源于零售云家电3C平台私有项目,是与公司业务强耦合的.为了适用于全场景全品类平台,集团要求项目平台化,我们抢先并承担了此任务.并由我来主 ...
- Linux Centos7 环境搭建Docker部署Zookeeper分布式集群服务实战
Zookeeper完全分布式集群服务 准备好3台服务器: [x]A-> centos-helios:192.168.19.1 [x]B-> centos-hestia:192.168.19 ...
- elasticsearch与mongodb分布式集群环境下数据同步
1.ElasticSearch是什么 ElasticSearch 是一个基于Lucene构建的开源.分布式,RESTful搜索引擎.它的服务是为具有数据库和Web前端的应用程序提供附加的组件(即可搜索 ...
- Docker中自动化搭建Hadoop2.6完全分布式集群
这一节将在<Dockerfile完成Hadoop2.6的伪分布式搭建>的基础上搭建一个完全分布式的Hadoop集群. 1. 搭建集群中需要用到的文件 [root@centos-docker ...
随机推荐
- 剑指offer js算法练习(1-10)
1.二维数组中的查找 在一个二维数组中(每个一维数组的长度相同),每一行都按照从左到右递增的顺序排序,每一列都按照从上到下递增的顺序排序.请完成一个函数,输入这样的一个二维数组和一个整数, ...
- XSS 和 CSRF简述及预防措施
在 Web 安全领域中,XSS 和 CSRF 是最常见的攻击方式.本文将会简单介绍 XSS 和 CSRF 的攻防问题. 1. xss XSS,即 Cross Site Script,中译是跨站脚本攻击 ...
- MySQL 清除表空间碎片
碎片产生的原因 (1)表的存储会出现碎片化,每当删除了一行内容,该段空间就会变为空白.被留空,而在一段时间内的大量删除操作,会使这种留空的空间变得比存储列表内容所使用的空间更大; (2)当执行插入操作 ...
- VSCode插件整理
VSCode插件整理 VSCode插件整理 官网地址 vscode常用配置(User Settings文件) 基本插件 前端插件 VUE部分 python MarkDown部分 连接Linux 本地与 ...
- Python的scrapy之爬取妹子图片
闲来无事,做的一个小爬虫项目 爬虫主程序: import scrapy from ..items import MeiziItem class MztSpider(scrapy.Spider): na ...
- 多线程编程之Apue3rd_Chapter15.10之posix信号量
看了APUE的chapter15,只重点看了15.10,学习了posix信号量.Posix信号量比起xsi信号量的优点是性能更好,在Linux3.2.0平台上性能提升很大.其中命名信号量使用方法如下. ...
- R语言绘图:时间序列分析
ggplot2绘制 arima诊断图 library(ggfortify) autoplot(acf(gold[,2], plot = FALSE)) ggtsdiag(auto.arima(gold ...
- MOVE-PERCENTAGE(文字列の部分の代入)
以下の MOVE 命令のバリアントは.c 型項目についてのみ機能します. MOVE c1 TO c2 PERCENTAGE p [RIGHT]. 左寄せした (RIGHT オプションを指定した場合は右 ...
- Java 中编码与摘要算法
URL 编码与解码 String s = "你好,世界!"; // URL 编码 String urlEncodedString = URLEncoder.encode(s, &q ...
- Android面试收集录 Android系统的资源+其他
1.Android应用程序的资源是如何存储的,如何使用? res文件夹或者assets文件夹 res目录中的资源在R类中生成一个int变量,然后再布局文件中可以直接使用,在代码中,要getResour ...