
Spark Shell启动时遇到<console>:14: error: not found: value spark import spark.implicits._ <console>:14: error: not found: value spark import spark.sql错误的解决办法(图文详解)
不多说,直接上干货!
最近,开始,进一步学习spark的最新版本。由原来经常使用的spark-1.6.1,现在来使用spark-2.2.0-bin-hadoop2.6.tgz。
前期博客
Spark on YARN模式的安装(spark-1.6.1-bin-hadoop2.6.tgz + hadoop-2.6.0.tar.gz)(master、slave1和slave2)(博主推荐)
这里我,使用的是spark-2.2.0-bin-hadoop2.6.tgz + hadoop-2.6.0.tar.gz 的单节点来测试下。
其中,hadoop-2.6.0的单节点配置文件,我就不赘述了。
这里,我重点写下spark on yarn。我这里采取的是这模式。
spark-defaults.conf
默认,保持不修改。
spark-env.sh

export JAVA_HOME=/home/spark/app/jdk1..0_60

export SCALA_HOME=/home/spark/app/scala-2.10.

export HADOOP_HOME=/home/spark/app/hadoop-2.6.

export HADOOP_CONF_DIR=/home/spark/app/hadoop-2.6./etc/hadoop

export SPARK_MASTER_IP=192.168.80.218

export SPARK_WORKER_MERMORY=1G
slaves
sparksinglenode
问题详情
我已经是启动了hadoop进程。
然后,来执行

[spark@sparksinglenode spark-2.2.-bin-hadoop2.]$ bin/spark-shell
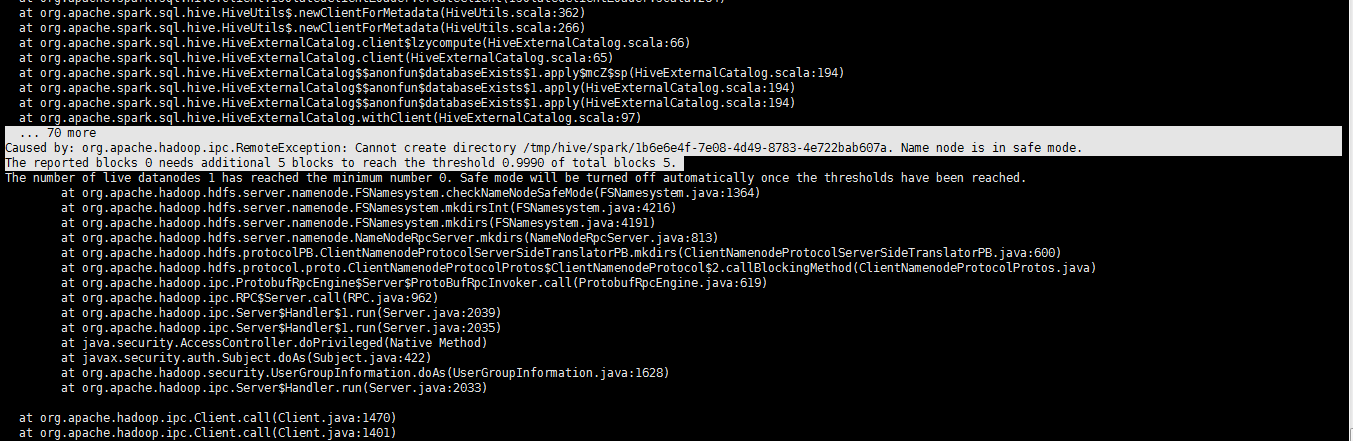
  at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:)

  at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog.client$lzycompute(HiveExternalCatalog.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog.client(HiveExternalCatalog.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog$$anonfun$databaseExists$.apply$mcZ$sp(HiveExternalCatalog.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog$$anonfun$databaseExists$.apply(HiveExternalCatalog.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog$$anonfun$databaseExists$.apply(HiveExternalCatalog.scala:)

  at org.apache.spark.sql.hive.HiveExternalCatalog.withClient(HiveExternalCatalog.scala:)

  ...  more

Caused by: org.apache.hadoop.ipc.RemoteException: Cannot create directory /tmp/hive/spark/1b6e6e4f-7e08-4d49--4e722bab607a. Name node is in safe mode.

The reported blocks  needs additional  blocks to reach the threshold 0.9990 of total blocks .

The number of live datanodes  has reached the minimum number . Safe mode will be turned off automatically once the thresholds have been reached.

    at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.checkNameNodeSafeMode(FSNamesystem.java:)

    at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirsInt(FSNamesystem.java:)

    at org.apache.hadoop.hdfs.server.namenode.FSNamesystem.mkdirs(FSNamesystem.java:)

    at org.apache.hadoop.hdfs.server.namenode.NameNodeRpcServer.mkdirs(NameNodeRpcServer.java:)

    at org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolServerSideTranslatorPB.mkdirs(ClientNamenodeProtocolServerSideTranslatorPB.java:)

    at org.apache.hadoop.hdfs.protocol.proto.ClientNamenodeProtocolProtos$ClientNamenodeProtocol$.callBlockingMethod(ClientNamenodeProtocolProtos.java)

    at org.apache.hadoop.ipc.ProtobufRpcEngine$Server$ProtoBufRpcInvoker.call(ProtobufRpcEngine.java:)

    at org.apache.hadoop.ipc.RPC$Server.call(RPC.java:)

    at org.apache.hadoop.ipc.Server$Handler$.run(Server.java:)

    at org.apache.hadoop.ipc.Server$Handler$.run(Server.java:)

    at java.security.AccessController.doPrivileged(Native Method)

    at javax.security.auth.Subject.doAs(Subject.java:)

    at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:)

    at org.apache.hadoop.ipc.Server$Handler.run(Server.java:)
  at org.apache.hadoop.hdfs.DFSClient.mkdirs(DFSClient.java:)

  at org.apache.hadoop.hdfs.DistributedFileSystem$.doCall(DistributedFileSystem.java:)

  at org.apache.hadoop.hdfs.DistributedFileSystem$.doCall(DistributedFileSystem.java:)

  at org.apache.hadoop.fs.FileSystemLinkResolver.resolve(FileSystemLinkResolver.java:)

  at org.apache.hadoop.hdfs.DistributedFileSystem.mkdirsInternal(DistributedFileSystem.java:)

  at org.apache.hadoop.hdfs.DistributedFileSystem.mkdirs(DistributedFileSystem.java:)

  at org.apache.hadoop.hive.ql.session.SessionState.createPath(SessionState.java:)

  at org.apache.hadoop.hive.ql.session.SessionState.createSessionDirs(SessionState.java:)

  at org.apache.hadoop.hive.ql.session.SessionState.start(SessionState.java:)

  ...  more

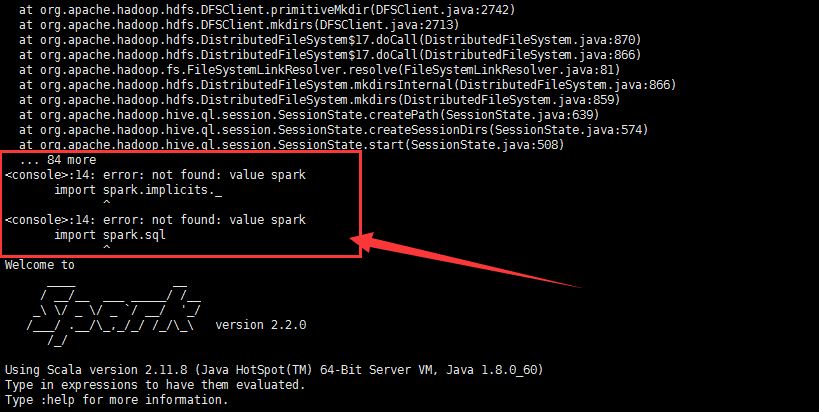
<console>:14: error: not found: value spark

       import spark.implicits._

              ^

<console>:14: error: not found: value spark

       import spark.sql

              ^

Welcome to

      ____              __

     / __/__  ___ _____/ /__

    _\ \/ _ \/ _ `/ __/  '_/

   /___/ .__/\_,_/_/ /_/\_\   version 2.2.

      /_/

Using Scala version 2.11. (Java HotSpot(TM) -Bit Server VM, Java 1.8.0_60)

Type in expressions to have them evaluated.

Type :help for more information.

scala>
解决办法

[spark@sparksinglenode ~]$ jps

 SecondaryNameNode

 Jps

 NameNode

 ResourceManager

 NodeManager

 DataNode

[spark@sparksinglenode ~]$ hdfs dfsadmin -safemode leave

// :: WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Safe mode is OFF

[spark@sparksinglenode ~]$
再次执行,成功了
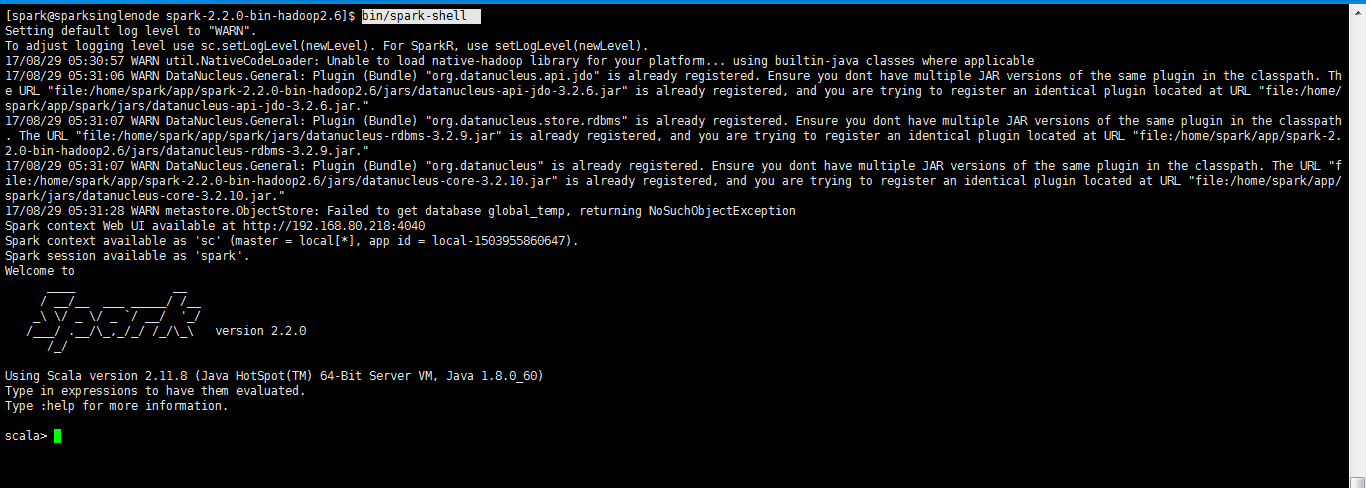
[spark@sparksinglenode spark-2.2.-bin-hadoop2.]$ bin/spark-shell

Setting default log level to "WARN".

To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).

// :: WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

// :: WARN DataNucleus.General: Plugin (Bundle) "org.datanucleus.api.jdo" is already registered. Ensure you dont have multiple JAR versions of the same plugin in the classpath. The URL "file:/home/spark/app/spark-2.2.0-bin-hadoop2.6/jars/datanucleus-api-jdo-3.2.6.jar" is already registered, and you are trying to register an identical plugin located at URL "file:/home/spark/app/spark/jars/datanucleus-api-jdo-3.2.6.jar."

// :: WARN DataNucleus.General: Plugin (Bundle) "org.datanucleus.store.rdbms" is already registered. Ensure you dont have multiple JAR versions of the same plugin in the classpath. The URL "file:/home/spark/app/spark/jars/datanucleus-rdbms-3.2.9.jar" is already registered, and you are trying to register an identical plugin located at URL "file:/home/spark/app/spark-2.2.0-bin-hadoop2.6/jars/datanucleus-rdbms-3.2.9.jar."

// :: WARN DataNucleus.General: Plugin (Bundle) "org.datanucleus" is already registered. Ensure you dont have multiple JAR versions of the same plugin in the classpath. The URL "file:/home/spark/app/spark-2.2.0-bin-hadoop2.6/jars/datanucleus-core-3.2.10.jar" is already registered, and you are trying to register an identical plugin located at URL "file:/home/spark/app/spark/jars/datanucleus-core-3.2.10.jar."

// :: WARN metastore.ObjectStore: Failed to get database global_temp, returning NoSuchObjectException

Spark context Web UI available at http://192.168.80.218:4040

Spark context available as 'sc' (master = local[*], app id = local-).

Spark session available as 'spark'.

Welcome to

      ____              __

     / __/__  ___ _____/ /__

    _\ \/ _ \/ _ `/ __/  '_/

   /___/ .__/\_,_/_/ /_/\_\   version 2.2.

      /_/

Using Scala version 2.11. (Java HotSpot(TM) -Bit Server VM, Java 1.8.0_60)

Type in expressions to have them evaluated.

Type :help for more information.

scala>
或者
[spark@sparksinglenode spark-2.2.-bin-hadoop2.]$ bin/spark-shell --master yarn-client
注意,这里的--master是固定参数
Spark Shell启动时遇到<console>:14: error: not found: value spark import spark.implicits._ <console>:14: error: not found: value spark import spark.sql错误的解决办法(图文详解)的更多相关文章
- IDEA里运行代码时出现Error:scalac: error while loading JUnit4, Scala signature JUnit4 has wrong version expected: 5.0 found: 4.1 in JUnit4.class错误的解决办法(图文详解)
不多说,直接上干货! 问题详情 当出现这类错误时是由于版本不匹配造成的 Information:// : - Compilation completed with errors and warnin ...
- 关于MyEclipse启动报错:Error starting static Resources;下面伴随Failed to start component [StandardServer[8005]]; A child container failed during start.的错误提示解决办法.
最后才发现原因是Tomcat的server.xml配置文件有问题:apache-tomcat-7.0.67\conf的service.xml下边多了类似与 <Host appBase=" ...
- PHP生成页面二维码解决办法?详解
随着科技的进步,二维码应用领域越来越广泛,今天我给大家分享下如何使用PHP生成二维码,以及如何生成中间带LOGO图像的二维码. 具体工具: phpqrcode.php内库:这个文件可以到网上下载,如果 ...
- SQL SERVER 2000安装教程图文详解
注意:Windows XP不能装企业版.win2000\win2003服务器安装企业版一.硬件和操作系统要求 下表说明安装 Microsoft SQL Server 2000 或 SQL Server ...
- SQL server 2008 r2 安装图文详解
文末有官网下载地址.百度网盘下载地址和产品序列号以及密钥,中间需要用到密钥和序列号的可以到文末找选择网盘下载的下载解压后是镜像文件,还需要解压一次直接右键点击解如图所示选项,官网下载安装包的可以跳过前 ...
- Elasticsearch集群状态健康值处于red状态问题分析与解决(图文详解)
问题详情 我的es集群,开启后,都好久了,一直报red状态??? 问题分析 有两个分片数据好像丢了. 不知道你这数据怎么丢的. 确认下本地到底还有没有,本地要是确认没了,那数据就丢了,删除索引 ...
- error: not found: value sqlContext/import sqlContext.implicits._/error: not found: value sqlContext /import sqlContext.sql/Caused by: java.net.ConnectException: Connection refused
1.今天启动启动spark的spark-shell命令的时候报下面的错误,百度了很多,也没解决问题,最后想着是不是没有启动hadoop集群的问题 ,可是之前启动spark-shell命令是不用启动ha ...
- 对于maven创建spark项目的pom.xml配置文件(图文详解)
不多说,直接上干货! http://mvnrepository.com/ 这里,怎么创建,见 Spark编程环境搭建(基于Intellij IDEA的Ultimate版本)(包含Java和Scala版 ...
- 全网最详细的启动或格式化zkfc时出现java.net.NoRouteToHostException: No route to host ... Will not attempt to authenticate using SASL (unknown error)错误的解决办法(图文详解)
不多说,直接上干货! 全网最详细的启动zkfc进程时,出现INFO zookeeper.ClientCnxn: Opening socket connection to server***/192.1 ...
随机推荐
- ftp操作方法整理
1.整理简化了下C#的ftp操作,方便使用 1.支持创建多级目录 2.批量删除 3.整个目录上传 4.整个目录删除 5.整个目录下载 2.调用方法展示, var ftp ...
- 【bzoj4872】[Shoi2017]分手是祝愿 期望dp
Description Zeit und Raum trennen dich und mich. 时空将你我分开.B 君在玩一个游戏,这个游戏由 n 个灯和 n 个开关组成,给定这 n 个灯的初始状态 ...
- uoj #298. 【CTSC2017】网络
#298. [CTSC2017]网络 一个一般的网络系统可以被描述成一张无向连通图.图上的每个节点为一个服务器,连接服务器与服务器的数据线则看作图上的一条边,边权为该数据线的长度.两个服务器之间的通讯 ...
- postgreSQL PL/SQL编程学习笔记(二)
Control Structures of PL/SQL Control structures are probably the most useful (and important) part of ...
- 【问题记录】在执行js的时候报错:missing ) after argument list
在执行个js语句时候报错: 报错语句: js('document.querySelector("[class] [tabindex='0']:nth-child(2) span") ...
- maven No compiler is provided environment
eclipse maven操作正常出现的No compiler is provided in this environment. Perhaps you are running on a JRE ra ...
- CentOS中源码编译安装Nginx
1.从官网通过wget命令将Nginx源码包下载到Linux上 Nginx下载页面:http://nginx.org/en/download.html 2.在Linux上安装需要依赖的环境 yum ...
- mysql5.6 的st_distance 实现按照距离远近排序。
当前所处在的位置(113.858202 , 22.583819 ),需要查询我附近1000米内的小区,并安装由近到远的顺序排列 SELECT s.id,s.name,s.lng,s.lat, rou ...
- C++_新特性2-RTTI运行阶段类型识别
这部分属于C++的新特性,感觉比较高阶的特性.我把它归于属于奇技淫巧的范畴.了解即可. RTTI是运行阶段类型识别(Runtime Type Identification)的简称. 这是添加到C++中 ...
- LeetCode215. 数组中的第K个最大元素
215. 数组中的第K个最大元素 问题描述 在未排序的数组中找到第 k 个最大的元素.请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素. 示例 示例 1: 输入: [3 ...