
机器学习:集成学习(集成学习思想、scikit-learn 中的集成分类器)
一、集成学习的思想
- 集成学习的思路:一个问题(如分类问题),让多种算法参与预测(如下图中的算法都可以解决分类问题),在多个预测结果中,选择出现最多的预测类别做为该样本的最终预测类别;
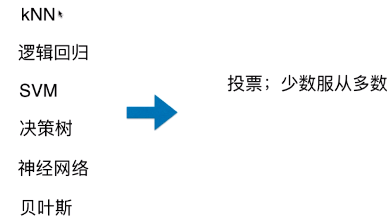
- 生活中的集成思维:
- 选择电影:10 个人中,如果有8个人觉得这个电影值得看,那么很多人就会跟进这个现象选择看这部电影;
二、scikit-learn 中的集成分类器
- scikit-learn 中封装的集成分类器:VotingClassifier
1)模拟集成学习操作
模拟数据集
import numpy as np

import matplotlib.pyplot as plt

from sklearn import datasets

# n_samples=500:表示生成 500 个样本;默认自动生成 100 个样本;

X, y = datasets.make_moons(n_samples=500, noise=0.3, random_state=42)

from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)
- datasets.make_moons(n_samples=500):表示生成 500 个样本;默认自动生成 100 个样本;
使用逻辑回归算法分类器
from sklearn.linear_model import LogisticRegression

log_clf = LogisticRegression()

log_clf.fit(X_train, y_train)

log_clf.score(X_test, y_test)

# 准确率:0.864
使用 SVM 算法分类器
from sklearn.svm import SVC

svm_clf = SVC()

svm_clf.fit(X_train, y_train)

svm_clf.score(X_test, y_test)

# 准确率:0.888
使用决策树算法分类器
from sklearn.tree import DecisionTreeClassifier

dt_clf = DecisionTreeClassifier()

dt_clf.fit(X_train, y_train)

dt_clf.score(X_test, y_test)

# 准确率:0.84- 对各个算法预测结果投票
y_predict1 = log_clf.predict(X_test)

y_predict2 = svm_clf.predict(X_test)

y_predict3 = dt_clf.predict(X_test)

y_predict = np.array((y_predict1 + y_predict2 + y_predict3) >= 2, dtype='int')
- 投票方式:
- (y_predict1 + y_predict2 + y_predict3) >= 2
- 三种算法的预测结果中,只有当 2 个或 3 个的预测结果为 1 时,最终的预测结果才为 1;
- 查看投票结果的准确率
from sklearn.metrics import accuracy_score

accuracy_score(y_test, y_predict)

# 准确率:0.896 - 采用集成学习思路得到的准确率比其它 3 中算法得到的准确率高;
二、scikit-learn 中的集成分类器
1)代码
from sklearn.ensemble import VotingClassifier

# 集成分类器 VotingClassifier 的参数:

    # 1)estimators=[]:传入需要使用的算法,放在列表中,使用方式类似管道 Pipeline;

    # 2)voting='hard':表示选择最终预测结果的方式,以出现最多的分类结果作为最终的预测结果;

# 正常情况下,需要对所选择的算法进行调参;

voting_clf = VotingClassifier(estimators=[

    ('log_clf', LogisticRegression()),

    ('svm_clf', SVC()),

    ('dt_clf', DecisionTreeClassifier())

], voting='hard')


voting_clf.fit(X_train, y_train)

voting_clf.score(X_test, y_test)

# 准确率:0.896- 注意
- 使用方式如以上红色代码;
- 参数 estimators=[ ]:传入需要使用的算法,放在列表中,使用方式类似管道 Pipeline;
- 参数 voting='hard':表示选择最终预测结果的方式,以出现最多的分类结果作为最终的预测结果;
- 正常情况下,需要对所选择的算法进行调参;
机器学习:集成学习(集成学习思想、scikit-learn 中的集成分类器)的更多相关文章
- (原创)(三)机器学习笔记之Scikit Learn的线性回归模型初探
一.Scikit Learn中使用estimator三部曲 1. 构造estimator 2. 训练模型:fit 3. 利用模型进行预测:predict 二.模型评价 模型训练好后,度量模型拟合效果的 ...
- (原创)(四)机器学习笔记之Scikit Learn的Logistic回归初探
目录 5.3 使用LogisticRegressionCV进行正则化的 Logistic Regression 参数调优 一.Scikit Learn中有关logistics回归函数的介绍 1. 交叉 ...
- sklearn中调用集成学习算法
1.集成学习是指对于同一个基础数据集使用不同的机器学习算法进行训练,最后结合不同的算法给出的意见进行决策,这个方法兼顾了许多算法的"意见",比较全面,因此在机器学习领域也使用地非常 ...
- webService学习之路(三):springMVC集成CXF后调用已知的wsdl接口
webService学习之路一:讲解了通过传统方式怎么发布及调用webservice webService学习之路二:讲解了SpringMVC和CXF的集成及快速发布webservice 本篇文章将讲 ...
- Quartz学习——SSMM(Spring+SpringMVC+Mybatis+Mysql)和Quartz集成详解(转)
通过前面的学习,你可能大致了解了Quartz,本篇博文为你打开学习SSMM+Quartz的旅程!欢迎上车,开始美好的旅程! 本篇是在SSM框架基础上进行的. 参考文章: 1.Quartz学习——Qua ...
- 机器学习(Machine Learning)&深度学习(Deep Learning)资料【转】
转自:机器学习(Machine Learning)&深度学习(Deep Learning)资料 <Brief History of Machine Learning> 介绍:这是一 ...
- 机器学习(Machine Learning)&深度学习(Deep Learning)资料汇总 (上)
转载:http://dataunion.org/8463.html?utm_source=tuicool&utm_medium=referral <Brief History of Ma ...
- Scikit Learn: 在python中机器学习
转自:http://my.oschina.net/u/175377/blog/84420#OSC_h2_23 Scikit Learn: 在python中机器学习 Warning 警告:有些没能理解的 ...
- 视觉机器学习读书笔记--------BP学习
反向传播算法(Back-Propagtion Algorithm)即BP学习属于监督式学习算法,是非常重要的一种人工神经网络学习方法,常被用来训练前馈型多层感知器神经网络. 一.BP学习原理 1.前馈 ...
随机推荐
- 微信内置浏览器和小程序的 User Agent 区别及判断方法
通过UA来判断不同的设备或者浏览器是开发者最常用的方式方法,而对于微信开发和小程序也是同样的一个情况,我们可以通过微信内置浏览器 User Agent 信息来判断其具体类型或者设备. 所以子凡就通过徒 ...
- MYSQL数据库字段命名及设计规范
1.设计原则 1) 标准化和规范化数据的标准化有助于消除数据库中的数据冗余.标准化有好几种形式,但 Third Normal Form(3NF)通常被认为在性能.扩展性和数据完整性方面达到了最好平衡. ...
- 多校hdu-5775 Bubble sort(线段树)
题意根据题目中给的冒泡排序写出每个元素交换过程中该元素位置左右最大差距: 分析:因为题目中冒泡程序从后向前遍历的,假设第i个元素左边有k个比i小的数,那么i必定会向右移动k位,我们用k1记住i+k,用 ...
- hadoop mapreduce实现数据去重
实现原理分析: map函数数将输入的文本按照行读取, 并将Key--每一行的内容 输出 value--空. reduce 会自动统计所有的key,我们让reduce输出key-> ...
- Oracle通过PLSQL进行数据表之间的同步
昨天被要求拉取第三方oracle中的一个表数据,起初以为要导出表数据,然后再自己库中建个相同的表,然后导入数据,查过资料之后oracle可以通过dblink的方式同步表数据. 1.首先利用PLSQL工 ...
- SPFA算法O(kE)
SPFA算法O(kE) Dijkstra和Floyed是不断的试点.Dijkstra试最优点,Floyed试所有点. Bellman-Ford和SPFA是不断的试边.Bellman-Ford是盲目的试 ...
- open inventor 学习笔记
初次接触open inventor,跟以前学习一种新的东西,都想要先做出个小的helloworld程序,这个当然也不例外. 首先会创建一个窗口句柄,初始化一下场景数据库. HWND window = ...
- python中sort()方法的cmp参数
<python基础编程>里有讲到一段高级排序: “如果希望元素能按照特定的方式进行排序(而不是sort函数默认的方式,即根据python的默认排序规则按升序排列元素,第5章内对此进行讲解) ...
- hdu 5242 Game(树链剖分,贪心¥)
Game Time Limit: 3000/1500 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)Total Submis ...
- Git之(一)Git是什么[转]
为什么使用Git 孔子曾经曰过的,名正则言顺 言顺则事成. 我们在学习一项新技术之前,弄清楚为什么要学它至关重要,至于为什么要学习Git,我用一段if-else语句告诉你原因: if(你相信我){ 我 ...