
spark实验(四)--RDD编程(1)
一、实验目的
(1)熟悉 Spark 的 RDD 基本操作及键值对操作;
(2)熟悉使用 RDD 编程解决实际具体问题的方法。
二、实验平台
操作系统:centos6.4
Spark 版本:1.5.0
三、实验内容
实验一:
1.spark-shell 交互式编程
请到本教程官网的“下载专区”的“数据集”中下载 chapter5-data1.txt,该数据集包含 了某大学计算机系的成绩,数据格式如下所示:
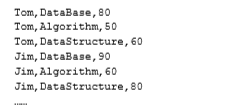
首先开始我们的第一步,打开linux系统中的终端。
请根据给定的实验数据,在 spark-shell 中通过编程来计算以下内容:
将Data01.txt文件放置在usr/local/sparkdata/中
新建/usr/local/sparkdata文件夹
mkdir /usr/local/sparkdata
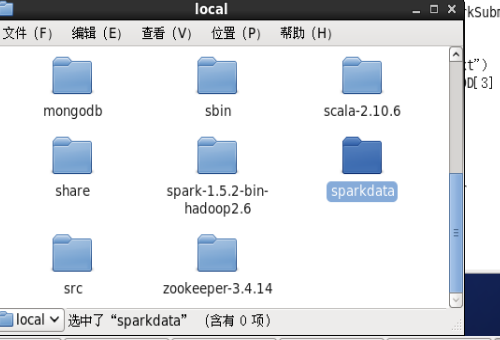
将Data01.txt文件放置在sparkdata中
发现权限不够,给/usr/local/sparkdata赋予操作权限
chmod 777 /usr/local/spakrdata
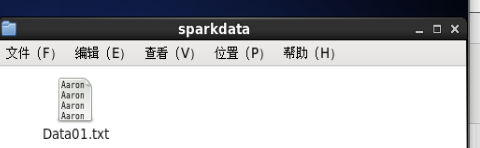
之后将Data01.txt文件移动到sparkdata中
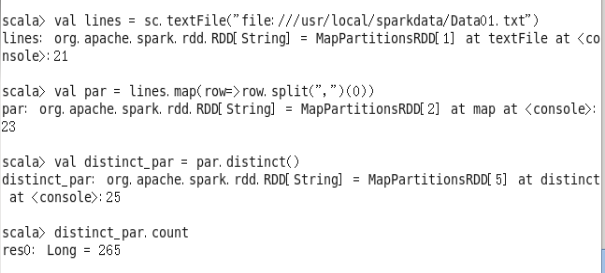
(1)该系总共有多少学生;
val lines = sc.textFile("file:///usr/local/sparkdata/Data01.txt")

val par = lines.map(row=>row.split(",")(0))

val distinct_par = par.distinct()

distinct_par.count
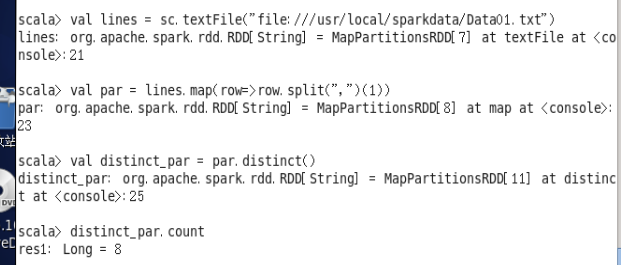
(2)该系共开设来多少门课程;
val lines = sc.textFile("file:///usr/local/sparkdata/Data01.txt")

val par = lines.map(row=>row.split(",")(1))

val distinct_par = par.distinct()

distinct_par.count
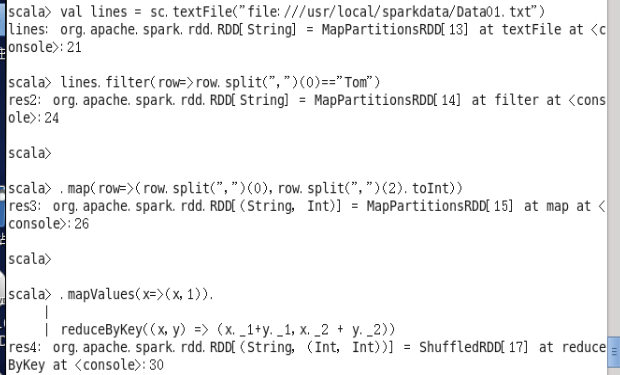
(3)Tom 同学的总成绩平均分是多少;
val lines = sc.textFile("file:///usr/local/sparkdata/Data01.txt")
lines.filter(row=>row.split(",")(0)=="Tom")
.map(row=>(row.split(",")(0),row.split(",")(2).toInt))
.mapValues(x=>(x,1)).
reduceByKey((x,y) => (x._1+y._1,x._2 + y._2))
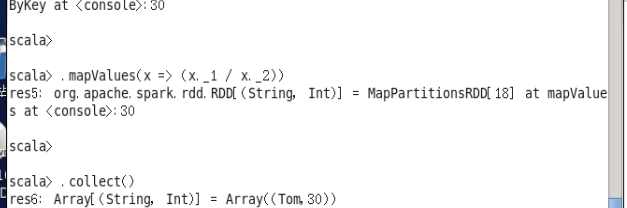
.mapValues(x => (x._1 / x._2))
.collect()
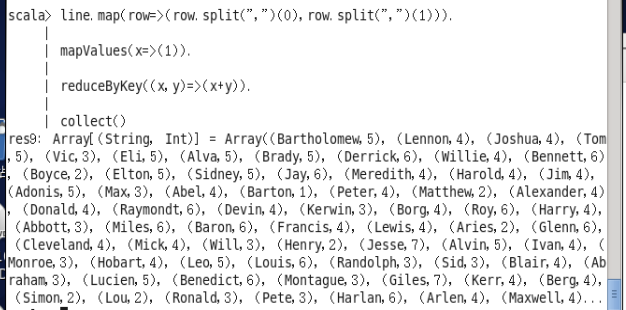
(4)求每名同学的选修的课程门数;
val line=sc.textFile("file:///usr/local/sparkdata/Data01.txt")
line.map(row=>(row.split(",")(0),row.split(",")(1))).
mapValues(x=>(1)).
reduceByKey((x,y)=>(x+y)).
collect()
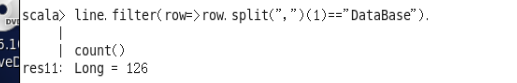
(5)该系 DataBase 课程共有多少人选修;
val line=sc.textFile("file:///usr/local/sparkdata/Data01.txt")
line.filter(row=>row.split(",")(1)=="DataBase").
count()
(6)各门课程的平均分是多少;
val line=sc.textFile("file:///usr/local/sparkdata/Data01.txt")
line.map(row=>(row.split(",")(1),row.split(",")(2).toInt)).
mapValues(x=>(x,1)).
reduceByKey((x,y)=>(x._1+y._1,x._2+y._2)).
mapValues(x=>(x._1/x._2)).
collect()

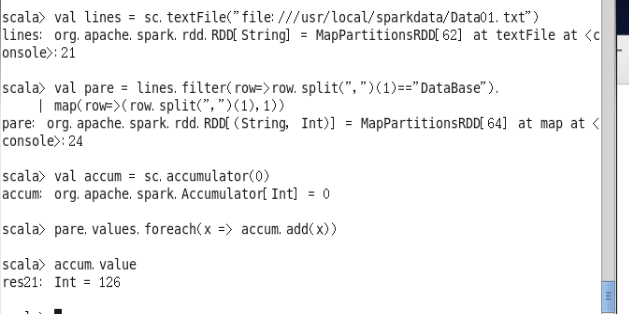
(7)使用累加器计算共有多少人选了 DataBase 这门课。
val lines = sc.textFile("file:///usr/local/sparkdata/Data01.txt")
val pare = lines.filter(row=>row.split(",")(1)=="DataBase").
map(row=>(row.split(",")(1),1))
val accum =sc.accumulator(0)
pare.values.foreach(x => accum.add(x))
accum.value
实验二
2.编写独立应用程序实现数据去重
对于两个输入文件 A 和 B,编写 Spark 独立应用程序,对两个文件进行合并,并剔除其 中重复的内容,得到一个新文件 C。下面是输入文件和输出文件的一个样例,供参考。 输入文件 A 的样例如下:
20170101 x
20170102 y
20170103 x
20170104 y
20170105 z
20170106 z
输入文件 B 的样例如下:
20170101 y
20170102 y
20170103 x
20170104 z
20170105 y
根据输入的文件 A 和 B 合并得到的输出文件 C 的样例如下:
20170101 x
20170101 y
20170102 y
20170103 x
20170104 y
20170104 z
20170105 y
20170105 z
20170106 z
package sn

import org.apache.spark.SparkContext

import org.apache.spark.SparkContext._

import org.apache.spark.SparkConf

import org.apache.spark.HashPartitioner

object RemDup

{

    def main(args:Array[String])

    {

        val conf = new SparkConf().setAppName("RemDup")

        val sc = new SparkContext(conf)

        val dataFile = "file:///usr/local/sparkdata/data42"

        val data = sc.textFile(dataFile,)

        val res = data.filter(_.trim().length>).map(line=>(line.trim,"")).partitionBy(new HashPartitioner()).groupByKey().sortByKey().keys

        res.saveAsTextFile("result")

    }

}
实验三
3.编写独立应用程序实现求平均值问题
每个输入文件表示班级学生某个学科的成绩,每行内容由两个字段组成,第一个是学生 名字,第二个是学生的成绩;编写 Spark 独立应用程序求出所有学生的平均成绩,并输出到 一个新文件中。下面是输入文件和输出文件的一个样例,供参考。
Algorithm 成绩:
小明 92
小红 87
小新 82
小丽 90
Database 成绩:
小明 95
小红 81
小新 89
小丽 85
Python 成绩:
小明 82
小红 83
小新 94
小丽 91
平均成绩如下:
(小红,83.67)
(小新,88.33)
(小明,89.67)
(小丽,88.67)
import org.apache.spark.SparkContext

import org.apache.spark.SparkContext._

import org.apache.spark.SparkConf

import org.apache.spark.HashPartitioner

object AvgScore

{

    def main(args:Array[String])

    {

        val conf = new SparkConf().setAppName("AvgScore")

        val sc = new SparkContext(conf)

        val dataFile = "file:///usr/local/spark/mycode/avgscore/data"

        val data = sc.textFile(dataFile,3)

        val res=data.filter(_.trim().length>0).map(line=>(line.split(" ")(0).trim(),line.split(" ")(1).trim().toInt)).partitionBy(new HashPartitioner(1)).groupByKey().map(x=>{

        var n=0

        var sum=0.0

        for(i<-x._2){

            sum=sum+i

            n=n+1

        }

        val avg=sum/n

        val format=f"$avg%1.2f".toDouble

        (x._1,format)

        })

        res.saveAsTextFile("result2")

    }

}
spark实验(四)--RDD编程(1)的更多相关文章
- 02、体验Spark shell下RDD编程
02.体验Spark shell下RDD编程 1.Spark RDD介绍 RDD是Resilient Distributed Dataset,中文翻译是弹性分布式数据集.该类是Spark是核心类成员之 ...
- Spark学习之RDD编程(2)
Spark学习之RDD编程(2) 1. Spark中的RDD是一个不可变的分布式对象集合. 2. 在Spark中数据的操作不外乎创建RDD.转化已有的RDD以及调用RDD操作进行求值. 3. 创建RD ...
- Spark学习之RDD编程总结
Spark 对数据的核心抽象——弹性分布式数据集(Resilient Distributed Dataset,简称 RDD).RDD 其实就是分布式的元素集合.在 Spark 中,对数据的所有操作不外 ...
- spark 中的RDD编程 -以下基于Java api
1.RDD介绍: RDD,弹性分布式数据集,即分布式的元素集合.在spark中,对所有数据的操作不外乎是创建RDD.转化已有的RDD以及调用RDD操作进行求值.在这一切的背后,Spark会自动 ...
- Spark学习笔记——RDD编程
1.RDD——弹性分布式数据集(Resilient Distributed Dataset) RDD是一个分布式的元素集合,在Spark中,对数据的操作就是创建RDD.转换已有的RDD和调用RDD操作 ...
- 实验4 RDD编程初级实践
1.spark-shell交互式编程 (1) 该系总共有多少学生 scala> val lines = sc.textFile("file:///usr/local/spark/spa ...
- Spark学习(2) RDD编程
什么是RDD RDD(Resilient Distributed Dataset)叫做分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变.可分区.弹性.里面的元素可并行计算的集合 RDD允 ...
- 假期学习【四】RDD编程实验一
1.今天把Spark编程第三个实验的Scala独立程序编程写完了.使用 sbt 打包 Scala 程序,然后提交到Spark运行. 2.完成了实验四的第一项 (1)该系总共有多少学生: map(t ...
- 假期学习【五】RDD编程实验四
今天完成了实验四的第二问和第三问 第二题 对于两个输入文件 A 和 B,编写 Spark 独立应用程序,对两个文件进行合并,并剔除其 中重复的内容,得到一个新文件 C.下面是输入文件和输出文件的一个样 ...
随机推荐
- util之Queue
定义:ArrayDeque<Integer> queue = new ArrayDeque<Integer>(); offer();添加元素 Peek()返回队列首部元素值 P ...
- FLAG-回归C++,JAVA什么的等学校教吧
以后刷OJ还是写C++,昂啊! 除非我觉得JAVA更好用
- intellij idea设置打开多个文件显示在多行tab上
- Java“被迫”退出争霸,Python继续霸占首位!老牌程序员:我不服
2019年转眼已经接近尾声,如果盘点下2019年最火的语言,除了Python还能有谁?你心中的王者语言又是谁? 这一年Python风光无限 这一年JAVA走向右边 这一年,我们都很感慨,你呢? 关于P ...
- 移动端 输入框 input 被弹出来的键盘 挡住
给被挡住的input或者textarea加一个id,然后在click事件里调用下面的代码 document.querySelector('#xxx').scrollIntoView();
- Flutter 中的常见的按钮组件 以及自 定义按钮组件
一.Flutter 中的按钮组件介绍 Flutter 里有很多的 Button 组件很多,常见的按钮组件有:RaisedButton.FlatButton. IconButton.Outlin ...
- Bootstrap环境安装加使用---开启Bootstrap 之旅
1.首先去Bootstrap官网https://getbootstrap.com/上下载Bootstrap 的最新版本 对应的中文页面如下: 下载自己所需要的版本(目前我自己下载的是编译的css和js ...
- Java - Test - TestNG: testng.xml 元素 class
Java - Test - TestNG: testng.xml 元素 class 1. 概述 class 相关的元素 classes class methods exclude include 2. ...
- JDBC 基础用法学习
JDBC概述 java 数据库链接,sun公司退出的 java 访问数据库的标准规范接口 是一种用于执行SQL语句的 java API 可以作为多种关系数据库提供统一接口 是一组 java 工具类和接 ...
- 在一个C程序中,main()函数可以放在哪?
C语言规定,在一个C程序中,main()函数的位置(). A.必须在系统调用的库函数之后 B.必须在程序的开始 C.必须在程序的最后 D.可以在任意位置 答案:D [解析] 每个C程序有且只有一个主函 ...