
MySQL系列(六)--索引优化
在进行数据库查询的时候,索引是非常重要的,当然前提是达到一定的数据量。索引就像字典一样,通过偏旁部首来快速定位,而不是一页页
的慢慢找。
索引依赖存储引擎层实现,所以支持的索引类型和存储引擎相关,同一种索引底层实现在不同存储引擎也是不一样的
本文基于MySQL8.0版本,关于explain用法,可以参考:MySQL高级 之 explain执行计划详解
创建索引语法:
CREATE TABLE table_name[col_name data_type]
[UNIQUE|FULLTEXT|SPATIAL]
[INDEX|KEY]
[index_name](col_name[length])
[ASC|DESC]
参数:
1、UNIQUE、FULLTEXT和SPATIAL为可选参数,分别表示唯一索引、全文索引和空间索引
2、INDEX和KEY为同义词,二者作用相同,用来指定创建索引
3、col_name为需要创建索引的字段列,该列必须从数据表中该定义的多个列中选择
4、index_name为指定索引的名称,为可选参数,如果不指定则MySQL默认col_name为索引
5、length为可选参数,表示索引的长度,只有字符串类型的字段才能指定索引长度,如果数据列很长的话,MySQL不允许把整列作为索引
6、ASC或DESC指定升序或者降序的索引值存储
主键:主键索引是特殊的唯一索引,不能为null,建表时指定主键,只能有一个。
唯一索引:索引列的值必须唯一,包含联合索引,允许为null。
一般索引:最普通的索引,没有限制,相对于前两种效率最差。
全文索引:用于全文搜索,V5.7版本之后,MyIsam和InnoDB支持,只能用于char、varchar、Text列
除了建表时创建索引,还有两种方式:
1、Alter TABLE table_name ADD PRIMARY KEY (column_name)/UNIQUE [indexName] (column_name)/INDEX index_name (column_name)/FULLTEXT (column_name)
2、CREATE UNIQUE INDEX index_name/INDEX index_name ON table_name (column_name) 不适用于primary key和FULLTEXT
索引分类:
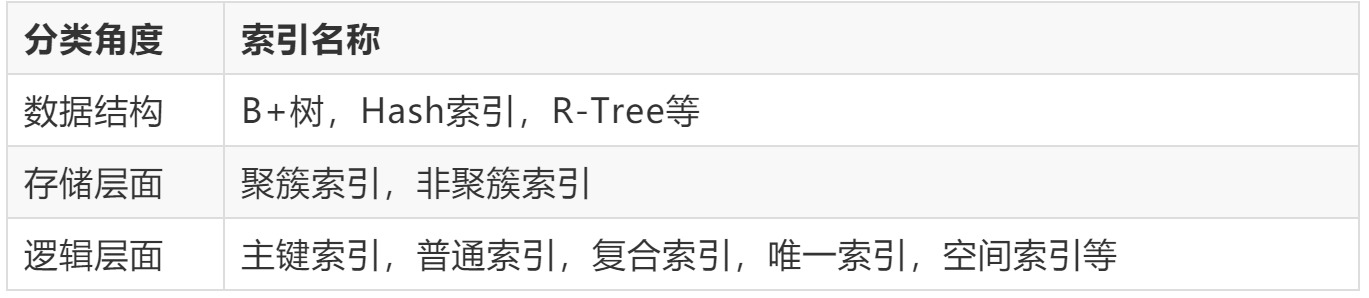
1、B-tree索引:除了archive以外的存储引擎,都支持
使用B+树的数据结构实现来存储数据,能够加快数据的查询速度,从索引的根节点开始往下搜索
B-tree索引的数据是顺序存储的,所以适合范围查找
使用场景:
1、全值匹配的查询,例如:id='1001'
2、匹配最左前缀的查询,例如现在把id和name建立一个联合索引,这时候查询id='1001'可以使用到联合索引,因为id为这个索引最左字段,
但是如果通过name进行筛选,就无法用到联合索引
3、匹配列前缀查询,例如:id like '100%'也可以用到联合索引
4、匹配范围值的查询,例如id < '1001' and id > '1010'
5、精确匹配左前列并范围匹配另一列
6、值访问索引的查询(覆盖索引)
总结:对于联合索引,MySQL从左向右匹配知道遇到范围查询(>,<,between,like)就会停止匹配,后面的列就无法用索引
个人使用MySQL8.0版本,测试发现范围匹配照样可以使用索引
使用限制:
1、不使用索引最左列的查询,无法使用到联合索引
2、使用索引时不能跳过索引中的列
3、not in和<>无法使用索引
4、索引中有某个列使用了范围查找,则右边的所有列都无法使用索引
PS:不仅可以在where查询中使用,也可以使用在order by和group by中
2、Hash索引:
Memory存储引擎默认的索引,InnoDB也有Hash索引,这是InnoDB自动建立
Hash索引是基于Hash表实现的,对于Hash索引中所有列,存储引擎为每一列计算一个hash值,hash索引存储的就是hash码
理论上,效率还是好于B树索引,但是其使用限制太多了
使用限制:
通过hash索引找到对应的行,然后对行的数据进行读取,进行两次查找
无法用于避免数据的排序操作
无法使用部分索引键的查询
只有查询条件精确匹配Hash索引的所有列,才能使用Hash索引,不能是范围匹配和模糊匹配
可能产生hash冲突,不适合选择性很差的列,例如性别。
选择性:不重复的索引值和表的记录数的比值
比值越高索引的效率越好,因为选择性高的索引可以在查找时过滤掉更多的行,唯一索引的值是1,这是性能最好的
Innodb也有一个特殊的自适应哈希索引(adaptive hash index)
3、创建自定义哈希索引:
在B-Tree索引的基础上创建伪哈希索引,使用B-Tree进行查找,但是 不是使用键本身而是hash值进行查找,只需要在where条件中手动指定
hash函数,记住不要使用SHA1()/MD5()
4、空间数据索引(R-Tree):
MyISAM支持,用于存储地理数据GPS数据,V5.7之后,InnoDB也支持了。
5、全文索引:
它是查找文本中的关键词,而不是直接比较索引中的值,全文索引和其它索引的匹配方式完全不同,不适用于where条件操作
6、聚簇索引:不是一种单独的索引类型,而不是一种数据存储方式
数据行存储在索引的叶子页,"聚簇"表示数据行和相邻的键值存储在一起,因为无法把数据行存放在两个地方,所以一个表只能有一个聚簇索引
对于Innodb的聚簇索引,Innodb通过主键聚集数据,如果没有定义主键,Innodb会选择一个唯一的非空索引代替,节点页只包含了索引页,叶子
页包含了全部数据,索引列包含了整数值
对于Innodb来说,主键使用AUTO_INCREATMENT比UUID要好,因为Innodb更适合按照主键顺序插入数据,高并发之下,自增长可能导致锁竞争
,可以重新设计表,或者使用innodb_autoinc_lock_mode参数配置,如果MySQL版本不支持,可以进行升级
索引的优点:
大大减少存储引擎要扫描的数据量
索引可以帮助我们进行排序以避免使用临时表,B-tree索引不需要进行数据排序
索引可以把随机I/O变成顺序I/O
索引带来的消耗:
增加写操作的成本,在对数据数据进行修改的时候,需要更新索引,所以索引越多,写入的越慢。所以,InnoDB有一层插入缓存,将多次写入
合并为一次写入
增加查询优化器的选择时间,同一个查询如果有很多索引可以选择,会导致查询优化器选择的时间变长
无法使用的场景:
内存无法使用,只有使用键值的索引才能使用
查询使用太多列的查询,如果索引中的数据太大了,也没啥使用必要
使用%%的like查询
PS:过多的索引对写、读的效率都是有影响的
索引优化:
1、索引列不能使用表达式或函数
例如:
where id +1 = 5;
SELECT * FROM temp WHERE TO_DAYS(date1)-TO_DAYS(current_date) > 30
优化:
where date1 > date_add(current_date,interval 30 day)
2、前缀索引和索引列的选择性
create index index_name on table(col_name(n))
索引很长的字符列(很长的varchar、text、blob),必须使用前缀索引(MyISAM 727字节,Innodb 1000字节),因为MySQL不允许索引这些
列的完整长度,使用前面所说的伪哈希索引是不行的,通常是索引开始的部分字符,可以节省索引空间,提高索引效率,但是会降低索引的选择性
所以需要在前缀索引的大小和选择性之间找到平衡
3、联合索引:很多列都建立索引不如建立联合索引
在多个单独列建立独立索引大多数情况不能提高MySQL查询性能,因为需要更多地内存和磁盘IO
1、当服务器对多个索引做相交操作(多个and)的时候,通常需要一个包含多个列的多列索引,而不是多个独立的单独索引
2、多个or(联合操作),会消耗大量CPU和内存资源在算法的缓存、排序和合并操作上,这种情况下,还可能有查询的并发性,还不如没有
索引,使用union
3、如果在explain中看到索引合并,就要检查一下查询和表结构。可以通过optimizer_switch来关闭索引合并功能,也可以使用ignore index
来让优化器忽略掉某些索引
如何选择索引列的顺序:在不考虑排序和分组的情况下
1、经常使用的列放在最左边,因为索引列是按照从左到右去使用的
2、选择性高的列优先
3、宽度小,意味着每一页的数据更多,磁盘IO消耗更少
4、覆盖索引:
如果一个索引包含、覆盖所需要查询的列的值,就称为"覆盖索引"
优点:
可以优化缓存,减少磁盘IO操作
因为B-tree索引可以减少随机IO,变随机IO访问为顺序IO操作,有利于数据的查询速度
避免InnoDB索引的二次查询,这点和Hash索引不同
避免MyISAM表进行系统调用,因为MySQL只是缓存索引的信息,数据要依赖操作系统缓存,所以访问数据的时候,需要进行一次系统调用,而
系统调用的性能通常不好
覆盖索引的限制:
存在存储引擎不支持覆盖索引,Memory
hash、全文、空间索引都不能做覆盖索引,只能使用B-Tree索引做覆盖索引
查询中使用太多的列,只有索引的大小远远小于数据本身才能发挥索引的作用
使用了like '%****%'这种双百分号的查询,因为存储引擎底层的API限制的,只能提取数据行的值并加载内存中,然后在内存中进行where过滤
例如:
CREATE TABLE `house_detail` (

  `id` bigint(11) NOT NULL AUTO_INCREMENT,

  `description` varchar(255) DEFAULT NULL COMMENT '详细描述',

  `layout_desc` varchar(255) DEFAULT NULL COMMENT '户型介绍',

  `traffic` varchar(255) DEFAULT NULL COMMENT '交通出行',

  `round_service` varchar(255) DEFAULT NULL COMMENT '周边配套',

  `rent_way` int(2) NOT NULL COMMENT '租赁方式',

  `address` varchar(32) NOT NULL COMMENT '详细地址 ',

  `subway_line_id` bigint(11) DEFAULT NULL,

  `subway_line_name` varchar(32) DEFAULT NULL COMMENT '附近地铁线名称',

  `subway_station_id` bigint(11) DEFAULT NULL,

  `subway_station_name` varchar(32) DEFAULT NULL COMMENT '地铁站名',

  `house_id` bigint(11) DEFAULT NULL,

  PRIMARY KEY (`id`),

  UNIQUE KEY `index_on_house_id` (`house_id`) USING BTREE

) ENGINE=InnoDB AUTO_INCREMENT=39 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
查询如下:EXPLAIN SELECT house_id FROM house_detail WHERE house_id = 15;

可以在Extra中看到Using index,还有使用的索引名称
如果是EXPLAIN SELECT house_id FROM house_detail WHERE house_id LIKE '%1%';

我们看到Using where和Using index
PS:版本越高可能存在更多的内部优化
使用索引来优化查询:
1、使用索引扫描来优化排序
MySQL实现排序的方式:通过排序操作/按照索引顺序扫描数据
索引优化排序的要求:
1).索引的列顺序与order by子句的顺序一致
2).索引列的方向(升序、降序)和order by子句完全一致
3).多个表的关联查询中,order by中的字段全部在关联表的第一张表中
栗子一:
CREATE TABLE `rental` (

  `rental_id` int(11) NOT NULL AUTO_INCREMENT,

  `rental_date` datetime NOT NULL,

  `inventory_id` mediumint(8) unsigned NOT NULL,

  `customer_id` smallint(5) unsigned NOT NULL,

  `return_date` datetime DEFAULT NULL,

  `staff_id` tinyint(3) unsigned NOT NULL,

  `last_update` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,

  PRIMARY KEY (`rental_id`),

  UNIQUE KEY `rental_date` (`rental_date`,`inventory_id`,`customer_id`),

  KEY `idx_fk_inventory_id` (`inventory_id`),

  KEY `idx_fk_customer_id` (`customer_id`),

  KEY `idx_fk_staff_id` (`staff_id`)

) ENGINE=InnoDB AUTO_INCREMENT=39 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
EXPLAIN SELECT * FROM rental WHERE rental_date > '2005-01-01' ORDER BY rental_id;

栗子二:
EXPLAIN SELECT * FROM rental WHERE rental_date = '2005-01-01' ORDER BY inventory_id, customer_id;
EXPLAIN SELECT * FROM rental WHERE rental_date = '2005-01-01' ORDER BY inventory_id DESC, customer_id;


我们看到Using filesort,证明了第二条要求
栗子三:
EXPLAIN SELECT * FROM rental WHERE rental_date > '2005-01-01' ORDER BY inventory_id DESC, customer_id;

证明了:联合索引前面的列使用了范围查找,后面的列不能使用索引,所以使用的是filesort
2、使用hash索引来优化查询
前面有简单提过自定义Hash索引,B-tree索引的长度是有限制的,在列的长度过大的时候,只能使用前缀索引,但是会造成选择性变差,所以
在B-tree索引上建立Hash索引是一个解决方案
CREATE TABLE `rental` (

  `rental_id` int(11) NOT NULL AUTO_INCREMENT,

  `rental_date` datetime NOT NULL,

  `inventory_id` mediumint(8) unsigned NOT NULL,

  `customer_id` smallint(5) unsigned NOT NULL,

  `return_date` datetime DEFAULT NULL,

  `staff_id` tinyint(3) unsigned NOT NULL,

  `last_update` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,

  `description` varchar(255) NOT NULL,

  `description_md5` varchar(32) DEFAULT NULL,

  PRIMARY KEY (`rental_id`),

  UNIQUE KEY `rental_date` (`rental_date`,`inventory_id`,`customer_id`),

  KEY `idx_fk_inventory_id` (`inventory_id`),

  KEY `idx_fk_customer_id` (`customer_id`),

  KEY `idx_fk_staff_id` (`staff_id`),

  KEY `idx_md5` (`description_md5`),

  KEY `idx_description` (`description`)

) ENGINE=InnoDB AUTO_INCREMENT=39 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci
EXPLAIN SELECT * FROM rental WHERE description_md5 = md5('this is food') AND description = 'this is food';
注意hash函数的选择,尽量不使用SHA1()/md5,这只是举例,可以选择CRC32()等其他函数。
原字段和hash处理的字段都要筛选,为了避免hash冲突对性能的影响
特点:
1、只能匹配键值的全职匹配的查询
2、索引大小取决于hash函数
3、利用索引来优化锁
Innodb使用的是行级锁,只有在修改行的时候,才会被加锁,索引就减少了锁定的行数,也加快了锁的释放
索引可以加快处理速度,也加快了锁的释放
如果没有索引,对表进行操作,使用排它锁,就会把整个表锁住,而使用了索引,只会锁住一行
CREATE TABLE actor(

	actor_id SMALLINT(5) UNSIGNED NOT NULL auto_increment,

	first_name VARCHAR(45) NOT NULL,

	last_name VARCHAR(45) NOT NULL,

	last_update timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,

	PRIMARY KEY (actor_id)

)	ENGINE=InnoDB AUTO_INCREMENT=39 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci

EXPLAIN SELECT * FROM actor WHERE last_name='tom' for UPDATE;

--在另一个会话中,执行下个语句,发现无法执行

EXPLAIN SELECT * FROM actor WHERE last_name='jerry' for UPDATE;

--如果把last_name列加上索引

CREATE INDEX idx_lastname ON actor(last_name);

EXPLAIN SELECT * FROM actor WHERE last_name='tom' for UPDATE;

--在另一个会话中,执行下个语句,发现就可以执行

EXPLAIN SELECT * FROM actor WHERE last_name='jerry' for UPDATE;
4、索引的维护和优化
1).删除重复索引
例如:id 主键primary key 主键索引unique key 单列索引index,这时候主键实际上就是一个非空的唯一索引
2).删除冗余索引:已经创建了索引,但是有联合索引包含了该列
例如:index(a) index(a,b)
primary key(id) index(b,id)
可以通过工具pt-duplicate-key-checker h=127.0.0.1查看冗余索引是否有存在的必要,可以saklia官网下载
3).删除很少或不会再被使用的索引
有SQL语句可以查看数据库的各个表的索引使用次数,这样就可以确定有些索引有没有存在的必要
SELECT

	object_schema,

	object_name,

	index_name,

	b.table_rows

FROM

	performance_schema.table_io_waits_summary_by_index_usage a

JOIN information_schema.TABLES b ON a.OBJECT_SCHEMA = b.table_schema

AND a.OBJECT_NAME = b.table_name

WHERE

	INDEX_NAME IS NOT NULL

AND COUNT_STAR = 0

ORDER BY

	OBJECT_SCHEMA,

	OBJECT_NAME;

4).更新索引的统计信息及减少索引碎片
重新生成索引的统计信息:analyze table table_name
MyISAM需要把统计信息保存在磁盘中,需要扫描所有的索引,会把表进行锁定
InnoDB是保存在内存中,生成的是估算值,不是百分百准确
通过optimize table table_name对表和索引进行维护,但是会锁表
MySQL系列(六)--索引优化的更多相关文章
- information_schema系列六(索引,表空间,权限,约束相关表)
information_schema系列六(索引,表空间,权限,约束相关表) 1: STATISTICS 这个表提供的是关于表的索引信息: INFORMATION_SCHEMA Name SHOW ...
- MySQL中的索引优化
MySQL中的SQL的常见优化策略 MySQL中的索引优化 MySQL中的索引简介 过多的使用索引将会造成滥用.因此索引也会有它的缺点.虽然索引大大提高了查询速度,同时却会降低更新表的速度,如对表进行 ...
- MySql在建立索引优化时需要注意的问题
MySql在建立索引优化时需要注意的问题 设计好MySql的索引可以让你的数据库飞起来,大大的提高数据库效率.设计MySql索引的时候有一下几点注意: 1,创建索引 对于查询占主要的应用来说,索引显得 ...
- 五分钟,让你明白MySQL是怎么选择索引《死磕MySQL系列 六》
系列文章 二.一生挚友redo log.binlog<死磕MySQL系列 二> 三.MySQL强人"锁"难<死磕MySQL系列 三> 四.S 锁与 X 锁的 ...
- MySql学习(六) —— 数据库优化理论(二) —— 查询优化技术
逻辑查询优化包括的技术 1)子查询优化 2)视图重写 3)等价谓词重写 4)条件简化 5)外连接消除 6)嵌套连接消除 7)连接消除 8)语义优化 9)非SPJ优化 一.子查询优化 1. ...
- MySQL系列(七)--SQL优化的步骤
前面讲了如何设计数据库表结构.存储引擎.索引优化等内存,这篇文章会讲述如何进行SQL优化,也是面试中关于数据库肯定会被问到的, 这些内容不仅仅是为了面试,更重要的是付诸实践,最终用到工作当中 之前的M ...
- MySQL如何利用索引优化ORDER BY排序语句
MySQL索引通常是被用于提高WHERE条件的数据行匹配或者执行联结操作时匹配其它表的数据行的搜索速度. MySQL也能利用索引来快速地执行ORDER BY和GROUP BY语句的排序和分组操作. 通 ...
- MySQL如何利用索引优化ORDER BY排序语句 【转载】
本文转载自:http://blog.csdn.net/ryb7899/article/details/5580624 .感谢相关作者. MySQL索引通常是被用于提高WHERE条件的数据行匹配或者执 ...
- MySQL 多列索引优化小记
MySQL 5.6.30 问题背景 由于爬虫抓取的数据不断增多,这两天在不断对数据库以及查询语句进行优化,其中一个表结构如下: CREATE TABLE `newspaper_article` ( ` ...
随机推荐
- selenium基础(窗口截图)
窗口截图 目的:当脚本执行出错时对当前窗口进行截图 方法:get_screenshot_as_file() #打开百度首页,搜索“selenium",完成后进行截图,并将结果保存至D:/te ...
- 大半宿,封装了一个MP3播放器的类,写了个简陋的播放器
用 winmm.lib 写的 封装不是很好,而且没有优化,效率可能有问题,但是现在几乎没有什么大问题 我用我封装的类,写了一个小播放器,界面上的所有功能都实现了,包括双击列表中的文件名,直接播放文件 ...
- LoadRunner如何调用外部函数
LoadRunner如何调用外部函数 使用 VuGen 时,可以调用在外部 DLL 中定义的函数.通过从脚本调用外部函数,可以降低脚本的内存使用量以及总体运行时间.要调用外部函数,需要加载定义了该函数 ...
- Java系列笔记(4) - JVM监控与调优【转】
Java系列笔记(4) - JVM监控与调优[转] 目录 参数设置收集器搭配启动内存分配监控工具和方法调优方法调优实例 光说不练假把式,学习Java GC机制的目的是为了实用,也就是为了在 ...
- leetcode146周赛-1130-叶值的最小代价生成树*
题目描述: class Solution(object): def mctFromLeafValues(self, arr): """ :type arr: List[i ...
- C++模拟实现Objective-C协议和代理模式
Objective-C的协议和代理是运用最多的特性之一,可以说在苹果系列开发中无处不在.事实上很多人都不知道其背后的原理.事实上简单点说,这就是设计模式中的代理模式的经典运用.代理模式简单点说就是为其 ...
- 数组(Array)与 字符串(String)公用的属性与方法
数组与字符串都有很多方法,有一些方法是公用的,在这里就将数组与字符串公用的方法提取出来,方便大家的记忆 1. length 可通过str.length与arr.length分别取到字符串与数组的长度: ...
- Django之深入了解模板层
目录 模板语法 模板传值 过滤器 标签 自定义过滤器和标签 模板继承 模板导入 模板语法 前端模板的语法只记住两种就行了. {{ xxx }} 变量相关的 { % % } 逻辑相关的 模板传值 我们通 ...
- Ionic3 demo TallyBook 实例1
1.创建项目 ionic start TallyBook blank 创建一个空的项目 ionic cordova platform add android 添加andorid平台 io ...
- poj 3682 King Arthur's Birthday Celebration (期望dp)
传送门 解题思路 第一问比较简单,设$f[i]$表示扔了$i$次正面向上的硬币的期望,那么有转移方程 : $f[i]=f[i]*(1-p)+f[i-1]*p+1$,意思就是$i$次正面向上可以 ...