
Lucene使用IKAnalyzer分词
1.分析器 所有分析器最终继承的类都是Analyzer
1.1 默认标准分析器:StandardAnalyzer
在我们创建索引的时候,我们使用到了IndexWriterConfig对象,在我们创建索引的过程当中,会经历分析文档的步骤,就是分词的步骤,默认采用的标准分析器自动分词
1.1.1 查看分析器的分析效果
 public static void main(String[] args) throws IOException {

        //1.创建一个Analyzer对象

        StandardAnalyzer analyzer = new StandardAnalyzer();

        //2.调用Analyzer对象的tokenStream方法获取TokenStream对象,此对象包含了所有的分词结果

        TokenStream tokenStream = analyzer.tokenStream("", "安装mysql-5.7.22-winx64后数据库服务启动报错:本地计算机上的mysql服务启动停止后,某些服务未由其他服务或程序使用时将自动停止而且mysql官网下载的压缩包解压出来没有网线上安装教... 博文 来自: 测试菜鸟在路上,呵呵");

        //3.给tokenStream对象设置一个指针,指针在哪当前就在哪一个分词上

        CharTermAttribute charTermAttribute = tokenStream.addAttribute(CharTermAttribute.class);

        //4.调用tokenStream对象的reset方法,重置指针,不调用会报错

        tokenStream.reset();

        //5.利用while循环,拿到分词列表的结果  incrementToken方法返回值如果为false代表读取完毕  true代表没有读取完毕

        while (tokenStream.incrementToken()){

            System.out.println(charTermAttribute.toString());

        }

        //6.关闭

        tokenStream.close();

    }
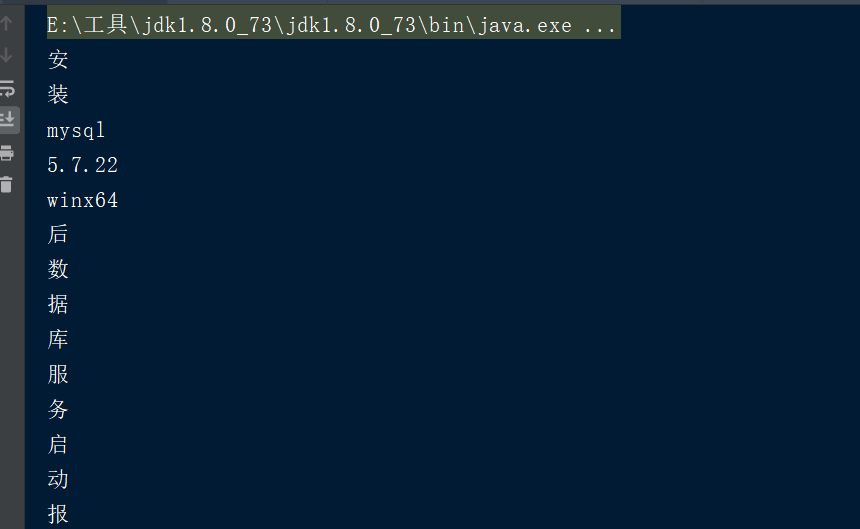
分析会去掉停用词,忽略大小写,祛除标点
默认标准分析器分析英文没有问题,但是他分析中文时会拆分成单个汉字,这显然不符合实际需求
1.2 中文分析器
第三方中文分析器:IKAnalyzer
IKAnalyzer的使用步骤:
1.导入依赖
 <!-- https://mvnrepository.com/artifact/com.jianggujin/IKAnalyzer-lucene -->

                    <dependency>

                        <groupId>com.jianggujin</groupId>

                        <artifactId>IKAnalyzer-lucene</artifactId>

                        <version>8.0.0</version>

                    </dependency>
2.配置IKAnalyzer,导入配置文件
hotword.dic 扩展词典,可以将时尚的网络名词放入到该词典当中,这样就能根据扩展词典进行分词
stopword.dic 停用词词典,可以将无意义的词和敏感词汇放入到该词典当中,这样在分析的时候就会忽略这些内容
<?xml version="1.0" encoding="UTF-8"?>

<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">

<properties>

    <comment>IK Analyzer 扩展配置</comment>

    <!--用户可以在这里配置自己的扩展字典 -->

    <entry key="ext_dict">hotword.dic;</entry>

    <!--用户可以在这里配置自己的扩展停止词字典    词典可以有多个,每一个用;分割-->

    <entry key="ext_stopwords">stopword.dic;</entry>

</properties>
在自定义扩展词典和停用词词典的过程当中,千万不要使用windows记事本编辑,因为windows记事本是UTF-8+BOM编码
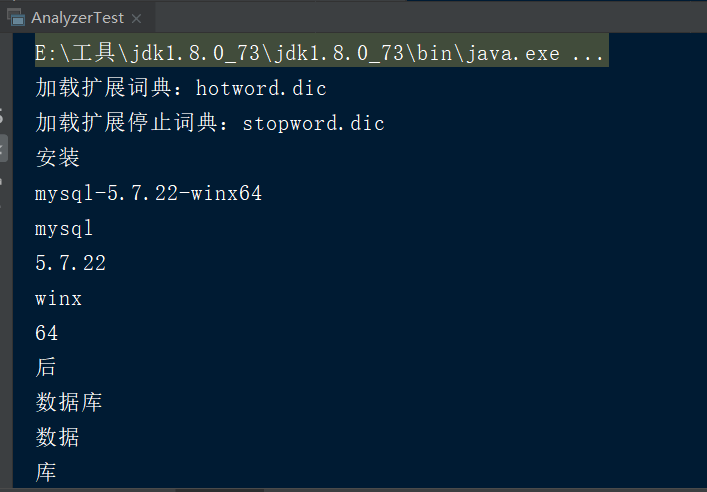
3.使用IKAnalyzer进行分词
public static void main(String[] args) throws IOException {

        //1.创建一个Analyzer对象

        Analyzer analyzer=new IKAnalyzer();

        //2.调用Analyzer对象的tokenStream方法获取TokenStream对象,此对象包含了所有的分词结果

        TokenStream tokenStream = analyzer.tokenStream("", "安装mysql-5.7.22-winx64后数据库服务启动报错:本地计算机上的mysql服务启动停止后,某些服务未由其他服务或程序使用时将自动停止而且mysql官网下载的压缩包解压出来没有网线上安装教... 博文 来自: 测试菜鸟在路上,呵呵");

        //3.给tokenStream对象设置一个指针,指针在哪当前就在哪一个分词上

        CharTermAttribute charTermAttribute = tokenStream.addAttribute(CharTermAttribute.class);

        //4.调用tokenStream对象的reset方法,重置指针,不调用会报错

        tokenStream.reset();

        //5.利用while循环,拿到分词列表的结果  incrementToken方法返回值如果为false代表读取完毕  true代表没有读取完毕

        while (tokenStream.incrementToken()){

            System.out.println(charTermAttribute.toString());

        }

        //6.关闭

        tokenStream.close();

    }
得到的就是常用的单词了
4.程序当中使用IKAnalyzer
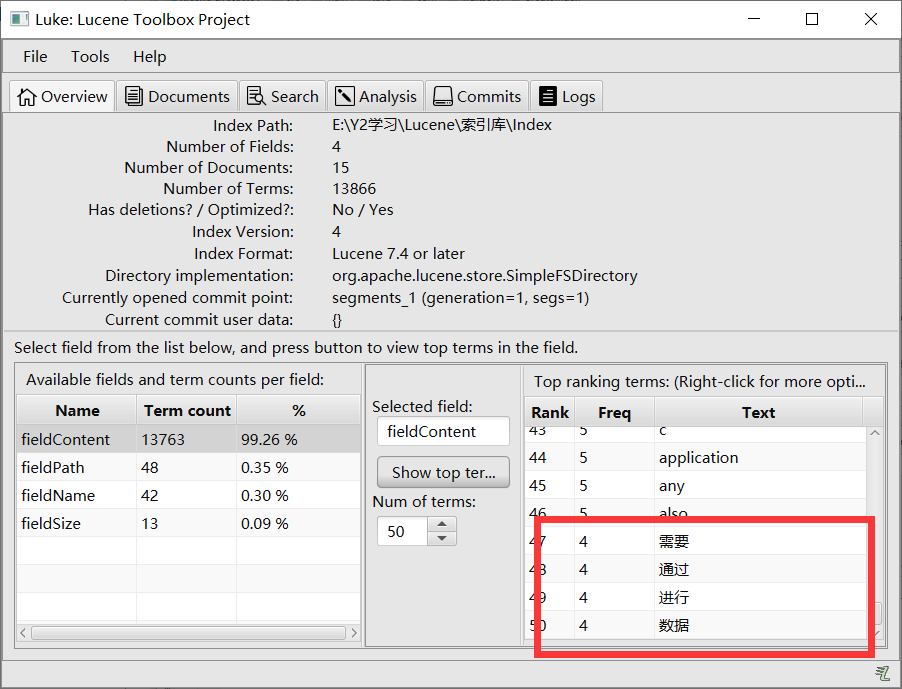
IndexWriter indexWriter=new IndexWriter(directory,new IndexWriterConfig(new IKAnalyzer()));
Lucene使用IKAnalyzer分词的更多相关文章
- Lucene使用IKAnalyzer分词实例 及 IKAnalyzer扩展词库
文章转载自:http://www.cnblogs.com/dennisit/archive/2013/04/07/3005847.html 方案一: 基于配置的词典扩充 项目结构图如下: IK分词器还 ...
- Lucene的中文分词器IKAnalyzer
分词器对英文的支持是非常好的. 一般分词经过的流程: 1)切分关键词 2)去除停用词 3)把英文单词转为小写 但是老外写的分词器对中文分词一般都是单字分词,分词的效果不好. 国人林良益写的IK Ana ...
- lucene全文搜索之二:创建索引器(创建IKAnalyzer分词器和索引目录管理)基于lucene5.5.3
前言: lucene全文搜索之一中讲解了lucene开发搜索服务的基本结构,本章将会讲解如何创建索引器.管理索引目录和中文分词器的使用. 包括标准分词器,IKAnalyzer分词器以及两种索引目录的创 ...
- Lucene学习——IKAnalyzer中文分词
一.环境 1.平台:MyEclipse8.5/JDK1.5 2.开源框架:Lucene3.6.1/IKAnalyzer2012 3.目的:测试IKAnalyzer的分词效果 二.开发调试 1.下载框架 ...
- Lucene系列四:Lucene提供的分词器、IKAnalyze中文分词器集成、扩展 IKAnalyzer的停用词和新词
一.Lucene提供的分词器StandardAnalyzer和SmartChineseAnalyzer 1.新建一个测试Lucene提供的分词器的maven项目LuceneAnalyzer 2. 在p ...
- IKAnalyzer 分词
IK Analyzer 3.0特性 采用了特有的"正向迭代最细粒度切分算法",具有80万字/秒的高速处理能力 采用了多子处理器分析模式,支持:英文字母(IP地址.Email.URL ...
- solr、Lucene、IKAnalyzer这三者关系是怎样的?
lucene 是开源搜索引擎 solr 是基于 lucene开发的搜索引擎 IK 是中文分词. lucene 不是一个搜索引擎,只是一个基础的文件索引工具包,或者叫“搜索引擎开发包”.不能单独作为程序 ...
- Solr配置Ikanalyzer分词器
上一篇文章讲解在win系统中如何安装solr并创建一个名为test_core的Core,接下为text_core配置Ikanalyzer 分词器 1.打开text_core的instanceDir目录 ...
- 【盘古分词】Lucene.Net 盘古分词 实现公众号智能自动回复
盘古分词是一个基于 .net framework 的中英文分词组件.主要功能 中文未登录词识别 盘古分词可以对一些不在字典中的未登录词自动识别 词频优先 盘古分词可以根据词频来解决分词的歧义问题 多元 ...
随机推荐
- Linux磁盘管理及挂载
1.在vm workstations添加磁盘 添加完之后重启一下虚拟机 然后fdisk -l 可以看到虚拟机已经识别到了新的磁盘 2.添加磁盘分区 输入命令 fdisk /dev/sdb 命令(输入 ...
- JAVA&&JAVA WEB开发包U盘封装版
难以忍受机房的开发环境,就简单实现了将所有的开发文件封装进了U盘. 基于wmic的强大功能,实现了机房变态环境下的设置环境变量OS不用重新启动OS! install.bat @echo off mod ...
- Visual Studio 2012 出现关于ActivityLog.xml错误的解决方案
由sp1升级sp2后出现的错误. devenv.exe /safemode启动下,就可以了 命令列參數 描述 /Command (devenv.exe) 啟動 IDE 並執行指定的命令. /Debug ...
- Bash 脚本中的 set -euxo pipefail
有些开发人员会用Bash来实现很复杂的功能,就像使用别的高级语言一样.他可能觉得自己很牛逼但其他人早就想锤爆他了,Bash的可读性和可维护性远远低于任何高级语言.更要命的是,Bash并没有方便的调试工 ...
- Linux系统资料
Linux的心得: 1)Linux由众多微内核组成,其源代码完全开源: 2)Linux继承了Unix的特性,具有非常强大的网络功能,其支持所有的因特网协议,包括TCP/IPv4. TCP/IPv6和链 ...
- YUM源部署和使用
1.前言 为什么需要内部yum源呢,有可能是业务内部的服务器对外是不通了,居于一些安全方面的考虑.内部yum源又有什么好处呢,第一,速度快:第二,内网可控,外网有问题也不影响内网包的下载和安装等. 2 ...
- linux入门系列12--磁盘管理之分区、格式化与挂载
前面系列文章讲解了VI编辑器.常用命令.防火墙及网络服务管理,本篇将讲解磁盘管理相关知识. 本文将会介绍大量的Linux命令,其中有一部分在"linux入门系列5--新手必会的linux命令 ...
- nginx设置域名转发到指定端口
1.修改nginx.conf文件,将worker_processes 1 修改为 worker_processes auto 2.创建端口代理配置文件(域名地址如:xx.baidu.com , ...
- 《Head first设计模式》之模版方法模式
模板方法模式在一个方法中定义了一个算法的骨架,而将一些步骤延迟到子类中.模板方法使得子类可以在不改变算法结构的情况下,重新定义算法中的某些步骤. 有些人没有咖啡就活不下去:有些人则离不开茶.两者共同的 ...
- CommunityServer的编译
1. 简介 Community Server是一个免费的开源协作系统,用于管理文档.项目.客户关系和电子邮件通信,可以在私有服务器上安装和配置.它的组成分为: 1. OnlyOfficeJabber ...