
爬虫入门系列(一):快速理解HTTP协议
4月份给自己挖一个爬虫系列的坑,主要涉及HTTP 协议、正则表达式、爬虫框架 Scrapy、消息队列、数据库等内容。
爬虫的基本原理是模拟浏览器进行 HTTP 请求,理解 HTTP 协议是写爬虫的必备基础,招聘网站的爬虫岗位也赫然写着熟练掌握HTTP协议规范,写爬虫还不得不先从HTTP协议开始讲起
HTTP协议是什么?
你浏览的每一个网页都是基于 HTTP 协议呈现的,HTTP 协议是互联网应用中,客户端(浏览器)与服务器之间进行数据通信的一种协议。协议中规定了客户端应该按照什么格式给服务器发送请求,同时也约定了服务端返回的响应结果应该是什么格式。
只要大家都按照协议规定方式发起请求和返回响应结果,任何人都可以基于HTTP协议实现自己的Web客户端(浏览器、爬虫)和Web服务器(Nginx、Apache等)。
HTTP 协议本身是非常简单的。它规定,只能由客户端主动发起请求,服务器接收请求处理后返回响应结果,同时 HTTP 是一种无状态的协议,协议本身不记录客户端的历史请求记录。
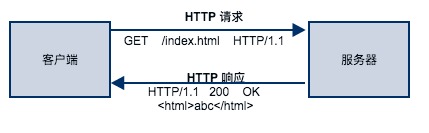
HTTP 协议是如何规定请求格式和响应格式的呢?换言之,客户端按照什么格式才能正确发起 HTTP 请求呢?服务端按照什么格式返回响应结果客户端才能正确解析?
HTTP 请求
HTTP 请求由3部分组成,分别是请求行、请求首部、请求体,首部和请求体是可选的,并不是每个请求都需要的。
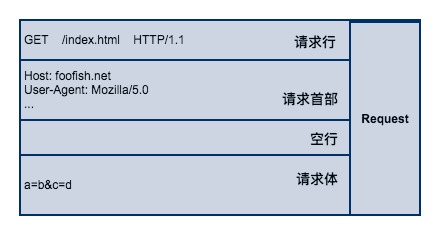
请求行
请求行是每个请求必不可少的部分,它由3部分组成,分别是请求方法(method)、请求URL(URI)、HTTP协议版本,以空格隔开。
HTTP协议中最常用的请求方法有:GET、POST、PUT、DELETE。GET 方法用于从服务器获取资源,90%的爬虫都是基于GET请求抓取数据。
请求 URL 是指资源所在服务器的路径地址,比如上图的例子表示客户端想获取 index.html 这个资源,它的路径在服务器 foofish.net 的根目录(/)下面。
请求首部
因为请求行所携带的信息量非常有限,以至于客户端还有很多想向服务器要说的事情不得不放在请求首部(Header),请求首部用于给服务器提供一些额外的信息,比如 User-Agent 用来表明客户端的身份,让服务器知道你是来自浏览器的请求还是爬虫,是来自 Chrome 浏览器还是 FireFox。HTTP/1.1 规定了47种首部字段类型。HTTP首部字段的格式很像 Python 中的字典类型,由键值对组成,中间用冒号隔开。比如:
User-Agent: Mozilla/5.0
因为客户端发送请求时,发送的数据(报文)是由字符串构成的,为了区分请求首部的结尾和请求体的开始,用一个空行来表示,遇到空行时,就表示这是首部的结尾,请求体的开始。
请求体
请求体是客户端提交给服务器的真正内容,比如用户登录时的需要用的用户名和密码,比如文件上传的数据,比如注册用户信息时提交的表单信息。
现在我们用 Python 提供的最原始API socket 模块来模拟向服务器发起一个 HTTP 请求
with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:

    # 1. 与服务器建立连接

    s.connect(("www.seriot.ch", 80))

    # 2. 构建请求行,请求资源是 index.php

    request_line = b"GET /index.php HTTP/1.1"

    # 3. 构建请求首部,指定主机名

    headers = b"Host: seriot.ch"

    # 4. 用空行标记请求首部的结束位置

    blank_line = b"\r\n"

    # 请求行、首部、空行这3部分内容用换行符分隔,组成一个请求报文字符串

    # 发送给服务器

    message = b"\r\n".join([request_line, headers, blank_line])

    s.send(message)

    # 服务器返回的响应内容稍后进行分析

    response = s.recv(1024)

    print(response)
HTTP 响应
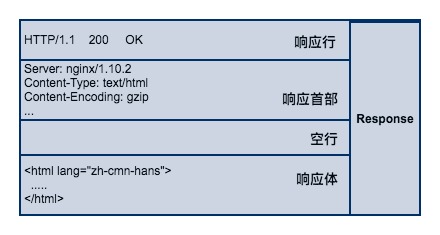
服务端接收请求并处理后,返回响应内容给客户端,同样地,响应内容也必须遵循固定的格式浏览器才能正确解析。HTTP 响应也由3部分组成,分别是:响应行、响应首部、响应体,与 HTTP 的请求格式是相对应的。
响应行
响应行同样也是3部分组成,由服务端支持的 HTTP 协议版本号、状态码、以及对状态码的简短原因描述组成。
状态码是响应行中很重要的一个字段。通过状态码,客户端可以知道服务器是否正常处理的请求。如果状态码是200,说明客户端的请求处理成功,如果是500,说明服务器处理请求的时候出现了异常。404 表示请求的资源在服务器找不到。除此之外,HTTP 协议还很定义了很多其他的状态码,不过它不是本文的讨论范围。
响应首部
响应首部和请求首部类似,用于对响应内容的补充,在首部里面可以告知客户端响应体的数据类型是什么?响应内容返回的时间是什么时候,响应体是否压缩了,响应体最后一次修改的时间。
响应体
响应体(body)是服务器返回的真正内容,它可以是一个HTML页面,或者是一张图片、一段视频等等。
我们继续沿用前面那个例子来看看服务器返回的响应结果是什么?因为我只接收了前1024个字节,所以有一部分响应内容是看不到的。
b'HTTP/1.1 200 OK\r\n

Date: Tue, 04 Apr 2017 16:22:35 GMT\r\n

Server: Apache\r\n

Expires: Thu, 19 Nov 1981 08:52:00 GMT\r\n

Set-Cookie: PHPSESSID=66bea0a1f7cb572584745f9ce6984b7e; path=/\r\n

Transfer-Encoding: chunked\r\n

Content-Type: text/html; charset=UTF-8\r\n\r\n118d\r\n

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Strict//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd">\n\n

<html xmlns="http://www.w3.org/1999/xhtml" xml:lang="en" lang="en">\n

<head>\n\t

    <meta http-equiv="Content-Type" content="text/html;charset=iso-8859-1" />    \n\t

    <meta http-equiv="content-language" content="en" />\n\t

...

</html>
从结果来看,它与协议中规范的格式是一样的,第一行是响应行,状态码是200,表明请求成功。第二部分是响应首部信息,由多个首部组成,有服务器返回响应的时间,Cookie信息等等。第三部分就是真正的响应体 HTML 文本。
至此,你应该对 HTTP 协议有一个总体的认识了,爬虫的行为本质上就是模拟浏览器发送HTTP请求,所以要想在爬虫领域深耕细作,理解 HTTP 协议是必须的。
当然 HTTP 协议远不止这么一点内容,也根本不可能用一篇文章就试图把它全部讲清楚,我在这里也只是抛砖引玉,想深入了解HTTP的,可参考公众号「Python之禅」推荐的延伸阅读。原文
延伸阅读
- 《图解HTTP》
- 《HTTP权威指南》
- HTTP Request:https://www.w3.org/Protocols/rfc2616/rfc2616-sec5.html#sec5
- HTTP Response:https://www.w3.org/Protocols/rfc2616/rfc2616-sec6.html
爬虫入门系列(一):快速理解HTTP协议的更多相关文章
- 脑残式网络编程入门(四):快速理解HTTP/2的服务器推送(Server Push)
本文原作者阮一峰,作者博客:ruanyifeng.com. 1.前言 新一代HTTP/2 协议的主要目的是为了提高网页性能(有关HTTP/2的介绍,请见<从HTTP/0.9到HTTP/2:一文读 ...
- 爬虫入门系列(二):优雅的HTTP库requests
在系列文章的第一篇中介绍了 HTTP 协议,Python 提供了很多模块来基于 HTTP 协议的网络编程,urllib.urllib2.urllib3.httplib.httplib2,都是和 HTT ...
- 爬虫入门系列(三):用 requests 构建知乎 API
爬虫入门系列目录: 爬虫入门系列(一):快速理解HTTP协议 爬虫入门系列(二):优雅的HTTP库requests 爬虫入门系列(三):用 requests 构建知乎 API 在爬虫系列文章 优雅的H ...
- Scrapy爬虫入门系列3 将抓取到的数据存入数据库与验证数据有效性
抓取到的item 会被发送到Item Pipeline进行处理 Item Pipeline常用于 cleansing HTML data validating scraped data (checki ...
- 《轻量级Java Web整合开发入门SSH》 - 快速理解Java框架的又一积木
学习JAVA不难,难的是没有多余的时间给你仔细学习. 伴随着项目的不断跟进,责任重于泰山,必须快速提升. 我不能期望把一本书或者一个项目完全吃透,只希望能用数量去 ...
- 5分钟带你快速理解Http协议
HTTP协议 什么是HTTP协议 HTTP(Hyper Text Transfer Protocol)协议又叫超文本传输协议,是建立在TCP/IP协议之上的用来传递数据的协议.它不涉及数据包的传递,主 ...
- Scrapy爬虫入门系列2 示例教程
本来想爬下http://www.alexa.com/topsites/countries/CN 总排名的,但是收费了 只爬了50条数据: response.xpath('//div[@class=&q ...
- Scrapy爬虫入门系列4抓取豆瓣Top250电影数据
豆瓣有些电影页面需要登录才能查看. 目录 [隐藏] 1 创建工程 2 定义Item 3 编写爬虫(Spider) 4 存储数据 5 配置文件 6 艺搜参考 创建工程 scrapy startproj ...
- 【 D3.js 入门系列 --- 7 】 理解 update, enter, exit 的使用
在前面几节中反复出现了如下代码: svg.selectAll("rect") .data(dataset) .enter() .append("rect") 当 ...
随机推荐
- SQLServer 数据的导入
选择数据源,选择文件路径 直接点击下一步,选择自己的源表和目标表 勾选忽略,然后到完成,数据上传成功 可能出现的问题:源文件和目标文件的列名不一致,导致被忽略不能导入 预览发现有乱码,因为编码格式
- SuperWebClient -一个基于CURL的.NET HTTP/HTTPS模拟神组件(1)
我们都知道,不管你是做爬虫也好,采集工具也罢,它们的HTTP/HTTPS模拟访问总是一个基础问题,我估计有很多人和我一样,虽然这样,那样的内置或是第三方类库用了很多,却总是会有一些不如意的问题存在,亦 ...
- 面向对象重写(override)与重载(overload)区别 (转)
一.重写(override) override是重写(覆盖)了一个方法,以实现不同的功能.一般是用于子类在继承父类时,重写(重新实现)父类中的方法. 重写(覆盖)的规则: 1.重写方法的参数列表必须完 ...
- c#基础语句——分支语句
一.if...else... if是如果的意思,else是另外的意思,if后面跟(),括号内为判断条件,如果符合条件则进入if语句执行命令.如果不符合则不进入if语句.else后不用加条件,但是必须与 ...
- Jenkins+Git 持续集成
持续集成是必要的! 希望达到的效果是:开发同事签入代码后,对应的站点可以自动实现更新.目前还只在在内部服务器上实现开发环境中的站点更新,不涉及到线上的发布. 目前使用Jenkins实现这样的持续集成. ...
- KoaHub平台基于Node.js开发的Koa的模板系统handlebars插件代码详情
koahub-handlebars koahub-handlebars koahub handlebars templates Installation $ npm install koahub-ha ...
- 本机安装mysql服务,步骤教程(另附SQLyog和Navicat工具)
因为这段时间不是装系统就是换硬盘,导致装了还几次MySql,每次都记不住都要上网找教程,着实麻烦,所以这次干脆直接写到博客上好了,便于自己也便于他人: 百度云:http://pan.baidu.com ...
- php简单分页
<?php //详情联系QQ:1195989301 自己引用数据库类文件 $c = $db->get_one("select count(*) from `{$DT_PRE}br ...
- 轻松理解JavaScript之AJAX
摘要 AJAX技术是网页构建的必备技能之一,本文希望能帮助大家轻松的学习这项技术 一.什么是ajax? ajax(异步javascript xml) 能够刷新局部网页数据而不是重新加载整个网页. 二. ...
- IntelliJ Idea和IntelliJ webstrm 常用快捷键
Ctrl+Shift + Enter,语句完成"!",否定完成,输入表达式时按 "!"键Ctrl+E,最近的文件Ctrl+Shift+E,最近更改的文件Shif ...