
Carbondata源码系列(二)文件格式详解
在上一章当中,写了文件的生成过程。这一章主要讲解文件格式(V3版本)的具体细节。
1、字典文件格式详解
字典文件的作用是在存储的时候将字符串等类型转换为int类型,好处主要有两点:
1、减少存储占用空间
2、用在需要group by的字段上比较合适,可以减少计算时的shuffle的数据量。
每一个字典列都有对应的三种文件.dict, .sortindex, .dictmeta文件,输出格式都是thrift格式
1.1 .dict文件
字典的值每满1000就作为一个chunk输出一次,具体的类是ColumnDictionaryChunk
相关参数:
carbon.dictionary.chunk.size
1.2 .sortindex文件
把字段的值sort了一下之后,计算出每个值的sortIndex和invertedIndex,具体的类是ColumnSortInfo
1、List<SortIndex>,记录着每个字典值的surrogate,从1开始
2、List<SortInvertedIndex>,记录着每个字典surrogate在数组中的位置,从1开始
它们的关系如下:
      sortIndex[i] = dictionarySortModel.getKey();
      // the array index starts from 0 therefore -1 is done to avoid wastage
      // of 0th index in array and surrogate key starts from 1 there 1 is added to i
      // which is a counter starting from 0
      sortIndexInverted[dictionarySortModel.getKey() - ] = i + ;
假设字典值是beijing,shenzhen,shanghai
| 城市 | surrogate | sortIndex | invertIndex |
| beijing | 1 | 1 | 1 |
| shenzhen | 2 | 3 | 3 |
| shanghai | 3 | 2 | 2 |
1.3 .dictmeta文件
该文件主要记录字典的以下属性,具体的类是ColumnDictionaryChunkMeta
1、最小key
2、最大的key
3、开始offset
4、结束offset
5、chunk的数量
2、数据文件详解
2.1 数据块的组成部分
CarbonRow在sort阶段会被分成3个部分:
1、字典列(mdk,SORT_COLUMNS都是字典列)
2、非字典维度列和高基数列
3、度量值列
在写入的时候,先写入到TablePage里,TablePage会把数据拆分成4部分
// one vector to make it efficient for sorting
private ColumnPage[] dictDimensionPages;
private ColumnPage[] noDictDimensionPages;
private ComplexColumnPage[] complexDimensionPages;
private ColumnPage[] measurePages;
每个TablePage都会记录以下几个Key:
private byte[][] currentNoDictionaryKey;
// MDK start key
private byte[] startKey;
// MDK end key
private byte[] endKey;
// startkey for no dictionary columns
private byte[][] noDictStartKey;
// endkey for no diciotn
private byte[][] noDictEndKey;
// startkey for no dictionary columns after packing into one column
private byte[] packedNoDictStartKey;
// endkey for no dictionary columns after packing into one column
private byte[] packedNoDictEndKey;
数据在一行一行写到TablePage之后,最后会做一次统一的编码,详细的方法请看TablePage的encode方法。
Page的meta信息
  private DataChunk2 buildPageMetadata(ColumnPage inputPage, byte[] encodedBytes)
      throws IOException {
    DataChunk2 dataChunk = new DataChunk2();
    dataChunk.setData_page_length(encodedBytes.length);
    fillBasicFields(inputPage, dataChunk);
    fillNullBitSet(inputPage, dataChunk);
    fillEncoding(inputPage, dataChunk);
    fillMinMaxIndex(inputPage, dataChunk);
    fillLegacyFields(dataChunk);
    return dataChunk;
  }
一个blocket的阈值是64MB,一个blocket包括N个TablePage,当写满一个TablePage之后,就把blocket写入到文件当中。
carbondata的BTree索引,是一个记录着每个Blocklet的mdk的startKey和endKey,以及Blocklet当中所有TablePage的列的最大最小值
那么数据文件的详细格式,基本和官网上介绍的是一致的

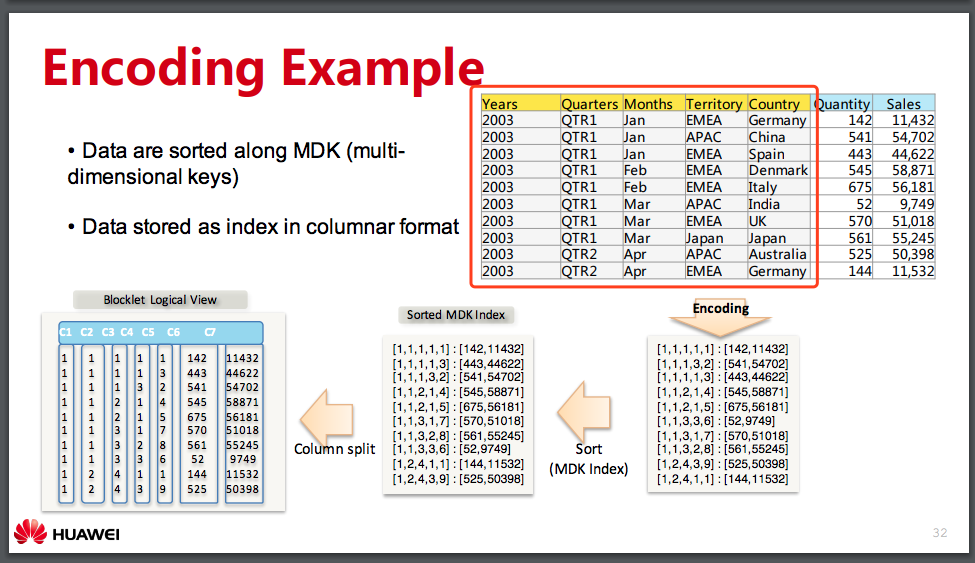
2.2 What is MDK
mdk和hbase的rowkey是一个性质的,详细可以看下面这张图,排序方式跟hbase没有任何区别
3、索引文件详解
索引文件以.carbonindex结尾
索引文件包括三个部分:索引头,索引两部分
索引头包括:
1、文件格式版本(当前版本是V3)
2、Segment信息(有多少列,列的基数)
3、列的信息
4、bucket ID
索引信息包括以下信息:
1、Blocket的记录数
2、数据文件名
3、Blocket的meta信息offset
3、BlockletIndex (BTree索引,包含blocket的startKey、endKey,以及每一列的最大最小值,这个前面已经讲过了)
4、BlocketInfo(记录数,每个TablePage的offset,每个TablePage的长度,维度列dimension_offsets的起始位置,度量值measure_offsets的起始位置,有多少个TablePagenumber_number_of_pages)
索引文件的信息在文件的footer当中也是存在的,在carbondata1.2当中索引文件还是有很多个,感觉有点多余。
到carbondata1.3会被合并成一个文件,这样就能大大缩短启动的时候加载索引的开销。
岑玉海
转载请注明出处,谢谢!
Carbondata源码系列(二)文件格式详解的更多相关文章
- 我的书籍《深入解析Java编译器:源码剖析与实例详解》就要出版了
一个十足的技术迷,2013年毕业,做过ERP.游戏.计算广告,在大公司呆过,但终究不满足仅对技术的应用,在2018年末离开了公司,全职写了一本书<深入解析Java编译器:源码剖析与实例详解> ...
- nginx源码分析线程池详解
nginx源码分析线程池详解 一.前言 nginx是采用多进程模型,master和worker之间主要通过pipe管道的方式进行通信,多进程的优势就在于各个进程互不影响.但是经常会有人问道,n ...
- 【集合框架】JDK1.8源码分析之ArrayList详解(一)
[集合框架]JDK1.8源码分析之ArrayList详解(一) 一. 从ArrayList字表面推测 ArrayList类的命名是由Array和List单词组合而成,Array的中文意思是数组,Lis ...
- Hexo系列(二) 配置文件详解
Hexo 是一款优秀的博客框架,在使用 Hexo 搭建一个属于自己的博客网站后,我们还需要对其进行配置,使得 Hexo 更能满足自己的需求 这里所说的配置文件,是位于站点根目录下的 _config.y ...
- 手牵手,从零学习Vue源码 系列二(变化侦测篇)
系列文章: 手牵手,从零学习Vue源码 系列一(前言-目录篇) 手牵手,从零学习Vue源码 系列二(变化侦测篇) 陆续更新中... 预计八月中旬更新完毕. 1 概述 Vue最大的特点之一就是数据驱动视 ...
- Spring源码之九finishRefresh详解
Spring源码之九finishRefresh详解 公众号搜索[程序员田同学],专职程序员兼业余写手,生活不止于写代码 Spring IoC 的核心内容要收尾了,本文将对最后一个方法 finishRe ...
- Spring源码系列(二)--bean组件的源码分析
简介 spring-bean 组件是 Spring IoC 的核心,我们可以使用它的 beanFactory 来获取所需的对象,对象的实例化.属性装配和初始化等都可以交给 spring 来管理. 本文 ...
- Java之字节码(2) - .class文件格式详解
转载来自 小介:去 年在读<深入解析JVM>的时候写的,记得当时还想着用自己的代码解析字节码的,最后只完成了一部分.现在都不知道还有没有保留着,貌似Apache有现 成的BCEL工程可以做 ...
- spring源码系列(二):IOC接口设计分析
这里主要对springIOC接口体系进行简单的概述和分析,具体每个接口详细分析在下面目录: 参考内容: <Spring技术内幕:深入解析 Spring架构与设计原理> 和 <Spri ...
随机推荐
- 正则和grep——再做正则就去死
grep 文本过滤工具 基本正则表达式 grep 语法 基本正则表达式的元字符 次数匹配 位置锚定 分组 扩展正则表达式 基本正则表达式的元字符 次数匹配 位置锚定 分组 或者 grep的介绍 lin ...
- python matplotlib 图表局部放大
import matplotlib.pyplot as plt from mpl_toolkits.axes_grid1.inset_locator import zoomed_inset_axes ...
- 关于在Python下安装布隆过滤器(bloomfilter)的方法
由于在爬虫代码中需要实现信息的去重功能,所以需借助bloomfilter,在看完各种博客后发现没有安装,这就尴尬了,不会连门都找不到吧.那就安装呗,各种错误,查看官方文档:http://axiak.g ...
- TIDB技术文档翻译
http://blog.csdn.net/antony9118/article/details/60470115
- eclipse运行中出错:unknown protocol: hdfs
出现这个错误因为你没有把core-site.xml和hdfs-site.xml放到项目下 程序运行开始就要调用这两个配置文件,这两个文件就是配置Hadoop时候的配置文件,只需要把至两个文件copy到 ...
- Azkaban安装部署
在root的用户下搭建的 • Azkaban安装部署(可参照:http://azkaban.github.io/azkaban/docs/latest/) 1):前提 安装JDK,安装Hadoop,H ...
- 图片格式 WebP APNG
WebP 是一种支持有损压缩和无损压缩的图片文件格式,派生自图像编码格式 VP8.根据 Google 的测试,无损压缩后的 WebP 比 PNG 文件少了 45% 的文件大小,即使这些 PNG 文件 ...
- 粗略整理的java面试题
1.垃圾回收 是回收的空闲堆空间 只有在cpu空闲并且堆空间不足的情况下才回收 2.threadlocal 就是为线程的变量都提供了一个副本,每个线程运行都只是在更新这个副本. Threadloc ...
- selenium+testN自动化测试框架搭建
自动化测试框架搭建 1 Java环境的搭建 1.1访问oracle的官网下载最新版本的jdk http://www.oracle.com/technetwork/java/javase/downloa ...
- JavaScript 数组基本操作
简介 数组操作无论是在JavaScript中还是在其他语言中都是很常见.经常会用到的,现在我把JavaScript 数组基本操作整理一下,供大家参考学习.里边包含我自己的见解以及案例,希望能够帮助大家 ...