
[MapReduce_add_2] MapReduce 实现年度最高气温统计
0. 说明
编写 MapReduce 程序实现年度最高气温统计
1. 气温数据分析
气温数据样例如下:
++023450FM-+000599999V0202701N015919999999N0000001N9-+99999102001ADDGF108991999999999999999999

++023450FM-+000599999V0202901N008219999999N0000001N9-+99999102001ADDGF104991999999999999999999

++023450FM-+000599999V0209991C000019999999N0000001N9-+99999102001ADDGF108991999999999999999999

++023450FM-+000599999V0201801N008219999999N0000001N9-+99999101831ADDGF108991999999999999999999

++023450FM-+000599999V0201801N009819999999N0000001N9-+99999101761ADDGF108991999999999999999999
对气温数据进行分析可以得出以下的结论
1. 年份的索引为 15-19 ,以此作为 Key
2. 气温的索引为 87-92 ,以此作为 Value
【思路】
在 Map 阶段将原始数据映射成满足要求的 K-V 对,在 Reduce 阶段对相同 Key 的值进行比较,得到最大值
2. 代码编写
[2.1 MaxTempMapper.java]
package hadoop.mr.maxtemp;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**

 * Mapper 类

 */

public class MaxTempMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        // 将 value 变为 String 格式

        String line = value.toString();

        // 获得年份

        String year = line.substring(15, 19);

        // 获得温度

        int temp = Integer.parseInt(line.substring(87, 92));

        // 存在脏数据 9999,所以要将其过滤

        if (temp != 9999) {

            // 输出年份与温度

            context.write(new Text(year), new IntWritable(temp));

        }

    }

}
[2.2 MaxTempReducer.java]
package hadoop.mr.maxtemp;

import org.apache.hadoop.io.DoubleWritable;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/**

 * Reducer 类

 */

public class MaxTempReducer extends Reducer<Text, IntWritable, Text, DoubleWritable> {

    @Override

    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

        Integer max = Integer.MIN_VALUE;

        // 得到最大值

        for (IntWritable value : values) {

            max = Math.max(max, value.get());

        }

        // 输出年份与最大温度

        context.write(key, new DoubleWritable(max / 10.0));

    }

}
[2.3 MaxTempApp.java]
package hadoop.mr.maxtemp;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.DoubleWritable;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

/**

 * max Temp APP

 */

public class MaxTempApp {

    public static void main(String[] args) throws Exception {

        // 初始化配置文件

        Configuration conf = new Configuration();

        // 仅在本地开发时使用

        conf.set("fs.defaultFS", "file:///");

        // 初始化文件系统

        FileSystem fs = FileSystem.get(conf);

        // 通过配置文件初始化 job

        Job job = Job.getInstance(conf);

        // 设置 job 名称

        job.setJobName("max Temp");

        // job 入口函数类

        job.setJarByClass(MaxTempApp.class);

        // 设置 mapper 类

        job.setMapperClass(MaxTempMapper.class);

        // 设置 reducer 类

        job.setReducerClass(MaxTempReducer.class);

        // 设置 map 的输出 K-V 类型

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        // 设置 reduce 的输出 K-V 类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(DoubleWritable.class);

        // 新建输入输出路径

        Path pin = new Path("E:/file/temp");

        Path pout = new Path("E:/test/wc/out");

        // 打包后自定义输入输出路径

//        Path pin = new Path(args[0]);

//        Path pout = new Path(args[1]);

        // 设置输入路径和输出路径

        FileInputFormat.addInputPath(job, pin);

        FileOutputFormat.setOutputPath(job, pout);

        // 判断输出路径是否已经存在,若存在则删除

        if (fs.exists(pout)) {

            fs.delete(pout, true);

        }

        // 执行 job

        job.waitForCompletion(true);

    }

}
3. 测试
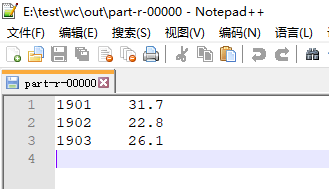
本地模式下运行代码的结果如下
4. 部署到集群上
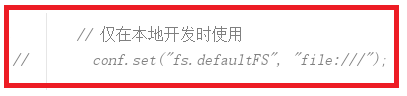
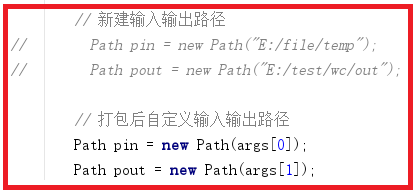
【4.1 修改代码 MaxTempApp.java】
【4.2 打包程序】


【4.3 运行程序】
开启 Hadoop 集群,然后将 temp 数据文件上传到 HDFS 中,过程略
运行以下命令
hadoop jar myhadoop-1.0-SNAPSHOT.jar hadoop.mr.maxtemp.MaxTempApp /testdata/temp /testdata/out
【查看结果】
命令行下可以看到结果,Web UI 查看 http://s101:8088

[MapReduce_add_2] MapReduce 实现年度最高气温统计的更多相关文章
- [Hive_add_7] Hive 实现最高气温统计
0. 说明 Hive 通过 substr() 函数实现最高气温统计 1. Hive 实现最高气温统计 1.1 思路 将一行文本加载为 String 通过 substr() 函数截取年份和温度 1.2 ...
- MapReduce项目之气温统计
在本博文,我们要学习一个挖掘气象数据的程序.气象数据是通过分布在美国全国各地区的很多气象传感器每隔一小时进行收集,这些数据是半结构化数据且是按照记录方式存储的,因此非常适合使用 MapReduce 程 ...
- [Spark Core] Spark 实现气温统计
0. 说明 聚合气温数据,聚合出 MAX . MIN . AVG 1. Spark Shell 实现 1.1 MAX 分步实现 # 加载文档 val rdd1 = sc.textFile(" ...
- Mapreduce的序列化和流量统计程序开发
一.Hadoop数据序列化的数据类型 Java数据类型 => Hadoop数据类型 int IntWritable float FloatWritable long LongWritable d ...
- P1567 气温统计
P1567 题目描述 炎热的夏日,KC 非常的不爽.他宁可忍受北极的寒冷,也不愿忍受厦门的夏天.最近,他开始研究天气的变化.他希望用研究的结果预测未来的天气. 经历千辛万苦,他收集了连续 N(1≤N≤ ...
- Hadoop工程师面试题(1)--MapReduce实现单表汇总统计
数据源格式描述: 输入t1.txt源数据,数据文件分隔符"*&*",字段说明如下: 字段序号 字段英文名称 字段中文名称 字段类型 字段长度 1 TIME_ID 时间(到时 ...
- [MapReduce_5] MapReduce 中的 Combiner 组件应用
0. 说明 Combiner 介绍 && 在 MapReduce 中的应用 1. 介绍 Combiner: Map 端的 Reduce,有自己的使用场景 在相同 Key 过多的情况下 ...
- 【合集】Hadoop 合集
0. 说明 Hadoop 随笔的目录 1. HDFS 主要内容: [HDFS_1] HDFS 的概念和特性 [HDFS_2] HDFS 的 Shell 操作 [HDFS_3] HDFS 工作机制 [H ...
- Hadoop基础-MapReduce的Combiner用法案例
Hadoop基础-MapReduce的Combiner用法案例 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.编写年度最高气温统计 如上图说所示:有一个temp的文件,里面存放 ...
随机推荐
- Django MTV
MTV模型 Django的MTV分别代表: Model(模型):负责业务对象与数据库的对象(ORM) Template(模版):负责如何把页面展示给用户 View(视图):负责业务逻辑,并在适当的时候 ...
- Kafka实战-数据持久化
1.概述 经过前面Kafka实战系列的学习,我们通过学习<Kafka实战-入门>了解Kafka的应用场景和基本原理,<Kafka实战-Kafka Cluster>一文给大家分享 ...
- python机器学习笔记 ID3决策树算法实战
前面学习了决策树的算法原理,这里继续对代码进行深入学习,并掌握ID3的算法实践过程. ID3算法是一种贪心算法,用来构造决策树,ID3算法起源于概念学习系统(CLS),以信息熵的下降速度为选取测试属性 ...
- freemarker中使用<@spring.*>标签实现国际化
freemarker实现国际化使用自定义指令<@spring>实现,通过@符号可以看出是自定义的指令,在哪里定义的呢? 路径如下:org/springframework/spring-we ...
- js对象深拷贝与浅拷贝
浅拷贝 把a赋值给b,a与b指向相同的内存,修改b值,a也会跟着改变. var a = "aa"; var b = a; b = "bb"; 这个时候a也变成了 ...
- 在JS中统计函数执行次数与执行时间
假如想统计JS中的函数执行次数最多的是哪个,执行时间最长的是哪个,该怎么做呢? 1. 统计函数执行次数 2. 统计函数执行时间 3. 如何控制函数的调用次数 4. 如何控制函数的执行时间 一.统计函数 ...
- netty源码解解析(4.0)-5 线程模型-EventExecutorGroup框架
上一章讲了EventExecutorGroup的整体结构和原理,这一章我们来探究一下它的具体实现. EventExecutorGroup和EventExecutor接口 io.netty.util.c ...
- python装饰器带括号和不带括号的语法和用法
装饰器的写法补充: 通常装饰器的写法是@func(),而有的时候为了减少出错率,可能会写成@func,没有()括号,这时我们可以这样定义,来减少括号.下面通过两个例子还看. 一般装饰器的写法: def ...
- 关于EF实体类的一点思考
在EF中修改一条记录时,一般是先查出该条记录,然后再通过TryUpdateModel或其他方式更新对应的属性.但我很讨厌这种要更新一条记录时,还要先去把记录查询出来的做法.我喜欢像sql语句那样的直接 ...
- C++注入记事本
#include <iostream>; using namespace std; #include <windows.h>; #include <tlhelp32.h& ...