
MRS大企业ERP流程实时数据湖加工最佳实践
本文分享自华为云社区《MRS大企业ERP流程实时数据湖加工最佳实践》,作者:晋红轻 。
本文将以ERP流程实践为例介绍MRS实时数据湖方案的演进
案例实践需求解析:
业务描述
- AE表:会计分录表,主要记录财务相关信息,可用于成本核算等业务计算。为业务最主要的表,称驱动表。
- 四通道表:实际为四个门店业务系统,主要记录销售记录信息。为成本核算、科目报表分析等业务提供信息佐证。可称为维表。
业务痛点
- 科目分析报表业务供数慢的痛点,数据时延高。
- 实际业务数据有内容更新,保证数据严格一致。
- 科目分析报表查询仅支持公司、科目、时段等少量查询条件。
实时数据湖方案优势
- 实时数据湖方案做增量加工,将传统供数压力卸载到每天、每小时、每分钟,100万数据查询只需要2min。
- 使用Hudi作为数据湖天然支持数据更新。
- 提供所有数据归档,可随时回溯。
- 支持科目、批名、凭证名、合同号等31个查询条件,大幅度减少用户导出数据后筛选过滤时间。支持用户基于页面直接分析。
实时数据湖方案实施挑战
- 流计算基于内存,峰值数据量过大会影响作业稳定性。
- 多流时延大,数据等待耗费大量内存资源,需考虑业务需求与使用资源的平衡。
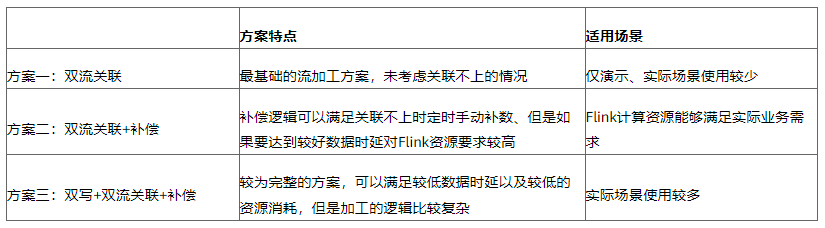
流加工模型一:
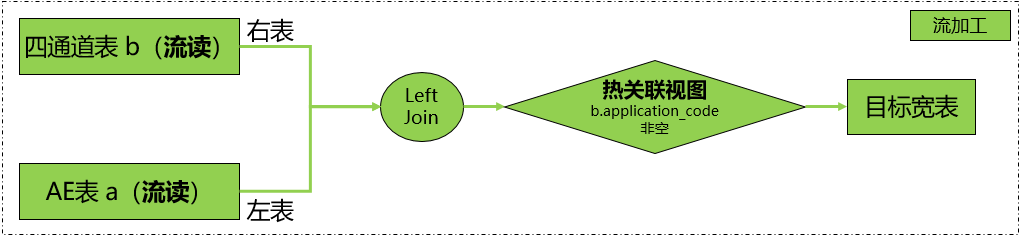
模型一特点
•Hudi表流读能够减少整体内存开销,提高作业稳定性。
•以其中一条流为基准(左表),去比较另一条流(右表)
•会出现关联缺失的情况,以驱动表(AE表)的视角(新增&更新)
•1)四通道流早到,并且ttl到期后数据丢失
•2)四通道流晚到,AE流ttl到期后数据丢失
模型一局限:
•目标宽表数据会出现不准的情况
•源端新增因为关联不出有效结果造成目标宽表缺数 -> missing
•源端更改因为关联不出有效结果造成目标宽表延时 -> delay
流加工模型二:
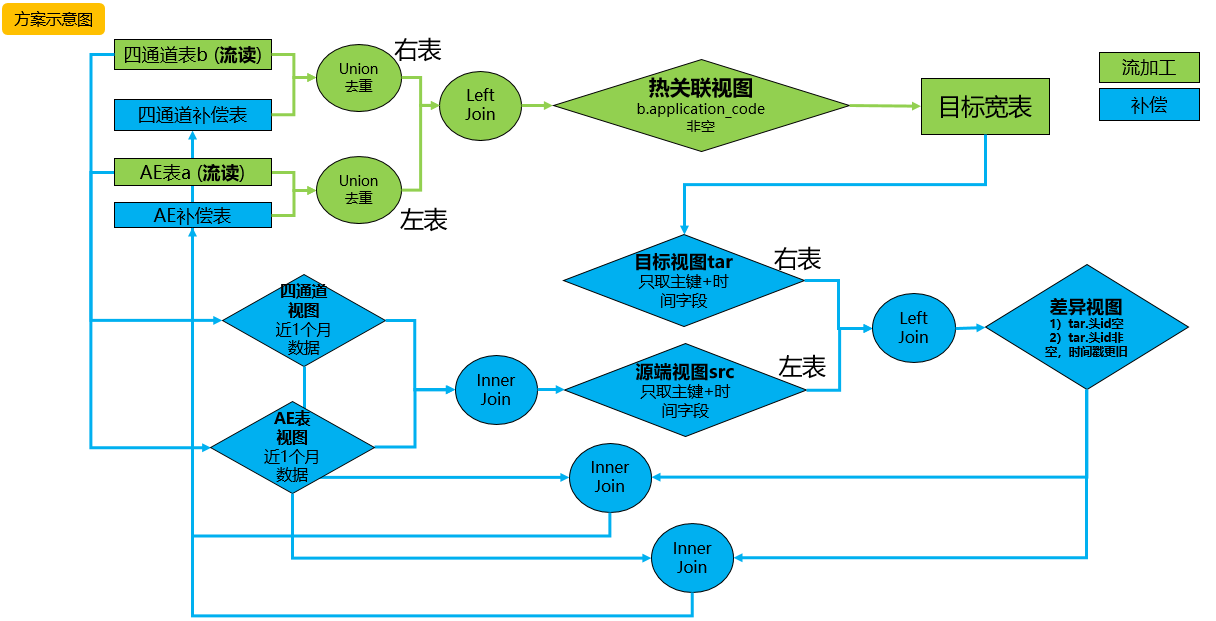
补偿目的:
补偿目的:基于业务逻辑,对比源端流表和目的端宽表数据内容,发现目标宽表缺失数据主要字段,关联源表完整内容找出缺失数据,并写回源端表补偿层。
missing&delay补偿模拟:
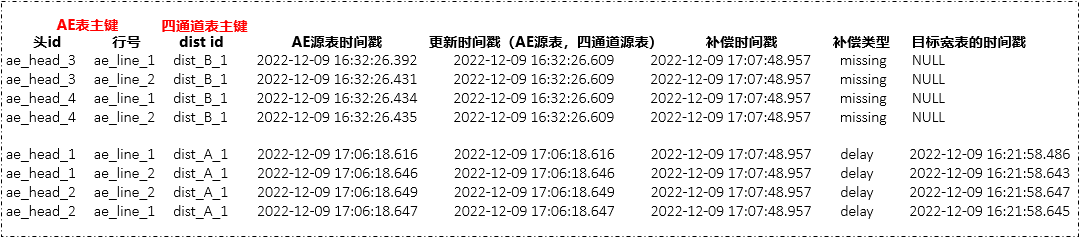
模型二特点:比较方案一增加补偿机制,能够对比源表(AE表,四通道表)以及目标宽表,找出缺失数据missing, delay。
模型二局限:实际情况双流之间时延可能较大、对齐较难,虽然能够使用补偿机制找回缺失数据,但是这样流加工任务主要角色会被弱化,同时会对补偿任务造成更大压力,数据时延会变大 。
流加工模型三(最终):
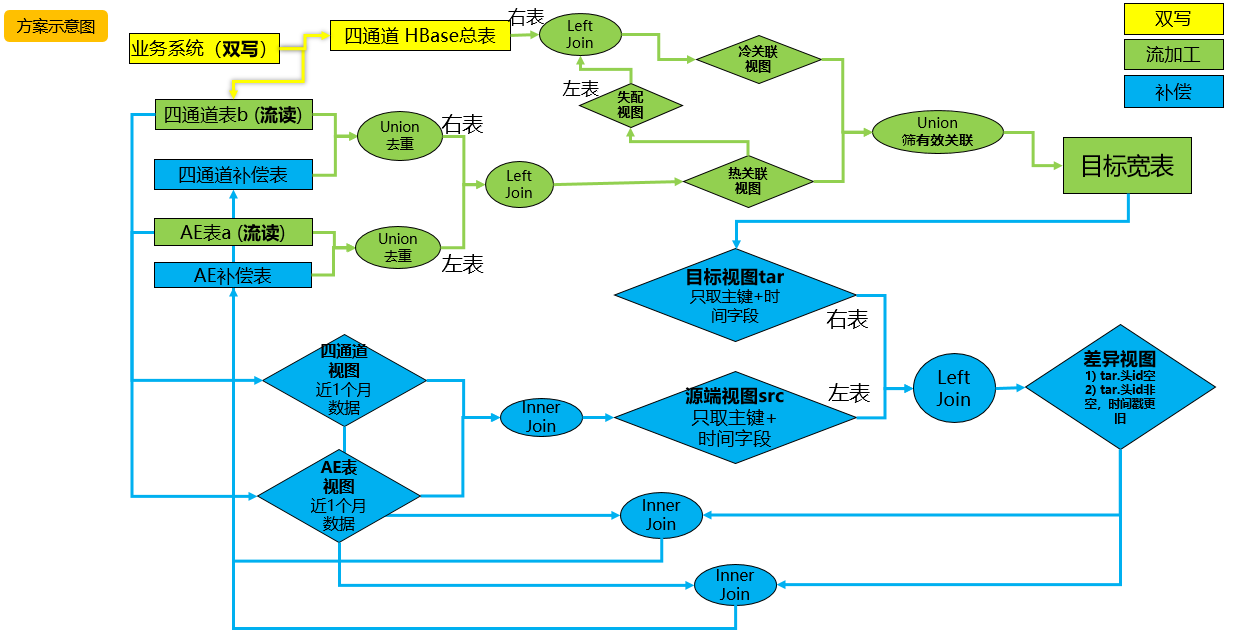
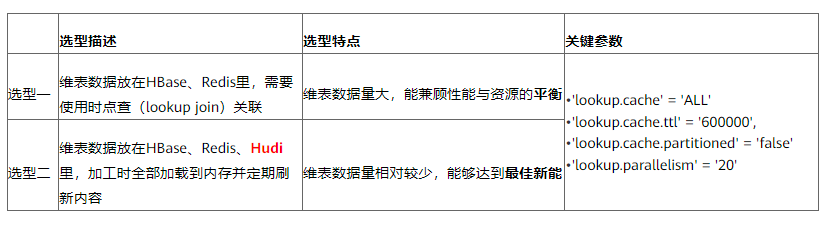
双写目的:业务系统持续向Hudi表,HBase表双写数据。Hudi表流读,提供主要热关联数据,HBase存储所有历史数据,技术上就是维度表,为热关联失败之后进行快速点查补数(lookup join)得到有效关联。提高双流关联的命中率。减少流加工整体数据时延。
维表选型:
模型总结:
MRS大企业ERP流程实时数据湖加工最佳实践的更多相关文章
- 移动App測试实战:顶级互联网企业软件測试和质量提升最佳实践
这篇是计算机类的优质预售推荐>>>><移动App測试实战:顶级互联网企业软件測试和质量提升最佳实践> 国内顶级互联网公司測试实战经验总结.阿里.腾讯.京东.携程.百 ...
- 【翻译】ScyllaDB数据建模的最佳实践
文章翻译自Scylla官方文档:https://www.scylladb.com/2019/08/20/best-practices-for-data-modeling/ 转载请注明出处:https: ...
- Salesforce 大量数据部署的最佳实践
本文参考自官方文档.原文链接 大量数据部署对Salesforce的影响 当用户需要在Salesforce中部署大量数据的时候,部署的过程往往会变慢.这时就需要架构师或开发者设计出更好的过程来提高大量数 ...
- Springboot 配置文件、隐私数据脱敏的最佳实践(原理+源码)
大家好!我是小富- 这几天公司在排查内部数据账号泄漏,原因是发现某些实习生小可爱居然连带着账号.密码将源码私传到GitHub上,导致核心数据外漏,孩子还是没挨过社会毒打,这种事的后果可大可小. 说起这 ...
- Mongo实战之数据空洞的最佳实践
问题背景: 某天,开发部的同事跑过来反映: mongodb数据文件太大,快把磁盘撑爆了!其中某个db占用最大(运营环境这个db的数据量其实很小) 分析: 开发环境有大量测试的增/删/改操作,而由于Mo ...
- Kafka数据迁移MaxCompute最佳实践
摘要: 本文向您详细介绍如何使用DataWorks数据同步功能,将Kafka集群上的数据迁移到阿里云MaxCompute大数据计算服务. 前提条件 搭建Kafka集群 进行数据迁移前,您需要保证自己的 ...
- 小白到大神,你需要了解的 sqlite 最佳实践
本文微信公众号「AndroidTraveler」首发. 背景 本文是对一篇英文文档的翻译,原文请见文末链接. 并发数据库访问 假设你实现了自己的 SQLiteOpenHelper. public cl ...
- 华为云FusionInsight MRS:助力企业构建“一企一湖,一城一湖”
摘要:华为云FusionInsight MRS新一代的数据湖,让大数据越用越快.越用越易.越用越稳.越用越省!让数据价值近在眼前! 10月30日,以"携手共赢·数创未来"为主题的第 ...
- Kafka ETL 之后,我们将如何定义新一代实时数据集成解决方案?
上一个十年,以 Hadoop 为代表的大数据技术发展如火如荼,各种数据平台.数据湖.数据中台等产品和解决方案层出不穷,这些方案最常用的场景包括统一汇聚企业数据,并对这些离线数据进行分析洞察,来达到辅助 ...
- 从 Delta 2.0 开始聊聊我们需要怎样的数据湖
盘点行业内近期发生的大事,Delta 2.0 的开源是最让人津津乐道的,尤其在 Databricks 官宣 delta2.0 时抛出了下面这张性能对比,颇有些引战的味道. 虽然 Databricks ...
随机推荐
- STM32 + ESP32(AT固件 MQTT协议) + MQTTX(桌面终端) + (EMQX消息服务器)
翻出老物件,搭建一个简单的 IOT 开发环境,也算是废物利用了 ,接下来加传感器.1. STM32 采集数据: RTOS. 资源相对比较丰富,可以根据项目需求定制.2. ESP32 ...
- 组合的输出 题解(lgP1157)
一看就是 dfs 然而窝并不会做 调了一个多小时才调出来.漏洞连篇.(第一次写的基本没有对的地方QAQ 题解见注释. #include<bits/stdc++.h> using names ...
- JS动态在父元素里追加元素——insertAdjacentHTML
insertAdjacentHTML() 方法将指定的文本解析为 Element 元素,并将结果节点插入到 DOM 树中的指定位置.它不会重新解析它正在使用的元素,因此它不会破坏元素内的现有元素.这避 ...
- JavsScript对密码进行Base64加密和Base64解密
const password = "hello"; // 进行Base64加密 let pwd64 = window.btoa(password); console.log(pwd ...
- C++基础杂记(1)
结构体中的位字段 共用体 烦人的枚举 枚举的声明与赋值 枚举的取值范围与强制类型转换 枚举的注意事项 指针 为什么是 int* ptr 而不是 int *ptr ? 避免危险的指针 使用array和v ...
- 从零实现的浏览器Web脚本
从零实现的浏览器Web脚本 在之前我们介绍了从零实现Chrome扩展,而实际上浏览器级别的扩展整体架构非常复杂,尽管当前有统一规范但不同浏览器的具体实现不尽相同,并且成为开发者并上架Chrome应用商 ...
- Java IO教程- Java文件
创建文件 我们可以从中创建一个 File 对象 路径名 父路径名和子路径名 URI(统一资源标识符) 我们可以使用File类的以下构造函数之一创建一个文件: File(String pathname) ...
- 【scipy 基础】--线性代数
SciPy的linalg模块是SciPy库中的一个子模块,它提供了许多用于线性代数运算的函数和工具,如矩阵求逆.特征值.行列式.线性方程组求解等. 相比于NumPy的linalg模块,SciPy的li ...
- re1-100
虽然关键的判断函数和"成功"的提示也在这里,但是具体对输入flag的操作却在后面 看到对数组bufParentRead[1]开始赋值"53fc275d81",b ...
- 从GPT定制到Turbo升级再到Assistants API,未来AI世界,你准备好了吗?
引言 在OpenAI DevDay发布会上,OpenAI再次震撼整个人工智能行业,为AI领域带来了重大的更新.CEO Sam Altman宣布推出了定制版本的ChatGPT,这意味着用户现在可以根据自 ...