
在模仿中精进数据分析与可视化01——颗粒物浓度时空变化趋势(Mann–Kendall Test)
本文是在模仿中精进数据分析与可视化系列的第一期——颗粒物浓度时空变化趋势(Mann–Kendall Test),主要目的是参考其他作品模仿学习进而提高数据分析与可视化的能力,如果有问题和建议,欢迎在评论区指出。若有其他想要看的作品,也欢迎在评论区留言并给出相关信息。
所用数据和代码的下载地址如下:
链接:https://pan.baidu.com/s/1IixHE9aPf1u9qFkdAdHQaA
提取码:hmq2
复制这段内容后打开百度网盘手机App,操作更方便哦
简介
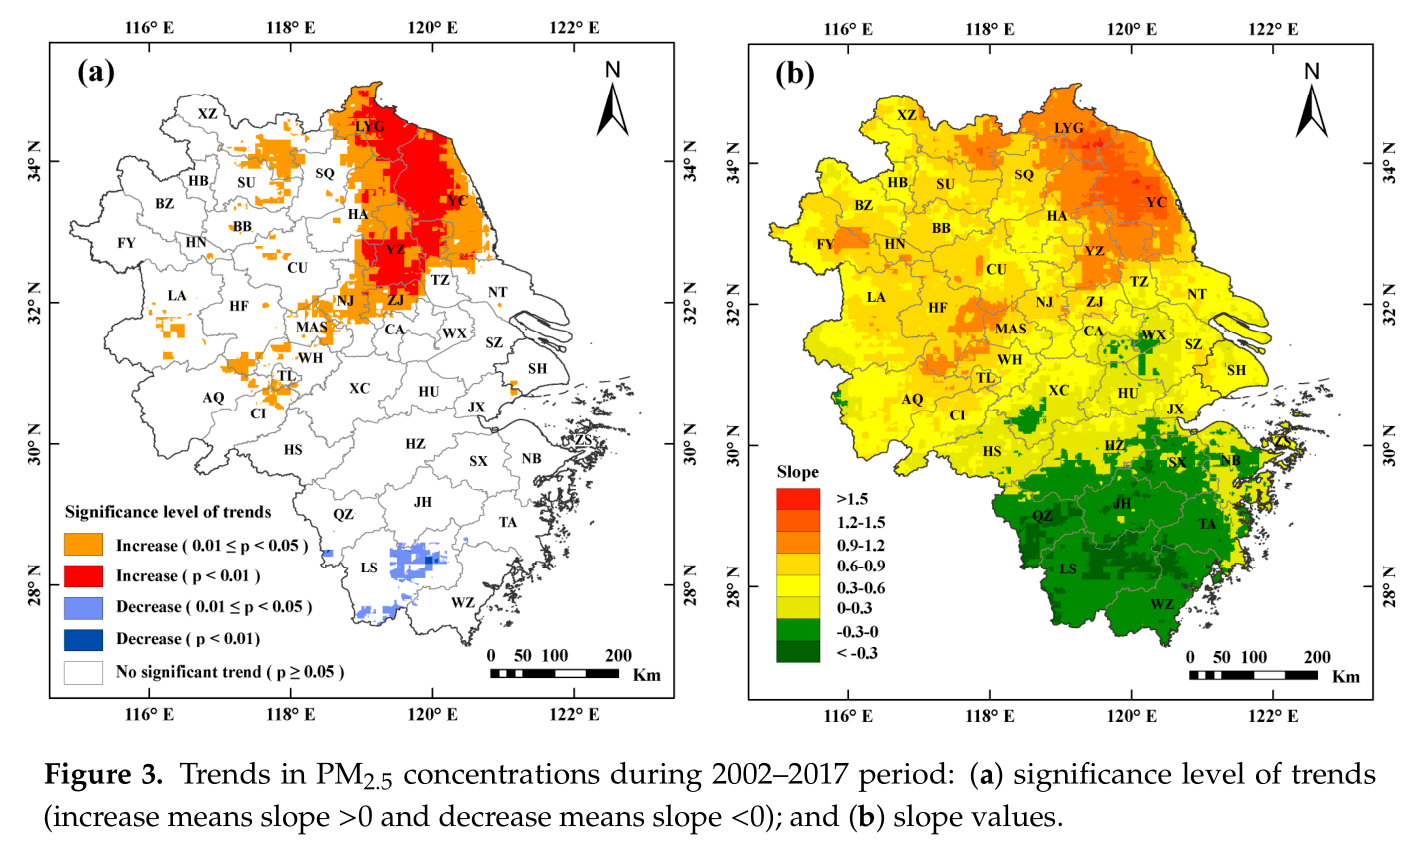
本次要模仿的作品来自论文Investigating the Impacts of Urbanization on PM2.5 Pollution in the Yangtze River Delta of China: A Spatial Panel Data Approach,研究区域为上海、安徽、浙江和江苏,所用数据为 2002–2017该区域PM2.5浓度栅格数据,数据来源于 Dalhousie University Atmospheric Composition Analysis Group开发的年均PM2.5数据集V4.CH.03,空间分辨率为0.01°×0.1°(原论文采用数据的空间分辨率为1km×1km,但我在该网站上找不到,可能是不提供下载了)。
数据下载和处理
数据下载格式为.asc,使用arcpy将其转为.tif格式,所用代码如下。
# -*- coding: utf-8 -*-

import arcpy

import os

inpath = "./ASCII" #待转换的栅格的存储路径,会转换该路径下的所有栅格

outpath = "./TIF" #输出栅格的路径,最好是空路径

filetype = "FLOAT"

print "Starting Convert!"

for filename in os.listdir(inpath):

    if filename.endswith(".asc"):

        filepath = os.path.join(inpath, filename)

        outfilepath = os.path.join(outpath, filename.replace(".asc", ".tif"))

        arcpy.ASCIIToRaster_conversion(filepath, outfilepath, filetype)

print "Convert Over!"
Mann–Kendall趋势分析
Mann–Kendall趋势分析的具体计算方法这里不再赘述,原文作者采用R语言的trend package计算的,本文采用python的pymannkendall计算,github项目地址为https://github.com/mmhs013/pyMannKendall。
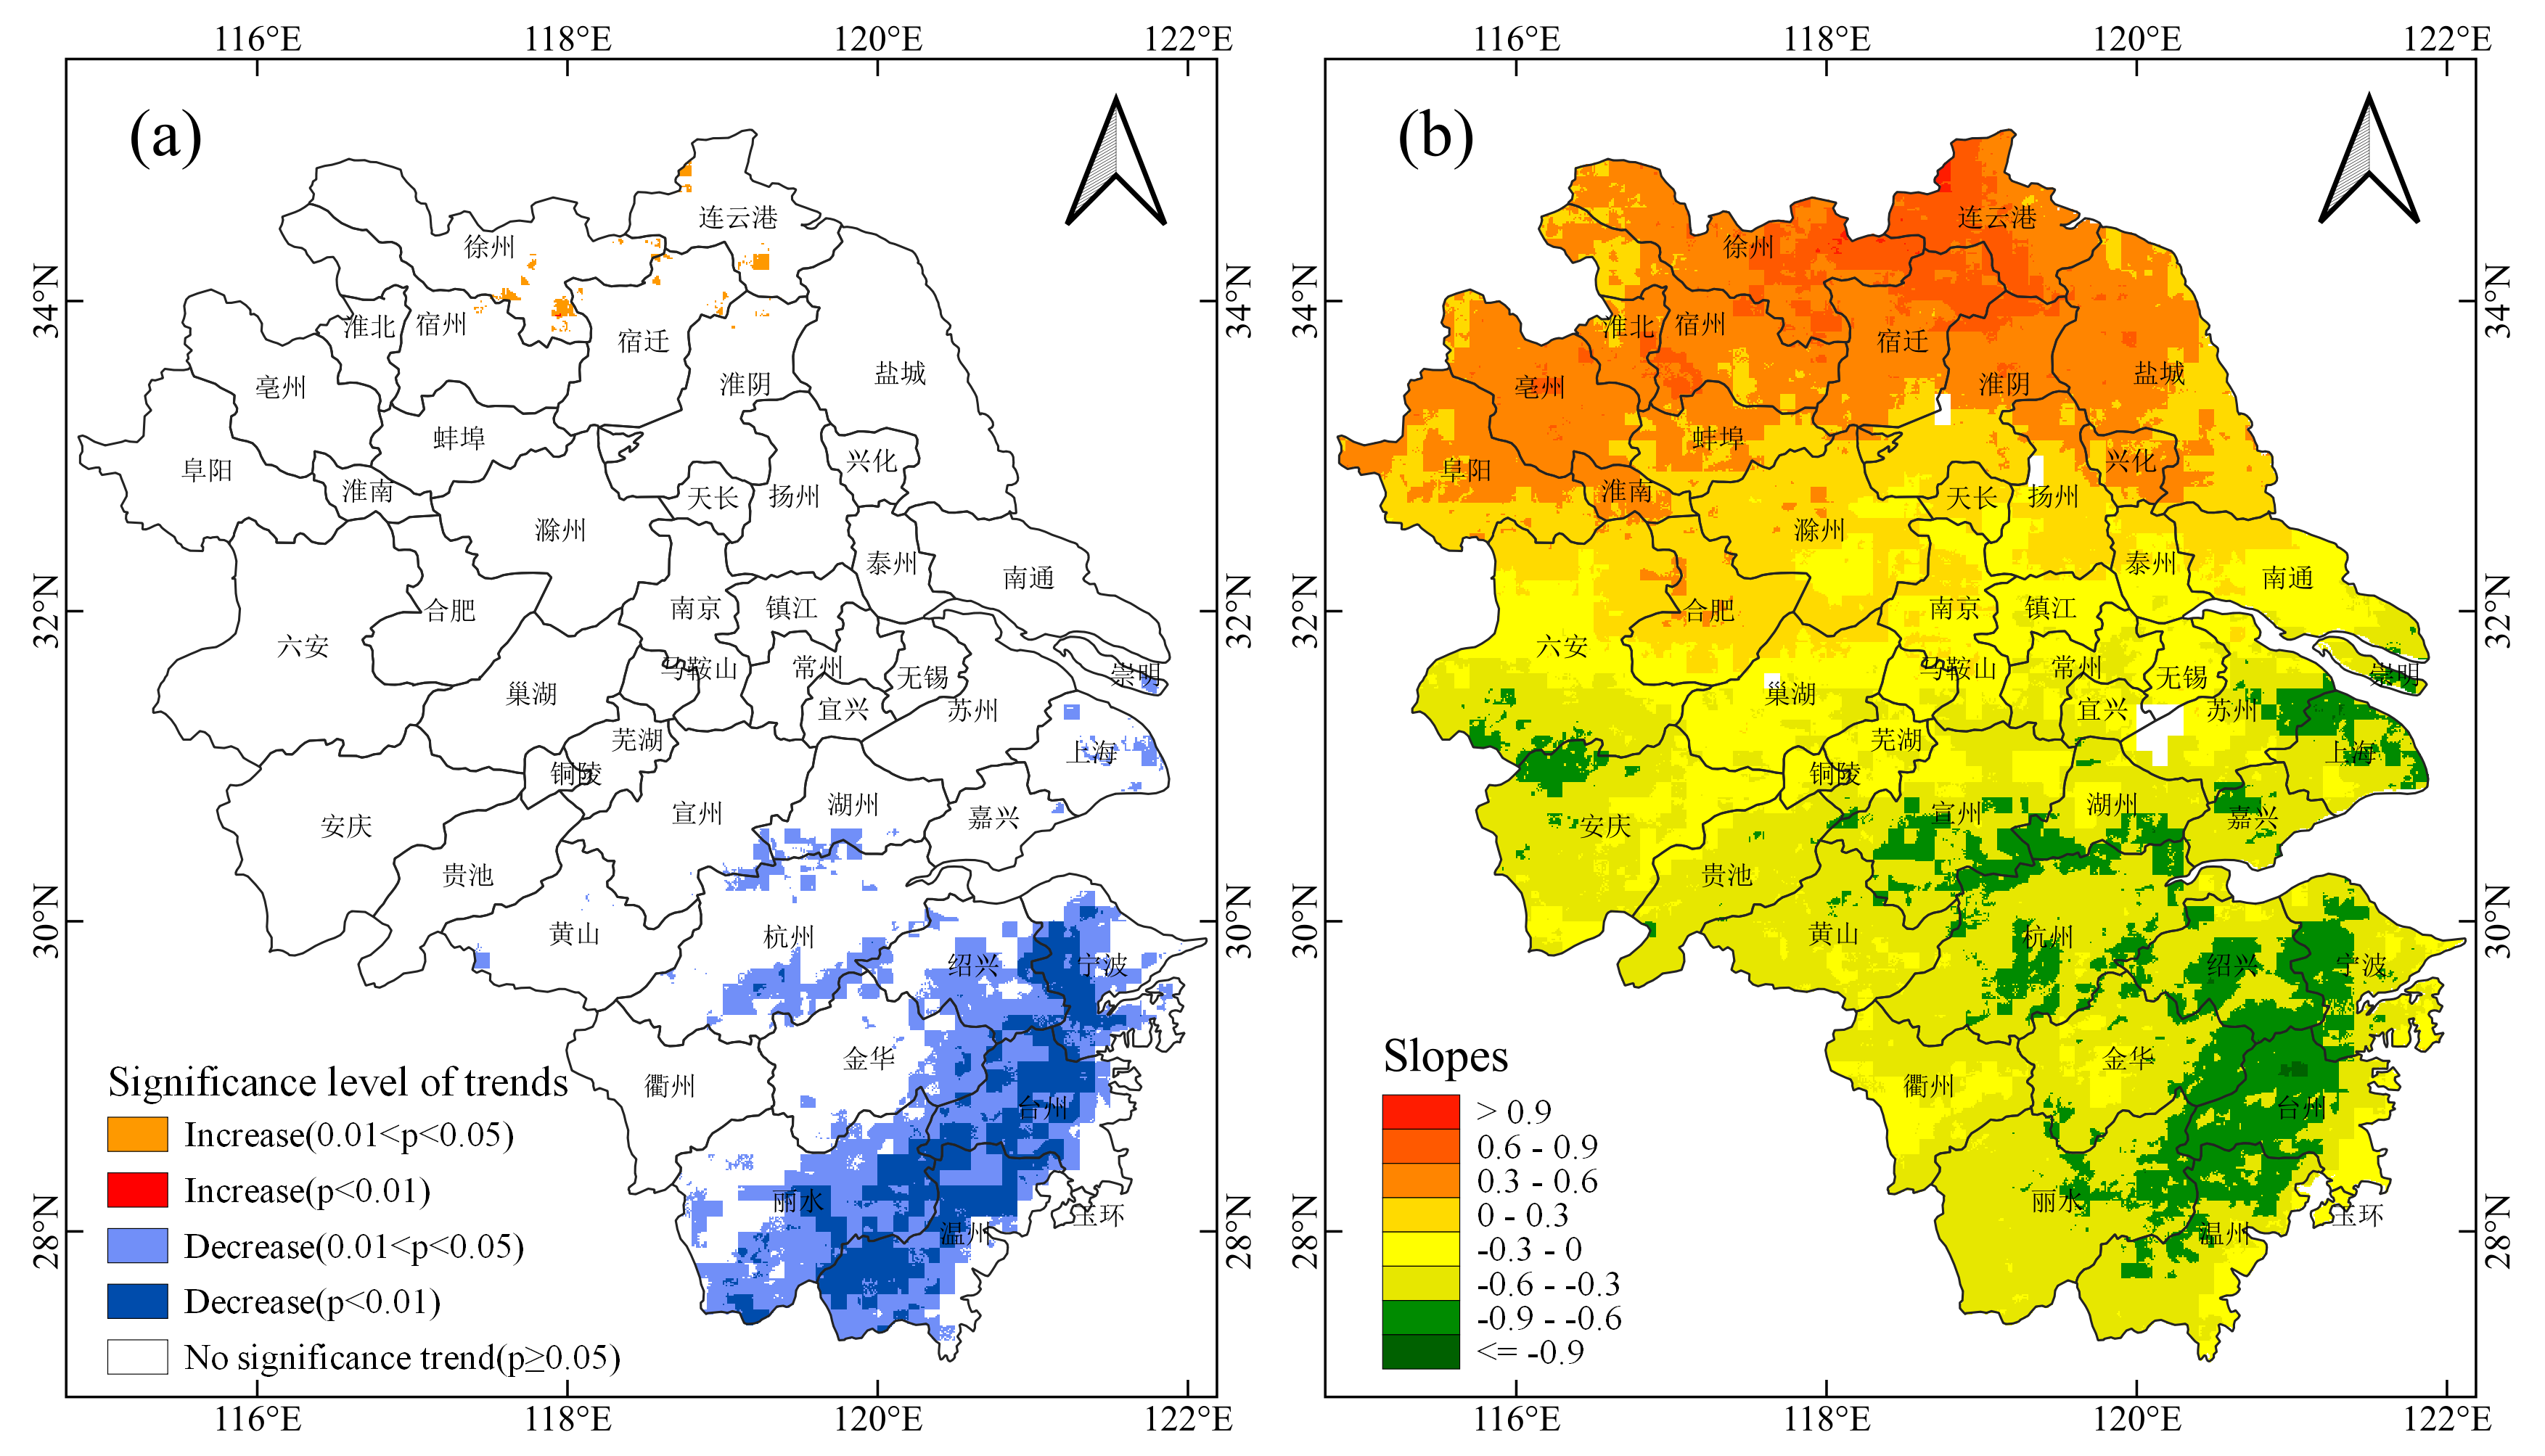
原文的趋势分析包括两部分,一部分是计算slope值,slope值为正,则表明具有上升的趋势,反之亦然;另一部分是计算p值,p值越小趋势越显著,0.01<p<0.05说明趋势显著,p<0.01说明趋势非常显著。二者分别采用pymannkendall的sens_slope和original_test函数计算,pymannkendall的简单用法介绍如下。
A quick example of pyMannKendall usage is given below. Several more examples are provided here.
import numpy as np

import pymannkendall as mk

# Data generation for analysis

data = np.random.rand(360,1)

result = mk.original_test(data)

print(result)
Output are like this:
Mann_Kendall_Test(trend='no trend', h=False, p=0.9507221701045581, z=0.06179991635055463, Tau=0.0021974620860414733, s=142.0, var_s=5205500.0, slope=1.0353584906597959e-05, intercept=0.5232692553379981)
Whereas, the output is a named tuple, so you can call by name for specific result:
print(result.slope)
or, you can directly unpack your results like this:
trend, h, p, z, Tau, s, var_s, slope, intercept = mk.original_test(data)
计算并保存结果
这里依然使用arcpy作为分析计算的工具,所用代码如下。
pymannkendall较为臃肿,计算速度很慢(全部计算用了十几分钟),并且暂不支持numba加速,有需要大量计算的可根据其源码重新编写函数,实现numba加速,如本文的get_slope函数,在使用numba加速后计算pvalues仅需4秒,使用pymannkendall的sens_test则需要几分钟的时间。
# -*- coding: utf-8 -*-

import arcpy

import os

from glob import glob

import numpy as np

import pymannkendall as mk

inpath = r"./TIF" #.tif文件的保存路径

p_path = r"./pvalues.tif" #p-values的输出路径

slope_path = r"./slopes.tif" #slopes的输出路径

trend_path = r"./trends.tif" #原图左图中不同的趋势

border_path = r"./Shapefiles/border.shp" #研究区域

# 获取2002-2017年的栅格数据的路径

def get_raster_paths(inpath):

    paths = []

    for year in range(2002, 2018):

        year_path = glob(os.path.join(inpath, "*"+str(year)+"*.tif"))

        if year_path:

            paths.append(year_path[0])

        else:

            print "can't find raster of {} year!".format(year)

    return paths

# 裁剪栅格,并将结果转为numpy数组

def clip_raster_to_array(paths, border):

    out_image = arcpy.sa.ExtractByMask(paths[0], border)

    # 掩膜提取

    x_cell_size, y_cell_size = out_image.meanCellWidth, out_image.meanCellHeight #x,y方向的像元大小

    ExtentXmin, ExtentYmin = out_image.extent.XMin, out_image.extent.YMin #取x,y坐标最小值

    lowerLeft = arcpy.Point(ExtentXmin, ExtentYmin) #取得数据起始点范围

    noDataValue = out_image.noDataValue #取得数据的noData值

    out_image = arcpy.RasterToNumPyArray(out_image) #将栅格转为numpy数组

    out_image[out_image==noDataValue] = np.NAN #将数组中的noData值设为nan

    arrays = np.full(shape=(len(paths), out_image.shape[0], out_image.shape[1]),

                     fill_value=np.NAN, dtype=out_image.dtype)

    arrays[0] = out_image

    for i in range(1, len(paths)):

        out_image = arcpy.sa.ExtractByMask(paths[i], border)

        out_image = arcpy.RasterToNumPyArray(out_image)

        out_image[out_image==noDataValue] = np.NAN

        arrays[i] = out_image

    return arrays, (lowerLeft, x_cell_size, y_cell_size, noDataValue)

def array_to_raster(path, data, rasterInfo):

    new_raster = arcpy.NumPyArrayToRaster(data, *rasterInfo) #数组转栅格

    new_raster.save(path) #保存栅格

# 计算slope值

def get_slope(x):

    if np.isnan(x).any():

        return np.NAN

    idx = 0

    n = len(x)

    d = np.ones(int(n*(n-1)/2))

    for i in range(n-1):

        j = np.arange(i+1,n)

        d[idx : idx + len(j)] = (x[j] - x[i]) / (j - i)

        idx = idx + len(j)

    return np.median(d)

# 计算p值

def get_pvalue(x):

    if np.isnan(x).any():

        return np.NAN

    result = mk.original_test(x)

    return result.p

paths = get_raster_paths(inpath)

arrays, rasterinfo = clip_raster_to_array(paths, border_path)

print "clip raster to array over!"

slopes = np.apply_along_axis(get_slope, 0, arrays)

print "calculate p-value over!"

pvalues = np.apply_along_axis(get_pvalue, 0, arrays)

print "calculate slope over!"

#计算有显著和非常显著趋势的区域

trends = np.full(shape=slopes.shape, fill_value=np.NaN)

trends[~np.isnan(slopes)] = 0 #不显著的区域设为0

trends[(slopes>0) & ((0.01<pvalues) & (pvalues<0.05))] = 1 #比较显著增加的区域设为1

trends[(slopes>0) & (pvalues<0.01)] = 2 #显著增加的区域设为2

trends[(slopes<0) & ((0.01<pvalues) & (pvalues<0.05))] = 3 #比较显著减少的区域设为3

trends[(slopes<0) & (pvalues<0.01)] = 4 #显著减少的区域设为4

# 保存栅格

array_to_raster(p_path, pvalues, rasterinfo)

array_to_raster(slope_path, slopes, rasterinfo)

array_to_raster(trend_path, trends, rasterinfo)

print "save rasters over!"
结果绘图
由于QGIS软件打开和一些相关操作的速度都要比ArcGIS快的多,而且QGIS内置的取色器的功能也方便绘图时设置颜色,因此本文使用QGIS绘制结果图,如下图所示。
在模仿中精进数据分析与可视化01——颗粒物浓度时空变化趋势(Mann–Kendall Test)的更多相关文章
- (在模仿中精进数据可视化05)疫情期间市值增长top25公司
本文完整代码及数据已上传至我的Github仓库https://github.com/CNFeffery/FefferyViz 1 简介 新冠疫情对很多实体经济带来冲击的同时,也给很多公司带来了新的增长 ...
- (在模仿中精进数据可视化03)OD数据的特殊可视化方式
本文完整代码已上传至我的Github仓库https://github.com/CNFeffery/FefferyViz 1 简介 OD数据是交通.城市规划以及GIS等领域常见的一类数据,特点是每一条数 ...
- (数据科学学习手札78)基于geopandas的空间数据分析——基础可视化
本文对应代码和数据已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 通过前面的文章,我们已经对geopanda ...
- 数据分析 | 数据可视化图表,BI工具构建逻辑
本文源码:GitHub·点这里 || GitEE·点这里 一.数据可视化 1.基础概念 数据可视化,是关于数据视觉表现形式的科学技术研究.其中,这种数据的视觉表现形式被定义为,一种以某种概要形式抽取出 ...
- Cytoscape.js – 用于数据分析和可视化的交互图形库
Cytoscape.js 是一个开源的 JavaScript 图形库,您可以使用 Cytoscape.js 进行数据分析和可视化.Cytoscape.js 可以轻松的继承到你的网站或者 Web 应用 ...
- 2017 年 机器学习之数据挖据、数据分析,可视化,ML,DL,NLP等知识记录和总结
今天是2017年12月30日,2017年的年尾,2018年马上就要到了,回顾2017过的确实很快,不知不觉就到年末了,再次开篇对2016.2017年的学习数据挖掘,机器学习方面的知识做一个总结,对自己 ...
- python中利用matplotlib绘图可视化知识归纳
python中利用matplotlib绘图可视化知识归纳: (1)matplotlib图标正常显示中文 import matplotlib.pyplot as plt plt.rcParams['fo ...
- Simulink--MATLAB中的一种可视化仿真工具
Simulink是MATLAB中的一种可视化仿真工具, 是一种基于MATLAB的框图设计环境,是实现动态系统建模.仿真和分析的一个软件包,被广泛应用于线性系统.非线性系统.数字控制及数字信号处理的建 ...
- Pytorch在colab和kaggle中使用TensorBoard/TensorboardX可视化
在colab和kaggle内核的Jupyter notebook中如何可视化深度学习模型的参数对于我们分析模型具有很大的意义,相比tensorflow, pytorch缺乏一些的可视化生态包,但是幸好 ...
随机推荐
- 子域名探测工具Aquatone的使用
目录 Aquatone Aquatone的安装 Aquatone的使用 子域名爆破 端口扫描
- Caddy-基于go的微型serve用来做反向代理和Gateway
1.简单配置 2.go实现,直接一个二进制包,没依赖. 3.默认全站https 常用 反向代理,封装多端口gateway 使用:启动直接执行二进制文件 caddy 就行 根据输出信息 直接https: ...
- 3-5年以上的Android原生开发如何深入进阶?高级工程师必须要掌握哪些?
前言 曾听过很多人说Android学习很简单,做个App就上手了,工作机会多,毕业后也比较容易找工作.这种观点可能是很多Android开发者最开始入行的原因之一. 在工作初期,工作主要是按照业务需求实 ...
- 记录数据库被攻击.md
昨天的数据库还是正常的,早上想连接mysql,一直报错1045,最后才发现数据库被攻击了 navicat连接mysql疯狂报错1045 因为1045的报错,一般都是密码设置的问题,但是我怎么修改也没有 ...
- CMMI V2.0丨如何通过CMMI真正在企业中的实施规模化敏捷开发
在过去的几年中,敏捷开发已经从一个利基概念(利基是指针对企业的优势细分出来的市场,这个市场不大,而且没有得到令人满意的服务.产品推进这个市场,有盈利的基础.)转变为全球许多大公司采用的标准实践. 通过 ...
- [MySQL数据库之事务、读现象、数据库锁机制、多版本控制MVCC、事务隔离机制]
[MySQL数据库之事务.读现象.数据库锁机制.多版本控制MVCC.事务隔离机制] 事务 1.什么是事务: 事务(Transaction),顾名思义就是要做的或所做的事情,数据库事务指的则是作为单个逻 ...
- MSSQL·将一对多的数据合并为以指定分隔符的数据
阅文时长 | 0.05分钟 字数统计 | 142.4字符 主要内容 | 1.引言&背景 2.Stuff函数语法&模拟场景 3.声明与参考资料 『MSSQL·将一对多的数据合并为以指定分 ...
- 啥?SynchronousQueue和钟点房一个道理
今天这篇文章,我们继续讲架构师大刘的故事. 大刘有段时间经常会给一些程序员讲课.这一方面是由于团队培训的需要,一方面也是大刘自身想搞搞凡尔赛,嘚瑟一下自身的实力. 大刘讲课是允许公司任何一个人进去听的 ...
- webpack解析(1)
webpack是为现代js程序准备的静态模块打包工具 一:关于对webpack的理解 可以将其认为是一个电脑主板,由于使用js作为源码,因而其可以默认编译js代码(别种类型的文件可以依靠loaders ...
- 用JIRA管理你的项目——(一)JIRA环境搭建
JIRA,大家应该都已经不陌生了! 最初接触这个工具的时候,我还在一味地单纯依靠SVN管理代码,幻想着SVN可以有个邮件通知,至少在项目成员进行代码修改的时候,我可以第一时间通过邮件获得这个消息! 当 ...