
论文阅读笔记十九:PIXEL DECONVOLUTIONAL NETWORKS(CVPR2017)
论文源址:https://arxiv.org/abs/1705.06820
tensorflow(github): https://github.com/HongyangGao/PixelDCN
基于PixelDCL分割实验:https://github.com/fourmi1995/IronsegExperiment-PixelDCL
摘要
反卷积被广泛用于深度学习的上采样过程中,包括语义分割的编码-解码网络与无监督学习的深度生成网络。反卷积的一个缺点是生成的特征图类似于棋盘状,相邻元素之间的关系无法较好的确定。为解决此问题,该文提出PixelDCL层,用于建立上采样输出的feature map中相邻像素之间的联系。该文对常规的反卷积进行重新解释。该网络可以应用于其他网络中,同时,并不会增加网络学习的参数量,其分割性能在准确率上会有所损失,但可以通过一些调参技巧进行克服。实验发现PixelDCL层相比常规的反卷积层,可以获得更多的形状及边等空间信息,进而得到更好的分割效果。
说明
通过反卷积实现上采样得到的feature map可以看作是通过独立的卷积核对多个隐藏层的feature map阶段性混合运算的结果。因此,feature map中相邻像素之间没有直接联系,从而产生“棋盘”问题。针对此问题,该文提出Pixel DCL层神经网络层,在这一层网络中的feature map是连续生成的,因此,后面生成的feature map依赖于先前生成的feature map,通过这种方式,建立起相邻像素之间直接联系.PixelDCL与基于概率密度评估的自恢复方法(PixelRNNs,PixelCNNs)相比,训练速度要快很多。虽然在PixelDCL中会有部分计算性能上的降低,但可以通过调参等技巧进行改善。

方法
反卷积:1D,2D卷积图如下,标准的反卷积操作可以分解为几个依赖于上采样因子的卷积操作。本文默认上采样因子为2。
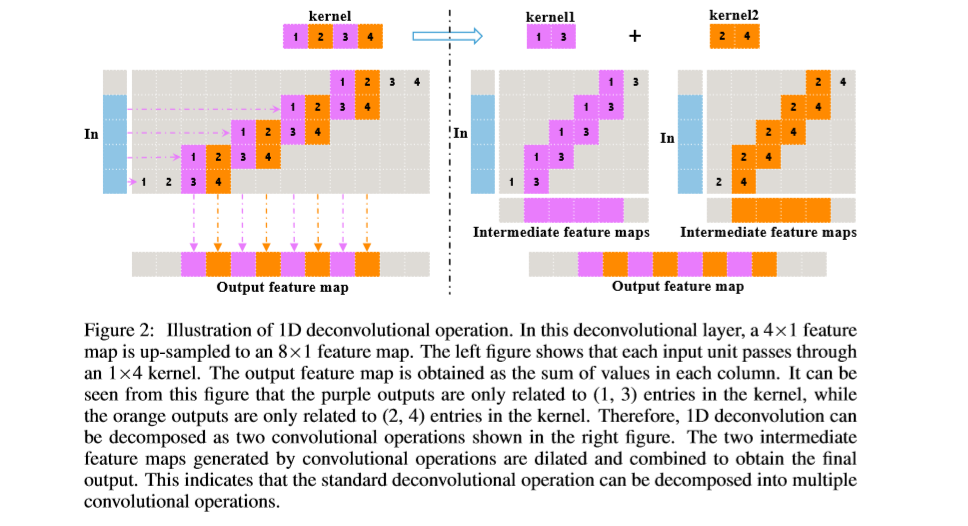

通过如下操作可以计算得到上采样的输出,
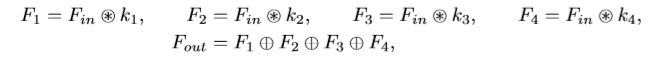
 代表卷积操作,
 代表阶段性的混搭操作,在常规的反卷积中,由于中间的feature map是由独立的卷积核得到的,因此中间过程的feature map像素中没有直接关联的信息。由于,相邻两个像素可能来自不同的卷积核的结果,因此,像素值会有所不同,进而会产生“棋盘”现象。如下图,通过后处理的方法进行平滑操作会造成额外的计算资源的消耗,增加网络的复杂度,同时无法进行end-to-end的训练。该文通过添加PixelDCL层给中间隐层feature map添加依赖信息。
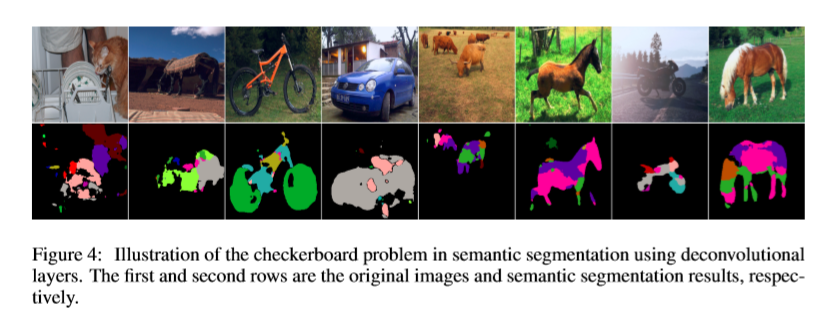 像素级反卷积层:
由于常规反卷积操作得到的feature map中相邻像素来自不同卷积核得到的feature map,之间并无关联,该文提出PixelDCL,用于建立不同中间隐层特征的关联。中间隐层特征图是按序列生成,而不是同时生成。后一个feature map的生成依赖与上一个feature map的生成。PixelDCL的操作过程如下
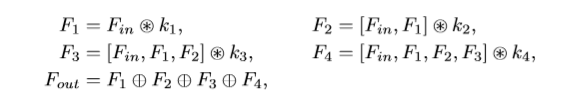
后期生成的feature map可以依赖于前面部分或者全部的feature maps。
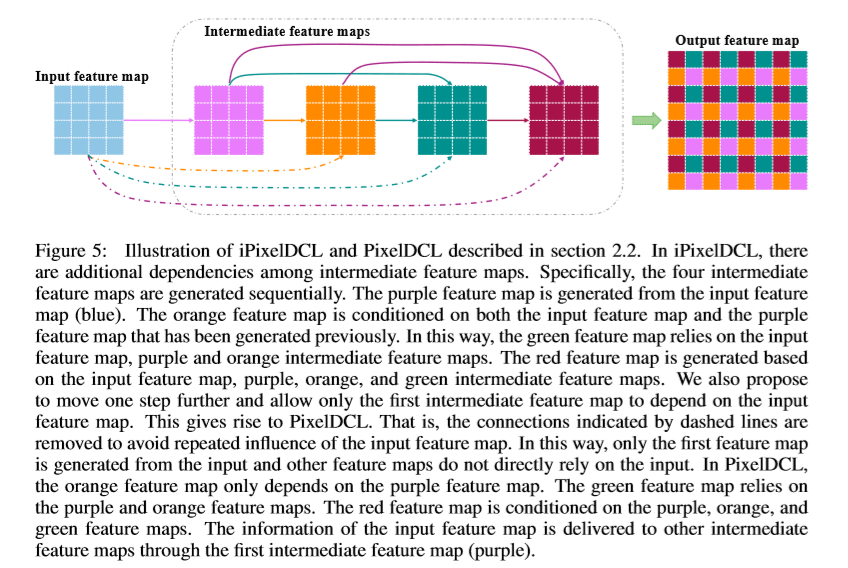
由于输入的feature map被重复利用,降低了计算的性能。因此,进行改进,使输入的feature map只与第一个feature map相关。操作过程如下:

像素级反卷积网络:

实验
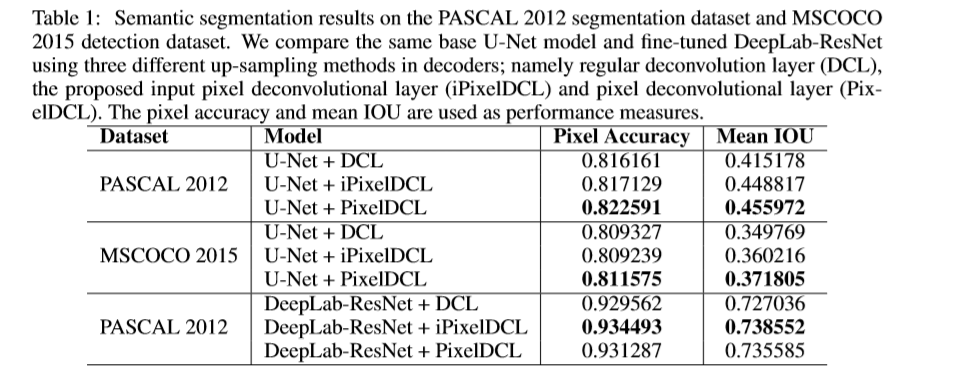
图像分割


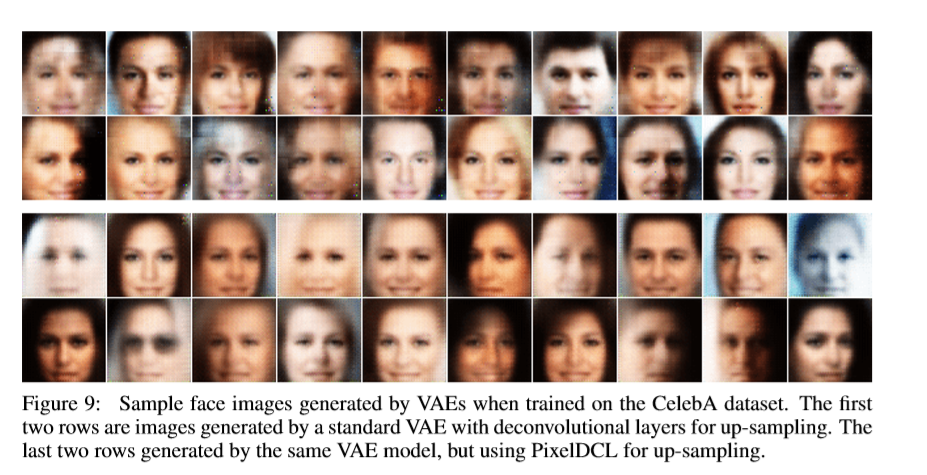
图像生成
时间比较

Reference
[1] Liang-Chieh Chen, George Papandreou, Iasonas Kokkinos, Kevin Murphy, and Alan L Yuille. Deeplab: Semantic image segmentation with deep convolutional nets, atrous convolution, and fully connected crfs. arXiv:1606.00915, 2016.
[2] Mark Everingham, Luc Van Gool, Christopher KI Williams, John Winn, and Andrew Zisserman. The pascal visual object classes (voc) challenge. International journal of computer vision, 88(2): 303–338, 2010.
[3] Mathieu Germain, Karol Gregor, Iain Murray, and Hugo Larochelle. Made: Masked autoencoder for distribution estimation. In Proceedings of The 32nd International Conference on Machine Learning, pp. 881–889, 2015.
论文阅读笔记十九:PIXEL DECONVOLUTIONAL NETWORKS(CVPR2017)的更多相关文章
- 论文阅读笔记(二十一)【CVPR2017】:Deep Spatial-Temporal Fusion Network for Video-Based Person Re-Identification
Introduction (1)Motivation: 当前CNN无法提取图像序列的关系特征:RNN较为忽视视频序列前期的帧信息,也缺乏对于步态等具体信息的提取:Siamese损失和Triplet损失 ...
- 论文阅读笔记十八:ENet: A Deep Neural Network Architecture for Real-Time Semantic Segmentation(CVPR2016)
论文源址:https://arxiv.org/abs/1606.02147 tensorflow github: https://github.com/kwotsin/TensorFlow-ENet ...
- 论文阅读笔记十六:DeconvNet:Learning Deconvolution Network for Semantic Segmentation(ICCV2015)
论文源址:https://arxiv.org/abs/1505.04366 tensorflow代码:https://github.com/fabianbormann/Tensorflow-Decon ...
- 论文阅读笔记十五:Pyramid Scene Parsing Network(CVPR2016)
论文源址:https://arxiv.org/pdf/1612.01105.pdf tensorflow代码:https://github.com/hellochick/PSPNet-tensorfl ...
- 论文阅读笔记十四:Decoupled Deep Neural Network for Semi-supervised Semantic Segmentation(CVPR2015)
论文链接:https://arxiv.org/abs/1506.04924 摘要 该文提出了基于混合标签的半监督分割网络.与当前基于区域分类的单任务的分割方法不同,Decoupled 网络将分割与分类 ...
- 论文阅读笔记十:DeepLab: Semantic Image Segmentation with Deep Convolutional Nets, Atrous Convolution, and Fully Connected CRFs (DeepLabv2)(CVPR2016)
论文链接:https://arxiv.org/pdf/1606.00915.pdf 摘要 该文主要对基于深度学习的分割任务做了三个贡献,(1)使用空洞卷积来进行上采样来进行密集的预测任务.空洞卷积可以 ...
- 论文阅读笔记六十一:Selective Kernel Networks(SKNet CVPR2019)
论文原址:https://arxiv.org/pdf/1903.06586.pdf github: https://github.com/implus/SKNet 摘要 在标准的卷积网络中,每层网络中 ...
- 论文阅读笔记(九)【TIFS2020】:True-Color and Grayscale Video Person Re-Identification
Introduction (1)Motivation:在现实场景中,摄像头会因为故障呈现灰白色,或者为了节省视频的存储空间而人工设置为灰白色.灰度图像(grayscale images)由8位存储,而 ...
- 论文阅读笔记十二:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation(DeepLabv3+)(CVPR2018)
论文链接:https://arxiv.org/abs/1802.02611 tensorflow 官方实现: https: //github.com/tensorflow/models/tree/ma ...
随机推荐
- 【Convex Optimization (by Boyd) 学习笔记】Chapter 1 - Mathematical Optimization
以下笔记参考自Boyd老师的教材[Convex Optimization]. I. Mathematical Optimization 1.1 定义 数学优化问题(Mathematical Optim ...
- openstack-----各种系统镜像制作
本章内容 1.centos镜像制作 2.windows镜像制作 3.ubunt镜像制作 一.centos7镜像制作 1.检查系统是否支持kvm: egrep "(vmx|svm)&q ...
- OsWatcher 使用详解
软件下载地址: https://support.oracle.com/epmos/faces/DocumentDisplay?_afrLoop=520996062954556&id=30113 ...
- 原子类型的使用&Unsafe&CAS
在项目中也经常可以见到原子类型(AtomicXXX)的使用,而且AtomicXXX常用来代替基本类型或者基本类型的包装类型,因为其可以在不加同步锁的情况下保证线程安全(只对于原子操作). 下面以Ato ...
- python 导入numpy 导致多进程绑定同一个CPU问题解决方法
python 如果有导入numpy模块的import语句,会导致默认将多进程程序的每个进程都绑定到同一个CPU core上, 失去了多进程在多核CPU上的性能优越性,这和CPU affinity(CP ...
- 学习基础和C语言基础调查
学习基础和C语言基础调查 一.一种比大多数人(超过90%以上)更好的技能 说句实话,我还没有那种特别特别自信的.说我能拿得出手的.所谓能超过百分之九十以上的人的技能.毕竟人外有人,天外有天. 姑且算上 ...
- requests支持socks5代理了
记录下 以前: import socket import socks from requests_html import HTMLSession session=HTMLSession() socks ...
- python 之路,Day 1 python基础 之 课后随笔
首先是抱着被忽悠的心态,购买了老男孩的什么什么什么(你懂得!!),开始了一周一堂课时的听,然后就是做,自己的博客,首先附上整理的内容吧. 1day .... 一. Hell world 程序 在lin ...
- NTSC、PAL、SECAM三大制式简介
NTSC.PAL.SECAM三大制式简介 NTSC.PAL和SECAM是全球三大主要的电视广播制式,这三种制式是不能互相兼容的,例如在PAL制式的电视上播放NTSC的视频,则影像画面将不能正常显示.下 ...
- 浏览器开启桌面通知Web Notification
本文主要描述如何开启各个浏览器的桌面通知功能 一.谷歌浏览器(chrome) 点击地址栏前面的图标