
Hive中笔记 :三种去重方法,distinct,group by与ROW_Number()窗口函数
一、distinct,group by与ROW_Number()窗口函数使用方法
1. Distinct用法:对select 后面所有字段去重,并不能只对一列去重。
(1)当distinct应用到多个字段的时候,distinct必须放在开头,其应用的范围是其后面的所有字段,而不只是紧挨着它的一个字段,而且distinct只能放到所有字段的前面
(2)distinct对NULL是不进行过滤的,即返回的结果中是包含NULL值的
(3)聚合函数中的DISTINCT,如 COUNT( ) 会过滤掉为NULL 的项
2.group by用法:对group by 后面所有字段去重,并不能只对一列去重。
3. ROW_Number() over()窗口函数
注意:ROW_Number() over (partition by id order by time DESC) 给每个id加一列按时间倒叙的rank值,取rank=1
select m.id,m.gender,m.age,m.rank
from (select id,gender,age,ROW_Number() over(partition by id order by id) rank
from temp.control_201804to201806
where id!='NA' and gender!='' or age!=''
) m
where m.rank=1
二、案例:
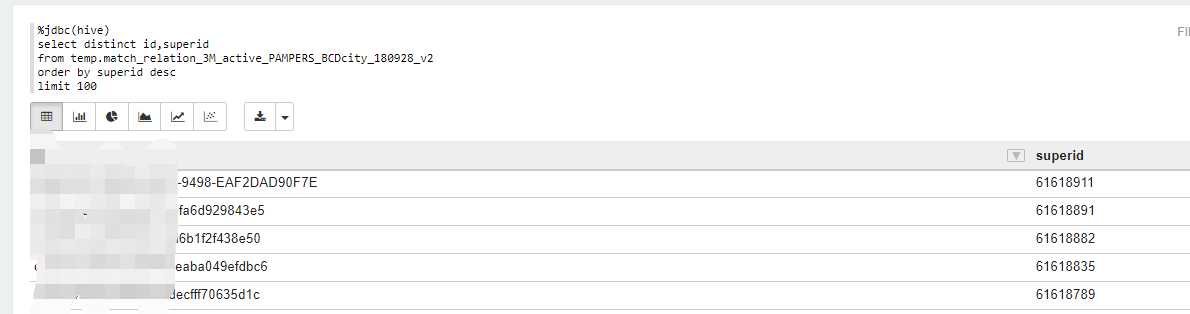
1.表中有两列:id ,superid,按照superid倒序排序选出前100条不同的id,如下:
1.方案一:
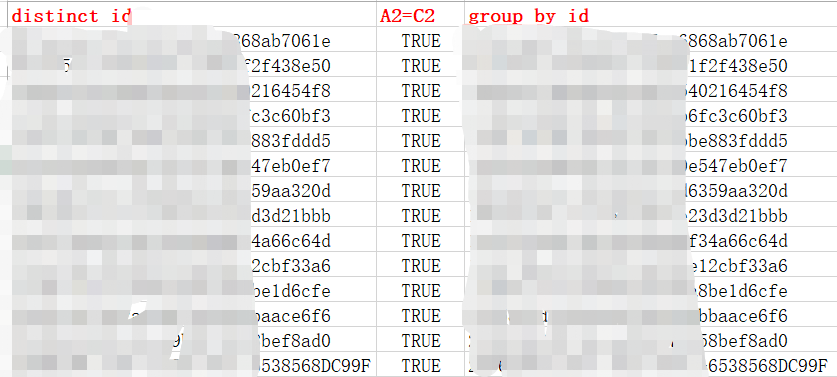
子查询中对id,superid同时去重,可能存在一个id对应的superid不同,id这一列有重复的id,但 是结果只需要一列不同的id,如果时不限制数量,则可以选择这种方法
方案二:
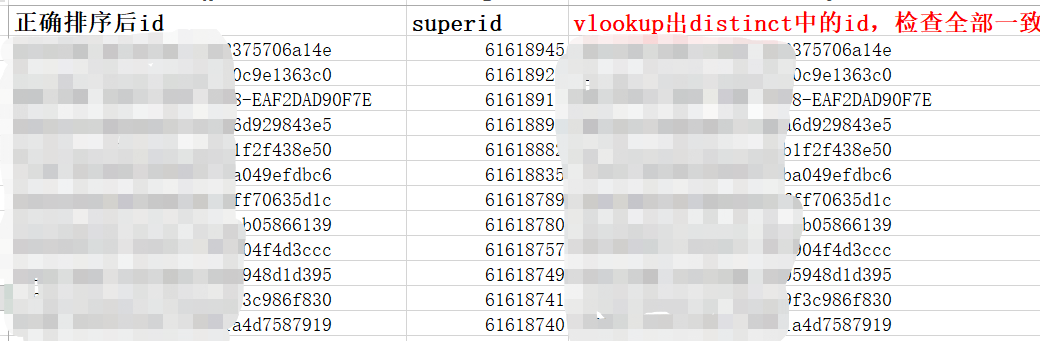
因为要求按照superid倒序排序选出,而一个id对应的superid不同,必有大有小,选出最大的那一个,即可。 同理若是按照superid正序排列,可以选出最小的一列
方案三:
首先利用窗口函数ROW_Number() over()窗口函数对id这一列去重,不能用distinct或者group by对id,superid同时去重

Hive中笔记 :三种去重方法,distinct,group by与ROW_Number()窗口函数的更多相关文章
- 061 hive中的三种join与数据倾斜
一:hive中的三种join 1.map join 应用场景:小表join大表 一:设置mapjoin的方式: )如果有一张表是小表,小表将自动执行map join. 默认是true. <pro ...
- JS中的五种去重方法
JS中的五种去重方法 第一种方法: 第二种方法: 第三种方法: 第四种方法: 第五种方法:优化遍历数组法 思路:获取没重复的最右一值放入新数组 * 方法的实现代码相当酷炫,* 实现思路:获取没重复的 ...
- SuperDiamond在JAVA项目中的三种应用方法实践总结
SuperDiamond在JAVA项目中的三种应用方法实践总结 1.直接读取如下: @Test public static void test_simple(){ PropertiesConfigur ...
- Hive中的三种不同的数据导出方式介绍
问题导读:1.导出本地文件系统和hdfs文件系统区别是什么?2.带有local命令是指导出本地还是hdfs文件系统?3.hive中,使用的insert与传统数据库insert的区别是什么?4.导出数据 ...
- js oop中的三种继承方法
JS OOP 中的三种继承方法: 很多读者关于js opp的继承比较模糊,本文总结了oop中的三种继承方法,以助于读者进行区分. <继承使用一个子类继承另一个父类,子类可以自动拥有父类的属性和方 ...
- java数组中的三种排序方法中的冒泡排序方法
我记得我大学学java的时候,怎么就是搞不明白这三种排序方法,也一直不会,现在我有发过来学习下这三种方法并记录下来. 首先说说冒泡排序方法:冒泡排序方法就是把数组中的每一个元素进行比较,如果第i个元素 ...
- Hive总结(八)Hive数据导出三种方式
今天我们再谈谈Hive中的三种不同的数据导出方式. 依据导出的地方不一样,将这些方式分为三种: (1).导出到本地文件系统. (2).导出到HDFS中: (3).导出到Hive的还有一个表中. 为了避 ...
- hive 数据导出三种方式
今天我们再谈谈Hive中的三种不同的数据导出方式.根据导出的地方不一样,将这些方式分为三种:(1).导出到本地文件系统:(2).导出到HDFS中:(3).导出到Hive的另一个表中.为了避免单纯的文字 ...
- Jquery中each的三种遍历方法
Jquery中each的三种遍历方法 $.post("urladdr", { "data" : "data" }, function(dat ...
随机推荐
- Java 并发编程-NIO 简明教程
问题来源 在传统的架构中,对于客户端的每一次请求,服务器都会创建一个新的线程或者利用线程池复用去处理用户的一个请求,然后返回给用户结果,这样做在高并发的情况下会存在非常严重的性能问题:对于用户的每一次 ...
- Go中iota是什么
Go iota是一个比较奇怪的存在,它只能用在const的申明中,是一个从0开始的行数索引器. 看代码 package main import ( "fmt" ) const ( ...
- python 加密算法及其相关模块的学习(hashlib,random,string,math)
加密算法介绍 一,HASH Hash,一般翻译做“散列”,也有直接音译为”哈希”的,就是把任意长度的输入(又叫做预映射,pre-image),通过散列算法,变换成固定长度的输出,该输出就是散列值.这种 ...
- NPOI导出EXCEL报_服务器无法在发送 HTTP 标头之后追加标头
虽然发表了2篇关于NPOI导出EXCEL的文章,但是最近再次使用的时候,把以前的代码粘贴过来,居然报了一个错误: “服务器无法在发送 HTTP 标头之后追加标头” 后来也查询了很多其他同学的文章,都没 ...
- C#序列化与反序列化。
序列化介绍: 把对象用一种新的格式来表示. 系列化只序列化数据. 序列化不建议使用自动属性 为什么要序列化: 将一个复杂的对象转换流,方便存储与信息交换. class Program { static ...
- C#爬虫----Fiddler 插件开发 自动生成代码
哈喽^_^ 一般我们在编写网页爬虫的时候经常会使用到Fiddler这个工具来分析http包,而且通常并不是分析一个包就够了的,所以为了把更多的时间放在分析http包上,自动化生成封包代码就尤为重要了( ...
- 《Office 365开发入门指南教程》正式上线,限时优惠和邀请分享推广
我很高兴地通知大家,<Office 365 开发入门指南教程>已经正式在网易云课堂上线,你可以通过直接访问 https://aka.ms/office365devlesson 这个短地址 ...
- .Net C# 使用Redis
Redis是一个开源的使用ANSI C语言编写.支持网络.可基于内存亦可持久化的日志型.Key-Value数据库,并提供多种语言的API.从2010年3月15日起,Redis的开发工作由VMware主 ...
- 浅谈Token理解运用
周末没带电脑,闲着也是闲着,出来分享一点东西,也当自己学习和巩固了. 今天分享一下Token的理解,首先Token的定义是什么? 概念 Token被翻译成为('令牌','标记')在计算机中的含义也差不 ...
- [日常] HTTP的缓存
web缓存: 1.可以自动保存常见文档副本的HTTP设备,当web请求抵达缓存时,如果存在缓存副本,就直接从本地存储设备返回,而不是去源服务器获取 2.缓存命中和未命中 3.HTTP再验证,检测服务器 ...