
本地spark下保存rdd为文件
写随笔大概也是做笔记记录下自己思考的意思吧,之前有些事情觉得做随笔还是比较有用的,mark一下一个有用的网址
关于rdd的操作,网上有很多很多的教程,当初全部顺一遍,除了对rdd这个类型有了点概念,剩下具体的方法以及方法的写法已经快忘记了,所以具体还是记一下对某些事情的思考吧。
关于将rdd保存为文件,我使用的是
import org.apache.spark.{SparkConf, SparkContext}

object Wordcount {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setAppName("wordcount").setMaster("local")

    val sc=new SparkContext(conf)

    val rdd1 = sc.parallelize(List(("tom", 1), ("jerry", 3), ("kitty", 2)))

    val rdd2 = sc.parallelize(List(("jerry", 2), ("tom", 1), ("shuke", 2)))

    //求jion

    val rdd3 = rdd1.union(rdd2)

    //按key进行聚合

    val rdd4 = rdd3.reduceByKey(_ + _)

    rdd4.collect().foreach({println})

    //按value的降序排序

    val rdd5 = rdd4.map(t => (t._2, t._1)).sortByKey(false).map(t => (t._2, t._1))

    rdd5.collect().foreach({println})

    rdd5.saveAsTextFile("aaaaa1")

  }

}
以上代码,rdd是我通过将两个rdd合并后得到,查看的时候发现rdd5是有两个分区的,输出结果是:
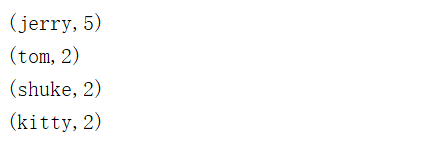
而保存的文件aaaa1则是一个文件夹,所以如果已存在会报文件已存在的错误无法运行(源代码里应该没有做相关的判断和处理),最终结果生成在文件夹中,如下:
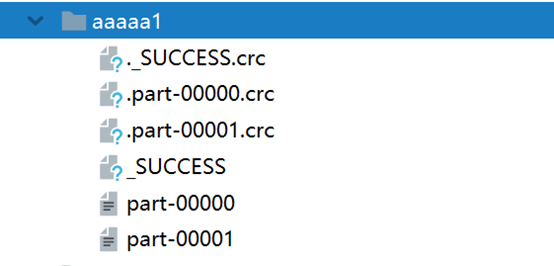
具体的数据保存在后两个文件夹中:
part-00000:
(jerry,5)
part-00001:
(tom,2)

(shuke,2)

(kitty,2)
这是按rdd5里面本身的分区数,各分区内容来生成的,而crc指的是循环冗余,.crc文件是指文件摘要,好像并没有什么特殊的,就是进行crc校验的文件。我本来以为crc和几个分区文件的联系有关系,后来想想spark处理大量数据的时候各分区数据的联系也并不算紧密,基本不会去区分前后顺序,并不需要保存彼此的联系。
大概发现了两件事情:
1、是小文件产生的大量冗余,有时候这些是没必要的,给读写它带来了一些麻烦,但是这个是有方法解决的,暂时还没有涉猎。
2、分区间不平衡,虽然只是很少条数据,但是之前也有做过某些RDD练习也说明rdd里分区并不会实时帮你平衡各分区的数据数量,但是spark有提供相应的方法,其他的,比如hive可能就不一定了。
本地spark下保存rdd为文件的更多相关文章
- 判断本地系统目录下是否存在XML文件,如果不存在就创建一个XMl文件,若存在就在里面执行添加数据
这是我为项目中写的一个测试的例子, 假如,您需要这样一个xml文件, <?xml version="1.0" encoding="utf-8"?> ...
- Spark:将RDD[List[String,List[Person]]]中的List[Person]通过spark api保存为hdfs文件时一直出现not serializable task,没办法找到"spark自定义Kryo序列化输入输出API"
声明:本文转自<在Spark中自定义Kryo序列化输入输出API> 在Spark中内置支持两种系列化格式:(1).Java serialization:(2).Kryo seriali ...
- Spark RDD 多文件输入
1.将多个文本文件读入一个RDD中 SparkConf conf=new SparkConf() .setMaster("local") .setAppName("sav ...
- 用Python删除本地目录下某一时间点之前创建的所有文件
因为工作原因,需要定期清理某个文件夹下面创建时间超过1年的所有文件,所以今天集中学习了一下Python对于本地文件及文件夹的操作.网上 这篇文章 简明扼要地整理出最常见的os方法,抄袭如下: os.l ...
- Spark(十)【RDD的读取和保存】
目录 一.文件类型 1.Text文件 2.Json文件 3.对象文件 4.Sequence文件 二.文件系统 1. MySQL 2. Hbase 一.文件类型 1.Text文件 读写 读取 scala ...
- 一个获取指定目录下一定格式的文件名称和文件修改时间并保存为文件的python脚本
摘自:http://blog.csdn.net/forandever/article/details/5711319 一个获取指定目录下一定格式的文件名称和文件修改时间并保存为文件的python脚本 ...
- linux下保存下位机输出的串口信息为文件
linux下保存下位机输出的串口信息为文件 1.stty -F /dev/ttyUSB0 raw (转换成raw模式) 2.stty -F /dev/ttyUSB0 speed 115200 (设置波 ...
- Windows下拷贝Linux的文件到本地(Putty)
去官网下载的Putty中包含了如下文件: 其中pscp.exe是一个远程复制文件的工具. 官网:https://www.chiark.greenend.org.uk/~sgtatham/putty/l ...
- 用Python删除本地目录下某一时间点之前创建的文件
参考http://www.cnblogs.com/iderek/p/8035757.html os.listdir(dirname):列出dirname下的目录和文件 os.getcwd():获得当前 ...
随机推荐
- 一个 Vim 重度用户总结的 vim 超全指南
我本人是 Vim 的重度使用者,就因为喜欢上这种双手不离键盘就可以操控一切的feel,Vim 可以让我对文本的操作更加精准.高效. 对于未使用过 Vim 的朋友来说,可能还无法体会到这种感觉.由于使用 ...
- java 使用GraphQL-关联对象
GraphQL并不会实现关联查询,数据关联需要程序自己实现 官网首页有介绍获取多个资源只需要一个请求,如想获取用户信息和身份证信息,原来需要先查用户信息,再通过用户id查询身份证信息,而在GraphQ ...
- 【转载】C#中ToArray方法将List集合转换为对应的数组
在C#的List集合操作中,可以使用List集合自带的ToArray方法来将List集合转换为对应的Array数组元素.ToArray方法的签名为T[] ToArray(),存在于命名空间System ...
- Ubuntu 用户权限相关命令
目标 用户 和 权限 的基本概念 用户管理 终端命令 组管理 终端命令 修改权限 终端命令 01. 用户 和 权限 的基本概念 1.1 基本概念 用户 是 Linux 系统工作中重要的一环,用户管理包 ...
- mysql遇到时区问题的坑(Java解决方案)
最近项目遇到一个坑,就是server和db之间存在时区问题,本人的db是utc时间, 可以使用代码设置时区来解决,本人这里使用joda三方包,joda蛮好用的,具体用法这里不做详细描述. 先引入pom ...
- 如何顺利完成Kubernetes源码编译?
为什么要编译源码 ? Kubernetes是一个非常棒的容器集群管理平台.通常情况下,我们并不需要修改K8S代码即可直接使用.但如果,我们在环境中发现了某个问题/缺陷,或按照特定业务需求需要修改K8S ...
- 传入json字符串的post请求
/** * 传入json字符串的post请求 * @Title: getRequsetData * @Description: TODO * @param @param url * @param @p ...
- bcb中TParamter传NULL值
if (status_Desc.IsEmpty()) Queue_Status->Value = Null(); else Queue_Status->Value = status_Des ...
- JAVA对象结构
对象的内存布局 在HotSpot虚拟机中,对象在内存中存储的布局可以分为3块区域:对象头(Header),实例数据(Instance Data)和对象填充(Padding). 实例数据:对象真正存储的 ...
- cookie,session,token介绍
本文目录 发展史 Cookie Session Token 回到目录 发展史 1.很久很久以前,Web 基本上就是文档的浏览而已, 既然是浏览,作为服务器, 不需要记录谁在某一段时间里都浏览了什么文档 ...