
【python】一篇文章里的词频统计
一、环境
1.python3.6
2.windows系统
3.安装第三方模块
pip install wordcloud    #词云展示库

pip install jieba            #结巴分词

pip install matplotlib     #图像展示库
二、需求
统计article.txt里的文章的词频
三、代码
import collections  #词库统计库,自带模块

import re       #正则表达式  自带模块

import wordcloud    #词云展示库,pip install wordcloud

import jieba        #结巴分词,pip install jieba

import matplotlib.pyplot as plt     #图像展示库  pip install matplotlib

#读取文件

fn = open('article.txt',encoding='utf-8')    #打开文件

string_data = fn.read()     #读取整个文件

fn.close()                  #关闭文件

#文本预处理

pattern = re.compile(u'\t|\n|\.|-|:|;|\)|\(|\?|"')  #定义正则表达式匹配模式

string_data = re.sub(pattern,'',string_data)        #将符合模式的字符去除

print(string_data)

#文本分词

seg_list_exact = jieba.cut(string_data,cut_all=False)   #精确模式分词

object_list = []

remove_words = [u'的',u',',u'。',u'“',u'”',u'能',u'如果',u'通常',u'我们',u'需要',u'随着',u' ',u'在',u'了',u'、',u'是',u'上',u'有',u'从']      #自定义去除词库

# print(seg_list_exact)

for word in seg_list_exact: #循环读出每个分词

    if word not in remove_words:    #如果不在去除词库中

        object_list.append(word)    #分词追加到列表

# print(object_list)

# # 词频统计

word_counts = collections.Counter(object_list)  #对分词做词频统计

word_counts_top10 = word_counts.most_common(10) #获取前10最高频的词

print(word_counts_top10)    #输出检查

#

# # 词频展示

wc = wordcloud.WordCloud(background_color="black",  # 设置背景颜色

               max_words=200,  # 设置最大显示的字数

               font_path="FZSTK.TTF",  # 设置中文字体,词云默认字体是“DroidSansMono.ttf字体库”,不支持中文

               max_font_size=50,  # 设置字体最大值

               random_state=30,  # 设置有多少种随机生成状态,即有多少种配色方案

               )

#

wc.generate_from_frequencies(word_counts)   #从字典生成词云

plt.imshow(wc)      #显示词云

plt.axis('off')     #关闭坐标轴

plt.show()          #显示图像
四、结果展示
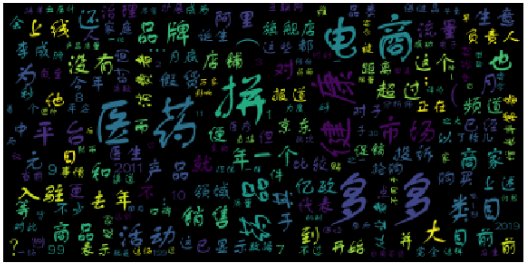
【python】一篇文章里的词频统计的更多相关文章
- python复合数据类型以及英文词频统计
这个作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/2753. 1.列表,元组,字典,集合分别如何增删改查及遍历. 列 ...
- python瓦登尔湖词频统计
#瓦登尔湖词频统计: import string path = 'D:/python3/Walden.txt' with open(path,'r',encoding= 'utf-8') as tex ...
- python英文与中文的词频统计
1.统计英文单词, # 1.准备utf-8编码的文本文件file(已在文件夹中定义了 一个名叫“head.txt.rtf”文本文件,详情请见截图) def getTxt(): #3对文本预处理(包括) ...
- Python数据分析之文本处理词频统计
1.项目背景: 原本计划着爬某房产网站的数据做点分析, 结果数据太烂了,链家网的数据干净点, 但都是新开楼盘,没有时间维度,分析意义不大. 学习的步伐不能ting,自然语言处理还的go on 2.分析 ...
- python jieba分词小说与词频统计
1.知识点 """ 1)cut() a) codecs.open() 解决编码问题 b) f.readline() 读取一行,也可以使用f.readlines()读取多行 ...
- 一篇文章让你学透Linux系统中的more命令
Linux 下有很多实用工具可以让你在终端界面查看文本文件.其中一个就是 more. more 跟我之前另一篇文章里写到的工具 —— less 很相似.它们之间的主要不同点在于 more 只允许你向前 ...
- spark ---词频统计(二)
利用python来操作spark的词频统计,现将过程分享如下: 1.新建项目:(这里是在已有的项目中创建的,可单独创建wordcount项目) ①新建txt文件: wordcount.txt (文件内 ...
- 一篇文章图文并茂地带你轻松学完 JavaScript 设计模式(一)
JavaScript 设计模式(一) 本文需要读者至少拥有基础的 ES6 知识,包括 Proxy, Reflect 以及 Generator 函数等. 至于这次为什么分了两篇文章,有损传统以及标题的正 ...
- Python之利用jieba库做词频统计且制作词云图
一.环境以及注意事项 1.windows10家庭版 python 3.7.1 2.需要使用到的库 wordcloud(词云),jieba(中文分词库),安装过程不展示 3.注意事项:由于wordclo ...
随机推荐
- Python面向对象 | 初识
一.面向对象编程 类 : 具有相同属性和技能的一类事物 对象: 就是对一个类的具体的描述 实例化:类——>对象的过程 使用面向对象的好处: 使得代码之间的角色关系更加明确 增强了代码的可扩展性 ...
- 渗透测试工具Nmap篇
Nmap是一款网络扫描和主机检测的非常有用的工具. Nmap是不局限于仅仅收集信息和枚举,同时可以用来作为一个漏洞探测器或安全扫描器.它可以适用于winodws,linux,mac等操作系统.Nmap ...
- axios post方式请求x-ww格式的数据
//使用axios时,要确定是json格式还是x-www格式的,axios默认是json格式的,如果是x-ww格式需要做如下配置: let url = "/hehe/site/getcomm ...
- 将float数字按照一定格式写入到文件中
/* float.c */ #include<stdio.h> #include<string.h> int main() { FILE *fp = fopen("D ...
- ubuntu容器化开发系统配置 相关下载地址(laravel)
ubuntu64位 18.04(开发使用桌面版本) Nginx PHP7.3 开发工具:PHPStorm 其他技术栈:laravel.VUE.NodeJs https://laravel.com/ h ...
- MongoDB Shell 命令
更新列名 db.Stores.update({}, {$rename : {"StoreId" : "MetaId"}}, false, true) 查询长度 ...
- 20165230田坤烨网络对抗免考报告_基于WIN10的渗透攻击
目录 简单信息收集 主机发现 ping nmap 端口扫描 nmap OS及服务版本探测 nmap -sV 绕过防火墙尝试 诱饵 随机数据长度 随机顺序扫描目标 MAC地址欺骗 实现win10的渗透攻 ...
- Maven 教程(14)— Maven聚合与继承
原文地址:https://blog.csdn.net/liupeifeng3514/article/details/79553011 1.Maven聚合 我们在平时的开发中,项目往往会被划分为好几个模 ...
- BitSet源码
public class BitSet1 implements Cloneable, java.io.Serializable { // >>>左边补0, << 右边补0 ...
- mapreduce 变量共享
mapreduce 全局变量共享 在编写MapReduce程序时,经常会遇到这样的问题,全局变量如何保存?如何让每个处理都能获取保存的这些全局变量?使用全局变量是不可避免的,但是 在MapRdeuce ...