
apache-storm-1.0.2.tar.gz的集群搭建(3节点)(图文详解)(非HA和HA)
不多说,直接上干货!
Storm的版本选取
我这里,是选用apache-storm-1.0.2.tar.gz
apache-storm-0.9.6.tar.gz的集群搭建(3节点)(图文详解)
为什么我用过storm-0.9.6版本,我还要用storm-1.0.2?
storm集群也是由主节点和从节点组成的。
storm版本的变更:
storm0.9.x
storm0.10.x
storm1.x
前面这些版本里面storm的核心源码是由Java+clojule组成的。
storm2.x
后期这个版本就是全部用java重写了。
(阿里在很早的时候就对storm进程了重写,提供了jstorm,后期jstorm也加入到apachestorm
负责使用java对storm进行重写,这就是storm2.x版本的由来。)
注意:
在storm0.9.x的版本中,storm集群只支持一个nimbus节点,主节点是存在问题。
在storm0.10.x以后,storm集群可以支持多个nimbus节点,其中有一个为leader,负责真正运行,其余的为offline。
主节点(控制节点 master)【主节点可以有一个或者多个】
职责:负责分发代码,监控代码的执行。
nimbus:
ui:可以查看集群的信息以及topology的运行情况
logviewer:因为主节点会有多个,有时候也需要查看主节点的日志信息。
从节点(工作节点 worker)【从节点可以有一个或者多个】
职责:负责产生worker进程,执行任务。
supervisor:
logviewer:可以通过webui界面查看topology的运行日志
Storm的本地模式安装
本地模式在一个进程里面模拟一个storm集群的所有功能, 这对开发和测试来说非常方便。以本地模式运行topology跟在集群上运行topology类似。
要创建一个进程内“集群”,使用LocalCluster对象就可以了:
import backtype.storm.LocalCluster;

LocalCluster cluster = new LocalCluster();
然后可以通过LocalCluster对象的submitTopology方法来提交topology, 效果和StormSubmitter对应的方法是一样的。submitTopology方法需要三个参数: topology的名字, topology的配置以及topology对象本身。你可以通过killTopology方法来终止一个topology, 它需要一个topology名字作为参数。
要关闭一个本地集群,简单调用:
cluster.shutdown();
就可以了。
Storm的分布式模式安装(本博文)
官方安装文档
http://storm.apache.org/releases/current/Setting-up-a-Storm-cluster.html
机器情况:在master、slave1、slave2机器的/home/hadoop/app目录下分别下载storm安装包
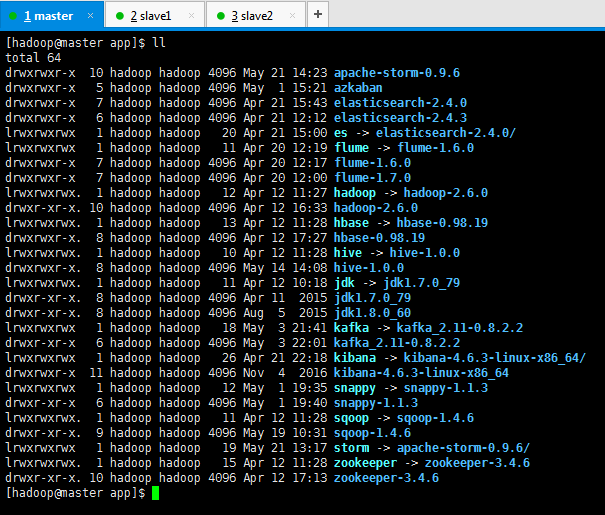
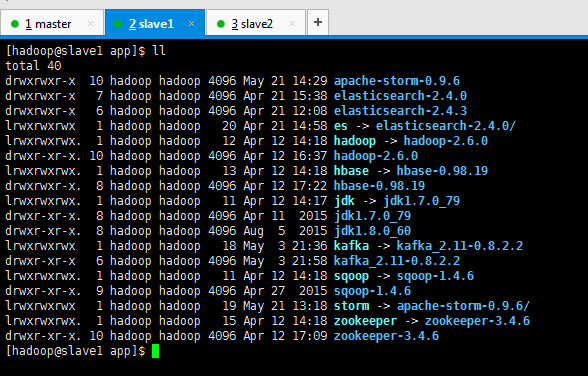

本博文情况是
master nimbus
slave1 nimbus supervisor
slave2 supervisor
1、apache-storm-1.0.2.tar.gz的下载
http://archive.apache.org/dist/storm/apache-storm-1.0.2/
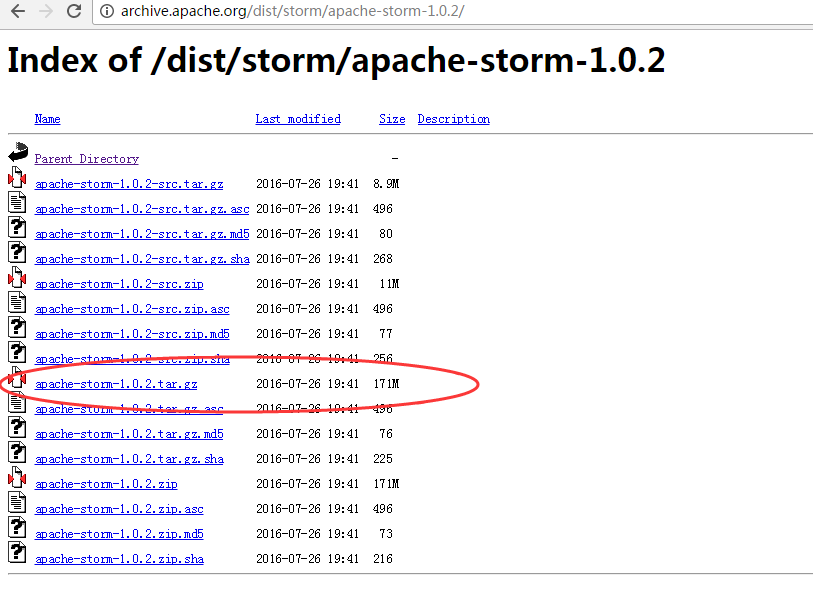
或者,直接在安装目录下,在线下载
wget http://apache.fayea.com/storm/apache-storm-1.0.2/apache-storm-1.0.2.tar.gz
我这里,选择先下载好,再上传安装的方式。
2、上传压缩包
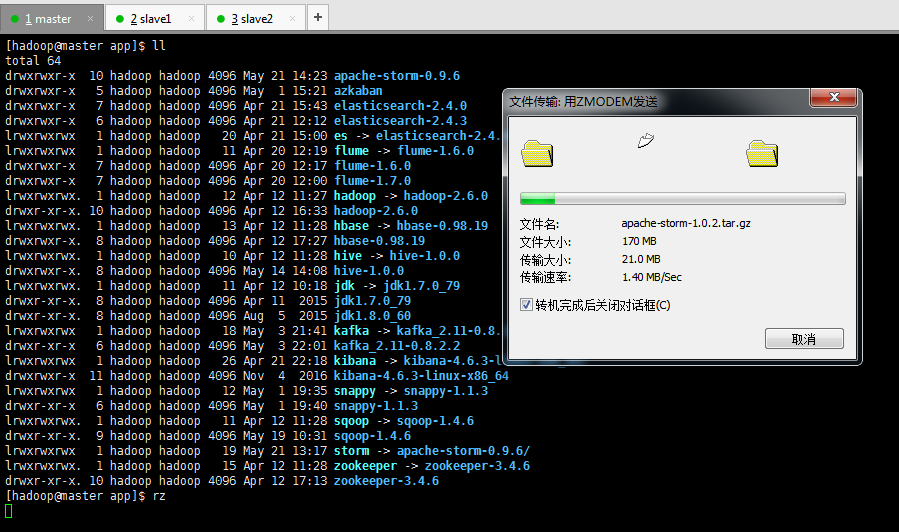
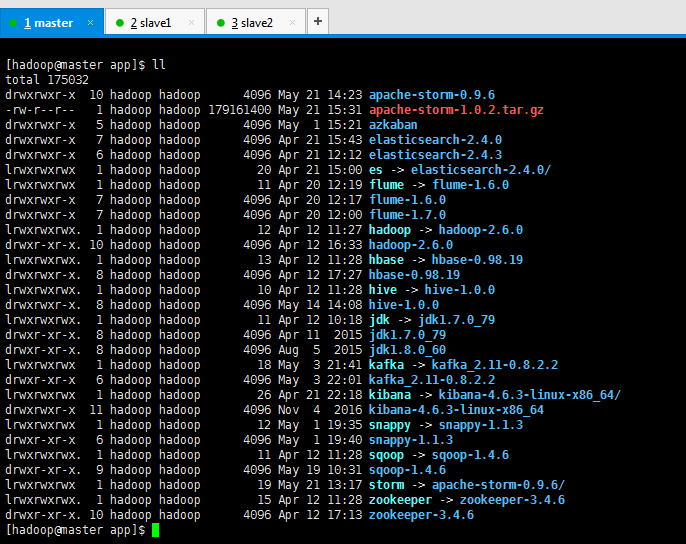
[hadoop@master app]$ ll

total

drwxrwxr-x   hadoop hadoop  May  : apache-storm-0.9.

drwxrwxr-x    hadoop hadoop  May   : azkaban

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

lrwxrwxrwx    hadoop hadoop    Apr  : es -> elasticsearch-2.4./

lrwxrwxrwx    hadoop hadoop    Apr  : flume -> flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.7.

lrwxrwxrwx.   hadoop hadoop    Apr  : hadoop -> hadoop-2.6.

drwxr-xr-x.  hadoop hadoop  Apr  : hadoop-2.6.

lrwxrwxrwx.   hadoop hadoop    Apr  : hbase -> hbase-0.98.

drwxrwxr-x.   hadoop hadoop  Apr  : hbase-0.98.

lrwxrwxrwx.   hadoop hadoop    Apr  : hive -> hive-1.0.

drwxrwxr-x.   hadoop hadoop  May  : hive-1.0.

lrwxrwxrwx.   hadoop hadoop    Apr  : jdk -> jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Apr    jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Aug     jdk1..0_60

lrwxrwxrwx    hadoop hadoop    May   : kafka -> kafka_2.-0.8.2.2

drwxr-xr-x    hadoop hadoop  May   : kafka_2.-0.8.2.2

lrwxrwxrwx    hadoop hadoop    Apr  : kibana -> kibana-4.6.-linux-x86_64/

drwxrwxr-x   hadoop hadoop  Nov     kibana-4.6.-linux-x86_64

lrwxrwxrwx    hadoop hadoop    May   : snappy -> snappy-1.1.

drwxr-xr-x    hadoop hadoop  May   : snappy-1.1.

lrwxrwxrwx.   hadoop hadoop    Apr  : sqoop -> sqoop-1.4.

drwxr-xr-x.   hadoop hadoop  May  : sqoop-1.4.

lrwxrwxrwx    hadoop hadoop    May  : storm -> apache-storm-0.9./

lrwxrwxrwx.   hadoop hadoop    Apr  : zookeeper -> zookeeper-3.4.

drwxr-xr-x.  hadoop hadoop  Apr  : zookeeper-3.4.

[hadoop@master app]$ rz

[hadoop@master app]$ ll

total

drwxrwxr-x   hadoop hadoop       May  : apache-storm-0.9.

-rw-r--r--    hadoop hadoop  May  : apache-storm-1.0..tar.gz

drwxrwxr-x    hadoop hadoop       May   : azkaban

drwxrwxr-x    hadoop hadoop       Apr  : elasticsearch-2.4.

drwxrwxr-x    hadoop hadoop       Apr  : elasticsearch-2.4.

lrwxrwxrwx    hadoop hadoop         Apr  : es -> elasticsearch-2.4./

lrwxrwxrwx    hadoop hadoop         Apr  : flume -> flume-1.6.

drwxrwxr-x    hadoop hadoop       Apr  : flume-1.6.

drwxrwxr-x    hadoop hadoop       Apr  : flume-1.7.

lrwxrwxrwx.   hadoop hadoop         Apr  : hadoop -> hadoop-2.6.

drwxr-xr-x.  hadoop hadoop       Apr  : hadoop-2.6.

lrwxrwxrwx.   hadoop hadoop         Apr  : hbase -> hbase-0.98.

drwxrwxr-x.   hadoop hadoop       Apr  : hbase-0.98.

lrwxrwxrwx.   hadoop hadoop         Apr  : hive -> hive-1.0.

drwxrwxr-x.   hadoop hadoop       May  : hive-1.0.

lrwxrwxrwx.   hadoop hadoop         Apr  : jdk -> jdk1..0_79

drwxr-xr-x.   hadoop hadoop       Apr    jdk1..0_79

drwxr-xr-x.   hadoop hadoop       Aug     jdk1..0_60

lrwxrwxrwx    hadoop hadoop         May   : kafka -> kafka_2.-0.8.2.2

drwxr-xr-x    hadoop hadoop       May   : kafka_2.-0.8.2.2

lrwxrwxrwx    hadoop hadoop         Apr  : kibana -> kibana-4.6.-linux-x86_64/

drwxrwxr-x   hadoop hadoop       Nov     kibana-4.6.-linux-x86_64

lrwxrwxrwx    hadoop hadoop         May   : snappy -> snappy-1.1.

drwxr-xr-x    hadoop hadoop       May   : snappy-1.1.

lrwxrwxrwx.   hadoop hadoop         Apr  : sqoop -> sqoop-1.4.

drwxr-xr-x.   hadoop hadoop       May  : sqoop-1.4.

lrwxrwxrwx    hadoop hadoop         May  : storm -> apache-storm-0.9./

lrwxrwxrwx.   hadoop hadoop         Apr  : zookeeper -> zookeeper-3.4.

drwxr-xr-x.  hadoop hadoop       Apr  : zookeeper-3.4.

[hadoop@master app]$
slave1和slave2机器同样。不多赘述。
3、解压压缩包,并赋予用户组和用户权限
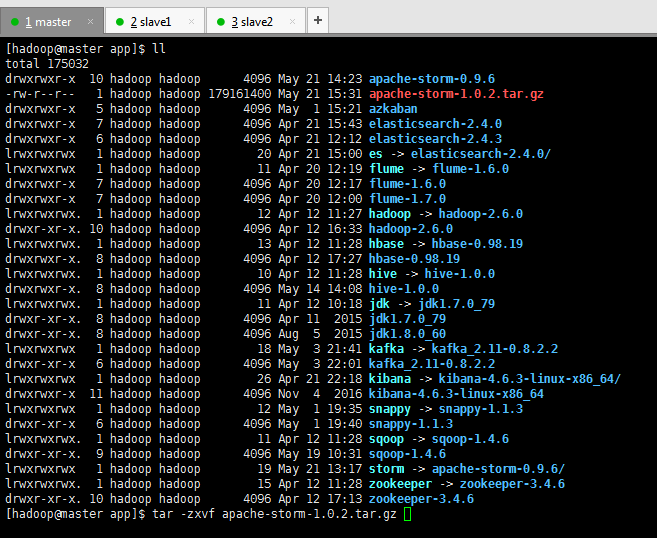
[hadoop@master app]$ ll

total

drwxrwxr-x   hadoop hadoop       May  : apache-storm-0.9.

-rw-r--r--    hadoop hadoop  May  : apache-storm-1.0..tar.gz

drwxrwxr-x    hadoop hadoop       May   : azkaban

drwxrwxr-x    hadoop hadoop       Apr  : elasticsearch-2.4.

drwxrwxr-x    hadoop hadoop       Apr  : elasticsearch-2.4.

lrwxrwxrwx    hadoop hadoop         Apr  : es -> elasticsearch-2.4./

lrwxrwxrwx    hadoop hadoop         Apr  : flume -> flume-1.6.

drwxrwxr-x    hadoop hadoop       Apr  : flume-1.6.

drwxrwxr-x    hadoop hadoop       Apr  : flume-1.7.

lrwxrwxrwx.   hadoop hadoop         Apr  : hadoop -> hadoop-2.6.

drwxr-xr-x.  hadoop hadoop       Apr  : hadoop-2.6.

lrwxrwxrwx.   hadoop hadoop         Apr  : hbase -> hbase-0.98.

drwxrwxr-x.   hadoop hadoop       Apr  : hbase-0.98.

lrwxrwxrwx.   hadoop hadoop         Apr  : hive -> hive-1.0.

drwxrwxr-x.   hadoop hadoop       May  : hive-1.0.

lrwxrwxrwx.   hadoop hadoop         Apr  : jdk -> jdk1..0_79

drwxr-xr-x.   hadoop hadoop       Apr    jdk1..0_79

drwxr-xr-x.   hadoop hadoop       Aug     jdk1..0_60

lrwxrwxrwx    hadoop hadoop         May   : kafka -> kafka_2.-0.8.2.2

drwxr-xr-x    hadoop hadoop       May   : kafka_2.-0.8.2.2

lrwxrwxrwx    hadoop hadoop         Apr  : kibana -> kibana-4.6.-linux-x86_64/

drwxrwxr-x   hadoop hadoop       Nov     kibana-4.6.-linux-x86_64

lrwxrwxrwx    hadoop hadoop         May   : snappy -> snappy-1.1.

drwxr-xr-x    hadoop hadoop       May   : snappy-1.1.

lrwxrwxrwx.   hadoop hadoop         Apr  : sqoop -> sqoop-1.4.

drwxr-xr-x.   hadoop hadoop       May  : sqoop-1.4.

lrwxrwxrwx    hadoop hadoop         May  : storm -> apache-storm-0.9./

lrwxrwxrwx.   hadoop hadoop         Apr  : zookeeper -> zookeeper-3.4.

drwxr-xr-x.  hadoop hadoop       Apr  : zookeeper-3.4.

[hadoop@master app]$ tar -zxvf apache-storm-1.0..tar.gz
slave1和slave2机器同样。不多赘述。
4、删除压缩包,为了更好容下多版本,创建软链接
大数据各子项目的环境搭建之建立与删除软连接(博主推荐)
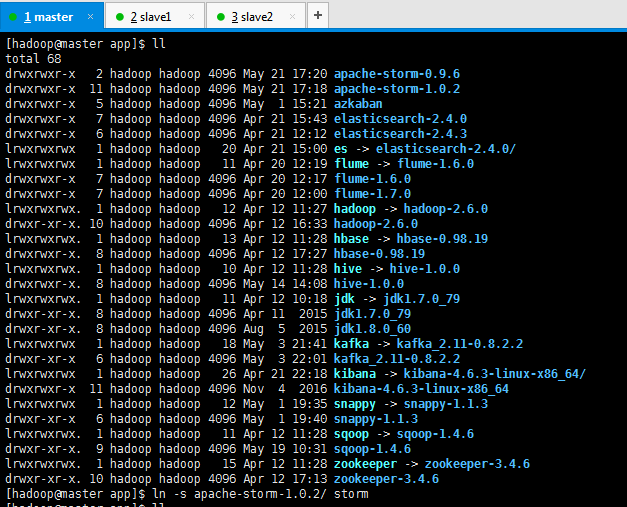

[hadoop@master app]$ ll

total

drwxrwxr-x    hadoop hadoop  May  : apache-storm-0.9.

drwxrwxr-x   hadoop hadoop  May  : apache-storm-1.0.

drwxrwxr-x    hadoop hadoop  May   : azkaban

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

lrwxrwxrwx    hadoop hadoop    Apr  : es -> elasticsearch-2.4./

lrwxrwxrwx    hadoop hadoop    Apr  : flume -> flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.7.

lrwxrwxrwx.   hadoop hadoop    Apr  : hadoop -> hadoop-2.6.

drwxr-xr-x.  hadoop hadoop  Apr  : hadoop-2.6.

lrwxrwxrwx.   hadoop hadoop    Apr  : hbase -> hbase-0.98.

drwxrwxr-x.   hadoop hadoop  Apr  : hbase-0.98.

lrwxrwxrwx.   hadoop hadoop    Apr  : hive -> hive-1.0.

drwxrwxr-x.   hadoop hadoop  May  : hive-1.0.

lrwxrwxrwx.   hadoop hadoop    Apr  : jdk -> jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Apr    jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Aug     jdk1..0_60

lrwxrwxrwx    hadoop hadoop    May   : kafka -> kafka_2.-0.8.2.2

drwxr-xr-x    hadoop hadoop  May   : kafka_2.-0.8.2.2

lrwxrwxrwx    hadoop hadoop    Apr  : kibana -> kibana-4.6.-linux-x86_64/

drwxrwxr-x   hadoop hadoop  Nov     kibana-4.6.-linux-x86_64

lrwxrwxrwx    hadoop hadoop    May   : snappy -> snappy-1.1.

drwxr-xr-x    hadoop hadoop  May   : snappy-1.1.

lrwxrwxrwx.   hadoop hadoop    Apr  : sqoop -> sqoop-1.4.

drwxr-xr-x.   hadoop hadoop  May  : sqoop-1.4.

lrwxrwxrwx.   hadoop hadoop    Apr  : zookeeper -> zookeeper-3.4.

drwxr-xr-x.  hadoop hadoop  Apr  : zookeeper-3.4.

[hadoop@master app]$ ln -s apache-storm-1.0./ storm

[hadoop@master app]$ ll

total

drwxrwxr-x    hadoop hadoop  May  : apache-storm-0.9.

drwxrwxr-x   hadoop hadoop  May  : apache-storm-1.0.

drwxrwxr-x    hadoop hadoop  May   : azkaban

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

drwxrwxr-x    hadoop hadoop  Apr  : elasticsearch-2.4.

lrwxrwxrwx    hadoop hadoop    Apr  : es -> elasticsearch-2.4./

lrwxrwxrwx    hadoop hadoop    Apr  : flume -> flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.6.

drwxrwxr-x    hadoop hadoop  Apr  : flume-1.7.

lrwxrwxrwx.   hadoop hadoop    Apr  : hadoop -> hadoop-2.6.

drwxr-xr-x.  hadoop hadoop  Apr  : hadoop-2.6.

lrwxrwxrwx.   hadoop hadoop    Apr  : hbase -> hbase-0.98.

drwxrwxr-x.   hadoop hadoop  Apr  : hbase-0.98.

lrwxrwxrwx.   hadoop hadoop    Apr  : hive -> hive-1.0.

drwxrwxr-x.   hadoop hadoop  May  : hive-1.0.

lrwxrwxrwx.   hadoop hadoop    Apr  : jdk -> jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Apr    jdk1..0_79

drwxr-xr-x.   hadoop hadoop  Aug     jdk1..0_60

lrwxrwxrwx    hadoop hadoop    May   : kafka -> kafka_2.-0.8.2.2

drwxr-xr-x    hadoop hadoop  May   : kafka_2.-0.8.2.2

lrwxrwxrwx    hadoop hadoop    Apr  : kibana -> kibana-4.6.-linux-x86_64/

drwxrwxr-x   hadoop hadoop  Nov     kibana-4.6.-linux-x86_64

lrwxrwxrwx    hadoop hadoop    May   : snappy -> snappy-1.1.

drwxr-xr-x    hadoop hadoop  May   : snappy-1.1.

lrwxrwxrwx.   hadoop hadoop    Apr  : sqoop -> sqoop-1.4.

drwxr-xr-x.   hadoop hadoop  May  : sqoop-1.4.

lrwxrwxrwx    hadoop hadoop    May  : storm -> apache-storm-1.0./

lrwxrwxrwx.   hadoop hadoop    Apr  : zookeeper -> zookeeper-3.4.

drwxr-xr-x.  hadoop hadoop  Apr  : zookeeper-3.4.

[hadoop@master app]$
slave1和slave2机器同样。不多赘述。
5、修改配置环境
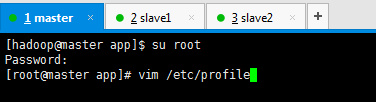
[hadoop@master app]$ su root

Password:

[root@master app]# vim /etc/profile
slave1和slave2机器同样。不多赘述
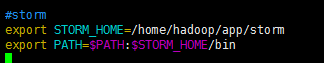
#storm

export STORM_HOME=/home/hadoop/app/storm

export PATH=$PATH:$STORM_HOME/bin
slave1和slave2机器同样。不多赘述
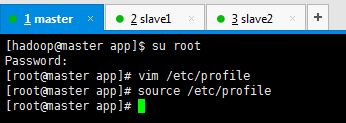
[hadoop@master app]$ su root

Password:

[root@master app]# vim /etc/profile

[root@master app]# source /etc/profile

[root@master app]#
slave1和slave2机器同样。不多赘述
6、下载好Storm集群所需的其他
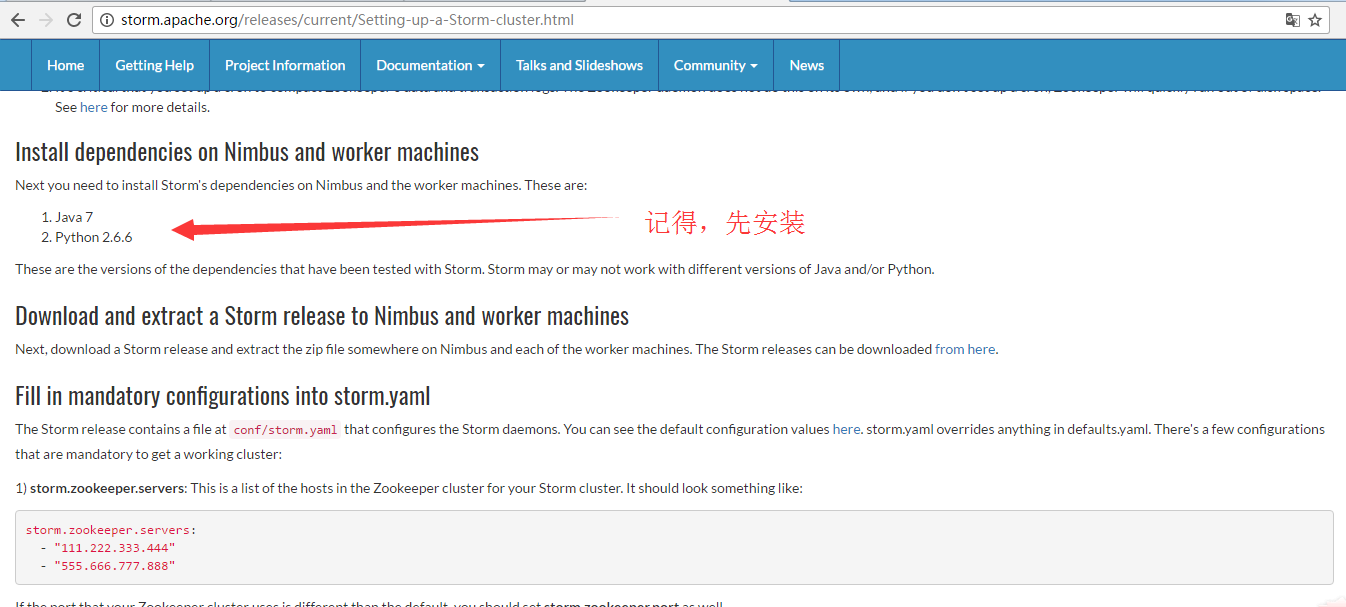
因为博主我的机器是CentOS6.5,已经自带了
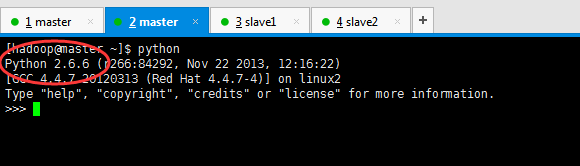
[hadoop@master ~]$ python

Python 2.6.6 (r266:84292, Nov 22 2013, 12:16:22)

[GCC 4.4.7 20120313 (Red Hat 4.4.7-4)] on linux2

Type "help", "copyright", "credits" or "license" for more information.

>>>
7、配置storm的配置文件
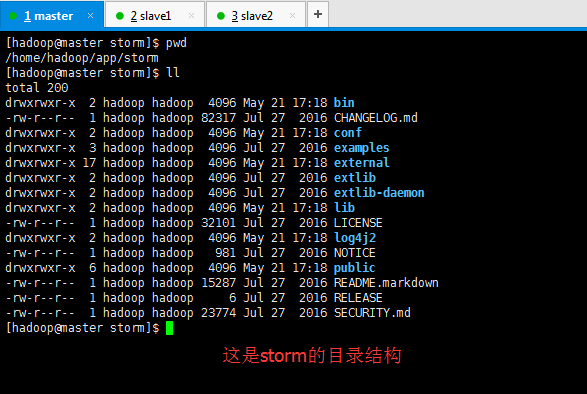
[hadoop@master storm]$ pwd

/home/hadoop/app/storm

[hadoop@master storm]$ ll

total

drwxrwxr-x   hadoop hadoop   May  : bin

-rw-r--r--   hadoop hadoop  Jul    CHANGELOG.md

drwxrwxr-x   hadoop hadoop   May  : conf

drwxrwxr-x   hadoop hadoop   Jul    examples

drwxrwxr-x  hadoop hadoop   May  : external

drwxrwxr-x   hadoop hadoop   Jul    extlib

drwxrwxr-x   hadoop hadoop   Jul    extlib-daemon

drwxrwxr-x   hadoop hadoop   May  : lib

-rw-r--r--   hadoop hadoop  Jul    LICENSE

drwxrwxr-x   hadoop hadoop   May  : log4j2

-rw-r--r--   hadoop hadoop    Jul    NOTICE

drwxrwxr-x   hadoop hadoop   May  : public

-rw-r--r--   hadoop hadoop  Jul    README.markdown

-rw-r--r--   hadoop hadoop      Jul    RELEASE

-rw-r--r--   hadoop hadoop  Jul    SECURITY.md

[hadoop@master storm]$
进入storm配置目录下,修改配置文件storm.yaml
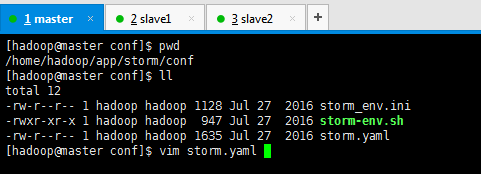
[hadoop@master conf]$ pwd

/home/hadoop/app/storm/conf

[hadoop@master conf]$ ll

total

-rw-r--r--  hadoop hadoop  Jul    storm_env.ini

-rwxr-xr-x  hadoop hadoop   Jul    storm-env.sh

-rw-r--r--  hadoop hadoop  Jul    storm.yaml

[hadoop@master conf]$ vim storm.yaml
slave1和slave2机器同样。不多赘述
这里,教给大家一个非常好的技巧。
大数据搭建各个子项目时配置文件技巧(适合CentOS和Ubuntu系统)(博主推荐)
注意第一列需要一个空格

注意第一列需要一个空格(HA)
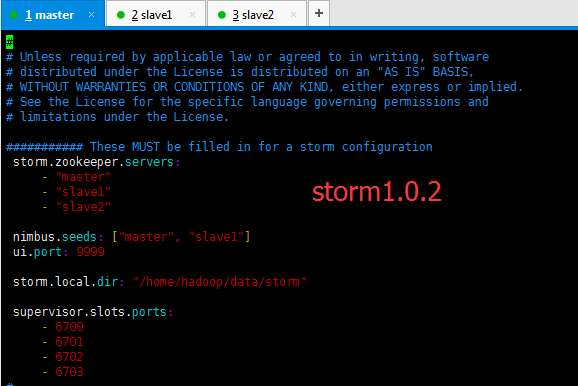
 storm.zookeeper.servers:

     - "master"

     - "slave1"

     - "slave2"

 nimbus.seeds: ["master", "slave1"]

 ui.port:

 storm.local.dir: "/home/hadoop/data/storm"

 supervisor.slots.ports:

     -

     -

     -

     -
注意:我的这里ui.port选定为9999,是自定义,为了解决Storm 和spark默认的 8080 端口冲突!
slave1和slave2机器同样。不多赘述。
注意第一列需要一个空格(非HA)
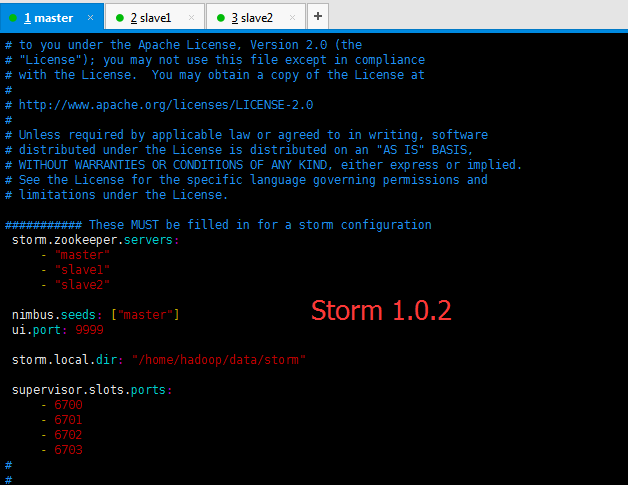
 storm.zookeeper.servers:

     - "master"

     - "slave1"

     - "slave2"

 nimbus.seeds: ["master"]

 ui.port: 9999

 storm.local.dir: "/home/hadoop/data/storm"

 supervisor.slots.ports:

     - 6700

     - 6701

     - 6702

     - 6703
注意:我的这里ui.port选定为9999,是自定义,为了解决Storm 和spark默认的 8080 端口冲突!
slave1和slave2机器同样。不多赘述。
8、新建storm数据存储的路径目录
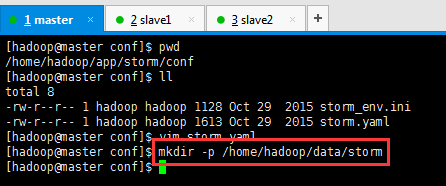
[hadoop@master conf]$ mkdir -p /home/hadoop/data/storm
slave1和slave2机器同样。不多赘述
9、启动storm集群(HA)
本博文情况是
master(主) nimbus
slave1(主)(从) nimbus supervisor
slave2(从) supervisor
1、先在master上启动
nohup bin/storm nimbus >/dev/null >& &

[hadoop@master storm]$ jps

 QuorumPeerMain

 Jps

 AzkabanWebServer

 ResourceManager

 AzkabanExecutorServer

 NameNode

 SecondaryNameNode

[hadoop@master storm]$ nohup bin/storm nimbus >/dev/null >& &

[]

[hadoop@master storm]$ jps

 QuorumPeerMain

 Jps

 config_value

 AzkabanWebServer

 ResourceManager

 AzkabanExecutorServer

 NameNode

 SecondaryNameNode

[hadoop@master storm]$
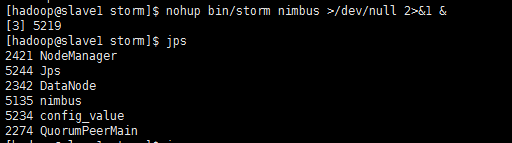
2、再在slave1上启动
nohup bin/storm nimbus >/dev/null >& &
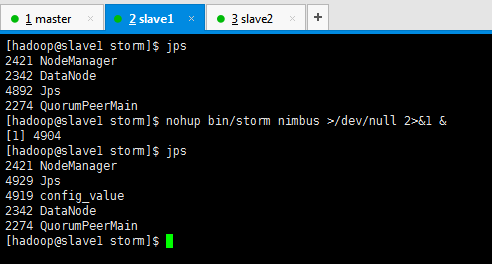
[hadoop@slave1 storm]$ jps

 NodeManager

 DataNode

 Jps

 QuorumPeerMain

[hadoop@slave1 storm]$ nohup bin/storm nimbus >/dev/null >& &

[]
[hadoop@slave1 storm]$ jps
2421 NodeManager
5244 Jps
2342 DataNode
5135 nimbus
5234 config_value
2274 QuorumPeerMain
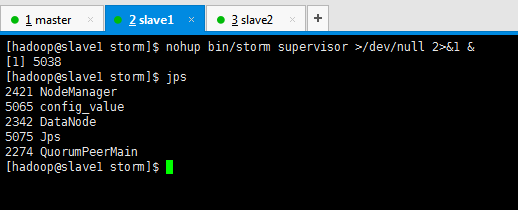
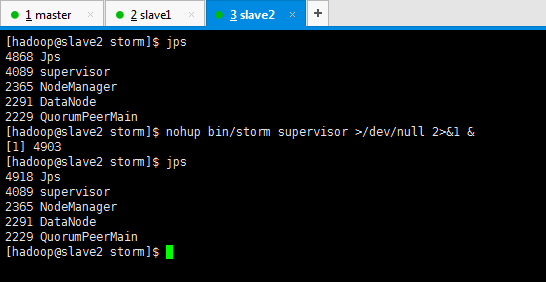
3、先在slave1和slave2上启动
nohup bin/storm supervisor >/dev/null >& &
[hadoop@slave2 storm]$ jps

 Jps

 supervisor

 NodeManager

 DataNode

 QuorumPeerMain

[hadoop@slave2 storm]$ nohup bin/storm supervisor >/dev/null >& &

[]

[hadoop@slave2 storm]$ jps

 Jps

 supervisor

 NodeManager

 DataNode

 QuorumPeerMain

[hadoop@slave2 storm]$
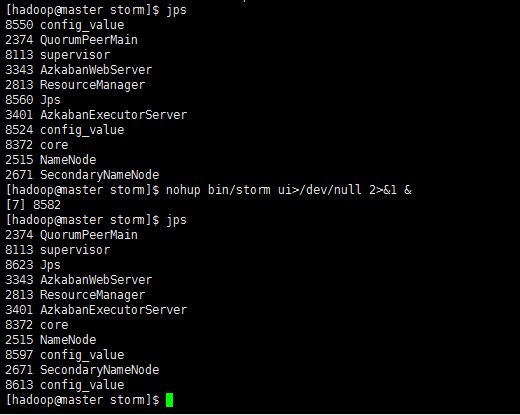
4、在master上启动
nohup bin/storm ui>/dev/null >& &
[hadoop@master storm]$ jps

 config_value

 QuorumPeerMain

 supervisor

 AzkabanWebServer

 ResourceManager

 Jps

 AzkabanExecutorServer

 config_value

 core

 NameNode

 SecondaryNameNode

[hadoop@master storm]$ nohup bin/storm ui>/dev/null >& &

[]

[hadoop@master storm]$ jps

 QuorumPeerMain

 supervisor

 Jps

 AzkabanWebServer

 ResourceManager

 AzkabanExecutorServer

 core

 NameNode

 config_value

 SecondaryNameNode

 config_value

[hadoop@master storm]$
5、在master、slave1和slave2上启动
nohup bin/storm logviwer >/dev/null >& &
9、启动storm集群(非HA)
本博文情况是
master(主) nimbus
slave1(主)(从) supervisor
slave2(从) supervisor
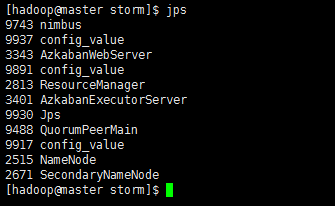
1、先在master上启动
nohup bin/storm nimbus >/dev/null 2>&1 &
[hadoop@master storm]$ jps

2374 QuorumPeerMain

7862 Jps

3343 AzkabanWebServer

2813 ResourceManager

3401 AzkabanExecutorServer

2515 NameNode

2671 SecondaryNameNode

[hadoop@master storm]$ nohup bin/storm nimbus >/dev/null 2>&1 &

[1] 7876

[hadoop@master storm]$ jps

2374 QuorumPeerMain

7905 Jps

7910 config_value

3343 AzkabanWebServer

2813 ResourceManager

3401 AzkabanExecutorServer

2515 NameNode

2671 SecondaryNameNode
9743 nimbus

[hadoop@master storm]$
2、先在slave1和slave2上启动
nohup bin/storm supervisor >/dev/null 2>&1 &
[hadoop@slave2 storm]$ jps

4868 Jps

4089 supervisor

2365 NodeManager

2291 DataNode

2229 QuorumPeerMain

[hadoop@slave2 storm]$ nohup bin/storm supervisor >/dev/null 2>&1 &

[1] 4903

[hadoop@slave2 storm]$ jps

4918 Jps

4089 supervisor

2365 NodeManager

2291 DataNode

2229 QuorumPeerMain

[hadoop@slave2 storm]$
3、在master上启动
nohup bin/storm ui>/dev/null 2>&1 &
[hadoop@master storm]$ jps

8550 config_value

2374 QuorumPeerMain

8113 supervisor

3343 AzkabanWebServer

2813 ResourceManager

8560 Jps

3401 AzkabanExecutorServer

8524 config_value

8372 core

2515 NameNode

2671 SecondaryNameNode

[hadoop@master storm]$ nohup bin/storm ui>/dev/null 2>&1 &

[7] 8582

[hadoop@master storm]$ jps

2374 QuorumPeerMain

8113 supervisor

8623 Jps

3343 AzkabanWebServer

2813 ResourceManager

3401 AzkabanExecutorServer

8372 core

2515 NameNode

8597 config_value

2671 SecondaryNameNode

8613 config_value

[hadoop@master storm]$
4、在master、slave1和slave2上启动
nohup bin/storm logviwer >/dev/null 2>&1 &

成功!
apache-storm-1.0.2.tar.gz的集群搭建(3节点)(图文详解)(非HA和HA)的更多相关文章
- hadoop-2.6.0.tar.gz的集群搭建(3节点)(不含zookeeper集群安装)
前言 本人呕心沥血所写,经过好一段时间反复锤炼和整理修改.感谢所参考的博友们!同时,欢迎前来查阅赏脸的博友们收藏和转载,附上本人的链接http://www.cnblogs.com/zlslch/p/5 ...
- apache-storm-0.9.6.tar.gz的集群搭建(3节点)(图文详解)
不多说,直接上干货! Storm的版本选取 我这里,是选用apache-storm-0.9.6.tar.gz Storm的本地模式安装 本地模式在一个进程里面模拟一个storm集群的所有功能, 这对开 ...
- Kafka 0.9+Zookeeper3.4.6集群搭建、配置,新Client API的使用要点,高可用性测试,以及各种坑 (转载)
Kafka 0.9版本对java client的api做出了较大调整,本文主要总结了Kafka 0.9在集群搭建.高可用性.新API方面的相关过程和细节,以及本人在安装调试过程中踩出的各种坑. 关于K ...
- Ambari 2.6.0 HDP 2.6.3集群搭建
1.安装环境说明 三台机器安装好CentOS-7-x86_64-Minimal-1708.iso 下载地址:https://www.centos.org/download/ 最好在安装时设置好IP和H ...
- Mac MySQL 8.0 (免安装版) 主从集群搭建
一.下载解压包 打开 MySQL 官网地址:https://dev.mysql.com/downloads/mysql/ ,选择面安装版本. 二.解压文件 下载到合适文件夹,解压压缩包. 解压 mys ...
- 【原创】《从0开始学RocketMQ》—集群搭建
用两台服务器,搭建出一个双master双slave.无单点故障的高可用 RocketMQ 集群.此处假设两台服务器的物理 IP 分别为:192.168.50.1.192.168.50.2. 内容目录 ...
- storm集群部署和配置过程详解
先整体介绍一下搭建storm集群的步骤: 设置zookeeper集群 安装依赖到所有nimbus和worker节点 下载并解压storm发布版本到所有nimbus和worker节点 配置storm ...
- Server Tomcat v7.0 Server at localhost failed to start.解决办法(图文详解)
问题描述 Server Tomcat v7.0 Server at localhost failed to start. 解决办法 把你工作空间文件夹下的如下路径打开: <workspace-d ...
- 访问Storm ui界面,出现org.apache.storm.utils.NimbusLeaderNotFoundException: Could not find leader nimbus from seed hosts ["master"]. Did you specify a valid list of nimbus hosts for confi的问题解决(图文详解)
不多说,直接上干货! 前期博客 apache-storm-0.9.6.tar.gz的集群搭建(3节点)(图文详解) apache-storm-1.0.2.tar.gz的集群搭建(3节点)(图文详解)( ...
随机推荐
- MySQL多实例配置(一)
MySQL数据库的集中化运维,能够通过在一台MySQL数据库服务器上,部署多个MySQL实例.该功能是通过mysqld_multi来实现.mysqld_multi用于管理多个mysqld的服务进程,这 ...
- 从CakePHP 1.3升级到2.5
从CakePHP 1.3升级到2.5 摘要:最近把一个CakePHP 1.3的项目升级到了2.x,当然就用最新的版本2.5.3了,结果基本满意.本文记录了升级的过程,包括使用的工具,遇到的问题和相应的 ...
- 【iOS系列】-单例模式的实现
1:重写allocWithZone方法 allocWithZone方法是对象分配内存空间时, alloc方法最终会调用这个方法 + (id)allocWithZone:(struct _NSZone ...
- 2016/05/06 Sublime Text 3 常用插件以及安装方法(转)
http://www.cnsecer.com/460.html 安装Sublime Text 3插件的方法: 朋友们,小站活着不容易,全靠广告费养着了,如果本文对你有帮助.麻烦动下手点下页面的广告吧, ...
- 2016/4/1 PDO:: 数据访问抽象层 ? :
①PDO方式连接 数据库 <!DOCTYPE html> <html lang="en"> <head> <meta charset=&q ...
- HTTP要点概述:四,HTTP方法
使用HTTP协议的时候,客户端可以通过HTTP方法告知服务器自己请求的意图. 看了这篇文章以后,谁再说HTTP方法只有GET和POST,你的眼睛是用来吃饭的嘛! 一,GET:获取资源 GET用来请求访 ...
- POJ3020 Antenna Placement —— 最大匹配 or 最小边覆盖
题目链接:https://vjudge.net/problem/POJ-3020 Antenna Placement Time Limit: 1000MS Memory Limit: 65536K ...
- JSTL1.1函数标签库(functions)如fn:length
JSTL1.1函数标签库(functions)如fn:length 分类: java ssh22012-06-11 09:02 313人阅读 评论(1) 收藏 举报 stringcharacterxm ...
- Morris Traversal方法遍历二叉树(非递归,不用栈,O(1)空间)——无非是在传统遍历过程中修改叶子结点加入后继结点信息(传统是stack记录),然后再删除恢复
先看看线索二叉树 n个结点的二叉链表中含有n+1(2n-(n-1)=n+1)个空指针域.利用二叉链表中的空指针域,存放指向结点在某种遍历次序下的前驱和后继结点的指针(这种附加的指针称为"线索 ...
- P3239 [HNOI2015]亚瑟王 期望dp
这个题一看就是期望dp,但是我有个问题,一个事件的期望等于他所有事件可能行乘权值的和吗...为什么我有天考试的时候就不对呢...求大佬解释一下. 至于这道题,f[i][j]代表前i个有j个发动技能,这 ...