
[转]TF-IDF与余弦相似性的应用(一):自动提取关键词
这个标题看上去好像很复杂,其实我要谈的是一个很简单的问题。
有一篇很长的文章,我要用计算机提取它的关键词(Automatic Keyphrase extraction),完全不加以人工干预,请问怎样才能正确做到?
这个问题涉及到数据挖掘、文本处理、信息检索等很多计算机前沿领域,但是出乎意料的是,有一个非常简单的经典算法,可以给出令人相当满意的结果。它简单到都不需要高等数学,普通人只用10分钟就可以理解,这就是我今天想要介绍的TF-IDF算法。
让我们从一个实例开始讲起。假定现在有一篇长文《中国的蜜蜂养殖》,我们准备用计算机提取它的关键词。
一个容易想到的思路,就是找到出现次数最多的词。如果某个词很重要,它应该在这篇文章中多次出现。于是,我们进行"词频"(Term Frequency,缩写为TF)统计。
结果你肯定猜到了,出现次数最多的词是----"的"、"是"、"在"----这一类最常用的词。它们叫做"停用词"(stop words),表示对找到结果毫无帮助、必须过滤掉的词。
假设我们把它们都过滤掉了,只考虑剩下的有实际意义的词。这样又会遇到了另一个问题,我们可能发现"中国"、"蜜蜂"、"养殖"这三个词的出现次数一样多。这是不是意味着,作为关键词,它们的重要性是一样的?
显然不是这样。因为"中国"是很常见的词,相对而言,"蜜蜂"和"养殖"不那么常见。如果这三个词在一篇文章的出现次数一样多,有理由认为,"蜜蜂"和"养殖"的重要程度要大于"中国",也就是说,在关键词排序上面,"蜜蜂"和"养殖"应该排在"中国"的前面。
所以,我们需要一个重要性调整系数,衡量一个词是不是常见词。如果某个词比较少见,但是它在这篇文章中多次出现,那么它很可能就反映了这篇文章的特性,正是我们所需要的关键词。
用统计学语言表达,就是在词频的基础上,要对每个词分配一个"重要性"权重。最常见的词("的"、"是"、"在")给予最小的权重,较常见的词("中国")给予较小的权重,较少见的词("蜜蜂"、"养殖")给予较大的权重。这个权重叫做"逆文档频率"(Inverse Document Frequency,缩写为IDF),它的大小与一个词的常见程度成反比。
知道了"词频"(TF)和"逆文档频率"(IDF)以后,将这两个值相乘,就得到了一个词的TF-IDF值。某个词对文章的重要性越高,它的TF-IDF值就越大。所以,排在最前面的几个词,就是这篇文章的关键词。
下面就是这个算法的细节。
第一步,计算词频。

考虑到文章有长短之分,为了便于不同文章的比较,进行"词频"标准化。
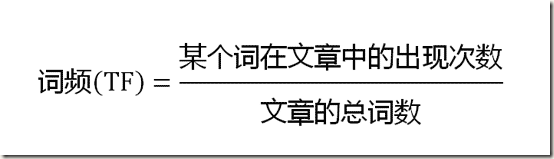
或者
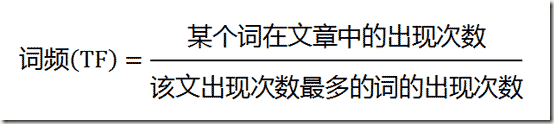
第二步,计算逆文档频率。
这时,需要一个语料库(corpus),用来模拟语言的使用环境。
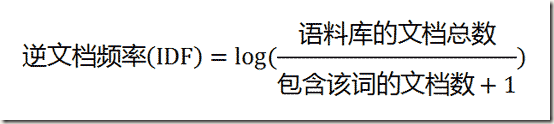
如果一个词越常见,那么分母就越大,逆文档频率就越小越接近0。分母之所以要加1,是为了避免分母为0(即所有文档都不包含该词)。log表示对得到的值取对数。
第三步,计算TF-IDF。

可以看到,TF-IDF与一个词在文档中的出现次数成正比,与该词在整个语言中的出现次数成反比。所以,自动提取关键词的算法就很清楚了,就是计算出文档的每个词的TF-IDF值,然后按降序排列,取排在最前面的几个词。
还是以《中国的蜜蜂养殖》为例,假定该文长度为1000个词,"中国"、"蜜蜂"、"养殖"各出现20次,则这三个词的"词频"(TF)都为0.02。然后,搜索Google发现,包含"的"字的网页共有250亿张,假定这就是中文网页总数。包含"中国"的网页共有62.3亿张,包含"蜜蜂"的网页为0.484亿张,包含"养殖"的网页为0.973亿张。则它们的逆文档频率(IDF)和TF-IDF如下:

从上表可见,"蜜蜂"的TF-IDF值最高,"养殖"其次,"中国"最低。(如果还计算"的"字的TF-IDF,那将是一个极其接近0的值。)所以,如果只选择一个词,"蜜蜂"就是这篇文章的关键词。
除了自动提取关键词,TF-IDF算法还可以用于许多别的地方。比如,信息检索时,对于每个文档,都可以分别计算一组搜索词("中国"、"蜜蜂"、"养殖")的TF-IDF,将它们相加,就可以得到整个文档的TF-IDF。这个值最高的文档就是与搜索词最相关的文档。
TF-IDF算法的优点是简单快速,结果比较符合实际情况。缺点是,单纯以"词频"衡量一个词的重要性,不够全面,有时重要的词可能出现次数并不多。而且,这种算法无法体现词的位置信息,出现位置靠前的词与出现位置靠后的词,都被视为重要性相同,这是不正确的。(一种解决方法是,对全文的第一段和每一段的第一句话,给予较大的权重。)
原文地址:http://www.ruanyifeng.com/blog/2013/03/tf-idf.html
[转]TF-IDF与余弦相似性的应用(一):自动提取关键词的更多相关文章
- TF-IDF与余弦相似性的应用(一):自动提取关键词
这个标题看上去好像很复杂,其实我要谈的是一个很简单的问题. 有一篇很长的文章,我要用计算机提取它的关键词(Automatic Keyphrase extraction),完全不加以人工干预,请问怎样才 ...
- TF-IDF与余弦相似性的应用(一):自动提取关键词 - 阮一峰的网络日志
TF-IDF与余弦相似性的应用(一):自动提取关键词 - 阮一峰的网络日志 TF-IDF与余弦相似性的应用(一):自动提取关键词 作者: 阮一峰 日期: 2013年3月15日 ...
- TF/IDF(term frequency/inverse document frequency)
TF/IDF(term frequency/inverse document frequency) 的概念被公认为信息检索中最重要的发明. 一. TF/IDF描述单个term与特定document的相 ...
- 基于TF/IDF的聚类算法原理
一.TF/IDF描述单个term与特定document的相关性TF(Term Frequency): 表示一个term与某个document的相关性. 公式为这个term在document中出 ...
- TF-IDF与余弦相似性的应用(二):找出相似文章
上一次,我用TF-IDF算法自动提取关键词. 今天,我们再来研究另一个相关的问题.有些时候,除了找到关键词,我们还希望找到与原文章相似的其他文章.比如,"Google新闻"在主新闻 ...
- 使用solr的函数查询,并获取tf*idf值
1. 使用函数df(field,keyword) 和idf(field,keyword). http://118.85.207.11:11100/solr/mobile/select?q={!func ...
- TF/IDF计算方法
FROM:http://blog.csdn.net/pennyliang/article/details/1231028 我们已经谈过了如何自动下载网页.如何建立索引.如何衡量网页的质量(Page R ...
- tf–idf算法解释及其python代码实现(下)
tf–idf算法python代码实现 这是我写的一个tf-idf的简单实现的代码,我们知道tfidf=tf*idf,所以可以分别计算tf和idf值在相乘,首先我们创建一个简单的语料库,作为例子,只有四 ...
- tf–idf算法解释及其python代码实现(上)
tf–idf算法解释 tf–idf, 是term frequency–inverse document frequency的缩写,它通常用来衡量一个词对在一个语料库中对它所在的文档有多重要,常用在信息 ...
- 文本分类学习(三) 特征权重(TF/IDF)和特征提取
上一篇中,主要说的就是词袋模型.回顾一下,在进行文本分类之前,我们需要把待分类文本先用词袋模型进行文本表示.首先是将训练集中的所有单词经过去停用词之后组合成一个词袋,或者叫做字典,实际上一个维度很大的 ...
随机推荐
- mac 安装配置java环境变量
1.下载java 地址:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 2.选择 ...
- Java 在给定路径上创建文件,所在文件夹不存在时,如何正确创建。
String strPath = "E:\\a\\aa\\aaa.txt"; File file = new File(strPath); if(!file.exists())){ ...
- go环境变量配置 (GOROOT和GOPATH)
GOROOT就是go的安装路径在~/.bash_profile中添加下面语句: GOROOT=/usr/local/go export GOROOT 当然, 要执行go命令和go工具, 就要配置go的 ...
- [LeetCode] Contains Duplicate & Contains Duplicate II
Contains Duplicate Given an array of integers, find if the array contains any duplicates. Your funct ...
- ssh转发
ssh有3种转发:本地转发,远程转发,动态转发. 1.本地转发:当client和ssh-client的方向一致的时候,就是本地转发. 限制:1)client直接访问server被防火墙阻挡.2)ssh ...
- [Leet Code]Path Sum II
此题如果 #1 和 #4 判断分支交换,大集合就会超时(因为每次对于非叶子节点都要判断是不是叶子节点).可见,有时候if else判断语句也会对于运行时间有较大的影响. import java.uti ...
- Bootstrap FileInput中文API整理
这段时间做项目用到bootstrap fileinput插件上传文件,在用的过程中,网上能查到的api都不是很全,所以想着整理一份比较详细的文档,方便自己今后使用,也希望能给大家带来帮助,如有错误,希 ...
- [AWS vs Azure] 云计算里AWS和Azure的探究(3)
云计算里AWS和Azure的探究(3) ——Amazon EC2 和 Windows Azure Virtual Machine 今天我来比较一下AWS EC2和Azure VM的具体流程上的异同.以 ...
- [Windows Azure] Windows Azure SQL Database library
Microsoft Windows Azure SQL Database extends SQL Server capabilities to the cloud. SQL Database offe ...
- vue-cli+webpack在生成的项目中使用bootstrap方法(二)
vue-cli+webpack在生成的项目中使用bootstrap方法(一)中,是通过手动下载bootstrap库,然后手动添加到src/assets中,显然是过程太多. 当然是可以更省力些,可以通过 ...