
Spark-自定义排序
一、自定义排序规则-封装类
import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

/**

  * 实现自定义的排序

  */

object MySort1 {

  def main(args: Array[String]): Unit = {

    //1.spark程序的入口

    val conf: SparkConf = new SparkConf().setAppName("MySort1").setMaster("local[2]")

    val sc: SparkContext = new SparkContext(conf)

    //2.创建数组

    val girl: Array[String] = Array("Mary,18,80","Jenny,22,100","Joe,30,80","Tom,18,78")

    //3.转换RDD

    val grdd1: RDD[String] = sc.parallelize(girl)

    //4.切分数据

    val grdd2: RDD[Girl] = grdd1.map(line => {

      val fields: Array[String] = line.split(",")

      //拿到每个属性

      val name = fields(0)

      val age = fields(1).toInt

      val weight = fields(2).toInt

      //元组输出

      //(name, age, weight)

      new Girl(name, age, weight)

    })

//    val sorted: RDD[(String, String, Int)] = grdd2.sortBy(t => t._2, false)

//    val r: Array[(String, String, Int)] = sorted.collect()

//    println(r.toBuffer)

    val sorted: RDD[Girl] = grdd2.sortBy(s => s)

    val r = sorted.collect()

    println(r.toBuffer)

    sc.stop()

  }

}

//自定义类 scala Ordered

class Girl(val name: String, val age: Int, val weight: Int) extends Ordered[Girl] with Serializable {

  override def compare(that: Girl): Int = {

    //如果年龄相同 体重重的往前排

    if(this.age == that.age){

      //如果正数 正序 负数 倒序

      -(this.weight - that.weight)

    }else{

      //年龄小的往前排

      this.age - that.age

    }

  }

  override def toString: String = s"名字:$name,年龄:$age,体重:$weight"

}
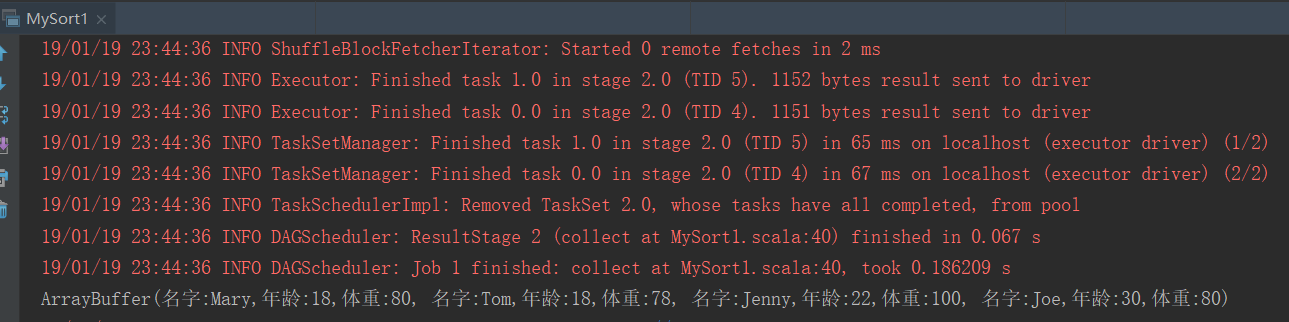
结果:
 二、
二、自定义排序规则-模式匹配
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.rdd.RDD

object MySort2 {

  def main(args: Array[String]): Unit = {

    //1.spark程序的入口

    val conf: SparkConf = new SparkConf().setAppName("MySort2").setMaster("local[2]")

    val sc: SparkContext = new SparkContext(conf)

    //2.创建数组

    val girl: Array[String] = Array("Mary,18,80","Jenny,22,100","Joe,30,80","Tom,18,78")

    //3.转换RDD

    val grdd1: RDD[String] = sc.parallelize(girl)

    //4.切分数据

    val grdd2: RDD[(String, Int, Int)] = grdd1.map(line => {

      val fields: Array[String] = line.split(",")

      //拿到每个属性

      val name = fields(0)

      val age = fields(1).toInt

      val weight = fields(2).toInt

      //元组输出

      (name, age, weight)

    })

    //5.模式匹配方式进行排序

    val sorted = grdd2.sortBy(s => Girl2(s._1, s._2, s._3))

    val r = sorted.collect()

    println(r.toBuffer)

    sc.stop()

  }

}

//自定义类 scala Ordered

case class Girl2(val name: String, val age: Int, val weight: Int) extends Ordered[Girl2] {

  override def compare(that: Girl2): Int = {

    //如果年龄相同 体重重的往前排

    if(this.age == that.age){

      //如果正数 正序 负数 倒序

      -(this.weight - that.weight)

    }else{

      //年龄小的往前排

      this.age - that.age

    }

  }

  override def toString: String = s"名字:$name,年龄:$age,体重:$weight"

}
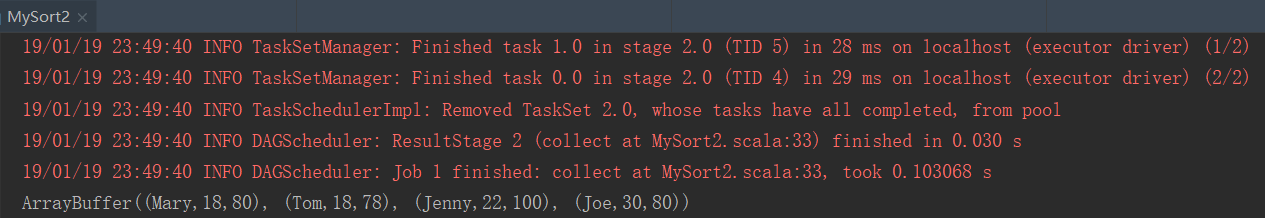
结果:
 三、
三、自定义排序规则-隐式转换
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.rdd.RDD

//定义一个专门处理隐式的类

object ImplicitRules {

  //定义隐式规则

  implicit object OrderingGirl extends Ordering[Girl1]{

    override def compare(x: Girl1, y: Girl1): Int = {

      if(x.age == y.age){

        //体重重的往前排

        -(x.weight - y.weight)

      }else{

        //年龄小的往前排

        x.age - y.age

      }

    }

  }

}

object MySort3 {

  def main(args: Array[String]): Unit = {

    //1.spark程序的入口

    val conf: SparkConf = new SparkConf().setAppName("MySort3").setMaster("local[2]")

    val sc: SparkContext = new SparkContext(conf)

    //2.创建数组

    val girl: Array[String] = Array("Mary,18,80","Jenny,22,100","Joe,30,80","Tom,18,78")

    //3.转换RDD

    val grdd1: RDD[String] = sc.parallelize(girl)

    //4.切分数据

    val grdd2 = grdd1.map(line => {

      val fields: Array[String] = line.split(",")

      //拿到每个属性

      val name = fields(0)

      val age = fields(1).toInt

      val weight = fields(2).toInt

      //元组输出

      (name, age, weight)

    })

    import ImplicitRules.OrderingGirl

    val sorted = grdd2.sortBy(s => Girl1(s._1, s._2, s._3))

    val r = sorted.collect()

    println(r.toBuffer)

    sc.stop()

  }

}

//自定义类 scala Ordered

case class Girl1(val name: String, val age: Int, val weight: Int)
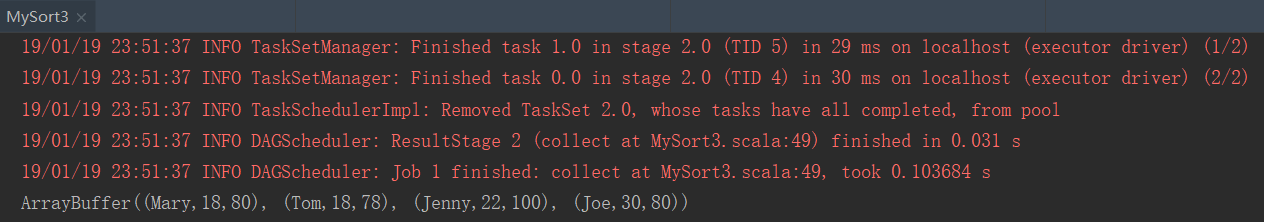
结果:
Spark-自定义排序的更多相关文章
- Spark(三)【RDD中的自定义排序】
在RDD中默认的算子sortBy,sortByKey只能真的值类型数据升序或者降序 现需要对自定义对象进行自定义排序. 一组Person对象 /** * Person 样例类 * @param nam ...
- 大数据学习day22------spark05------1. 学科最受欢迎老师解法补充 2. 自定义排序 3. spark任务执行过程 4. SparkTask的分类 5. Task的序列化 6. Task的多线程问题
1. 学科最受欢迎老师解法补充 day21中该案例的解法四还有一个问题,就是当各个老师受欢迎度是一样的时候,其排序规则就处理不了,以下是对其优化的解法 实现方式五 FavoriteTeacher5 p ...
- Spark基础排序+二次排序(java+scala)
1.基础排序算法 sc.textFile()).reduceByKey(_+_,).map(pair=>(pair._2,pair._1)).sortByKey(false).map(pair= ...
- spark高级排序彻底解秘
排序,真的非常重要! RDD.scala(源码) 在其,没有罗列排序,不是说它不重要! 1.基础排序算法实战 2.二次排序算法实战 3.更高级别排序算法 4.排序算法内幕解密 1.基础排序算法实战 启 ...
- 大数据学习day29-----spark09-------1. 练习: 统计店铺按月份的销售额和累计到该月的总销售额(SQL, DSL,RDD) 2. 分组topN的实现(row_number(), rank(), dense_rank()方法的区别)3. spark自定义函数-UDF
1. 练习 数据: (1)需求1:统计有过连续3天以上销售的店铺有哪些,并且计算出连续三天以上的销售额 第一步:将每天的金额求和(同一天可能会有多个订单) SELECT sid,dt,SUM(mone ...
- Java集合框架实现自定义排序
Java集合框架针对不同的数据结构提供了多种排序的方法,虽然很多时候我们可以自己实现排序,比如数组等,但是灵活的使用JDK提供的排序方法,可以提高开发效率,而且通常JDK的实现要比自己造的轮子性能更优 ...
- DataTable自定义排序
使用JQ DataTable 的时候,希望某列数据可以进行自定义排序,操作如下:(以中文排序和百分比排序为例) 1:定义排序类型: //百分率排序 jQuery.fn.dataTableExt.oSo ...
- 干货之UICollectionViewFlowLayout自定义排序和拖拽手势
使用UICollectionView,需要使用UICollectionViewLayout控制UICollectionViewCell布局,虽然UICollectionViewLayout提供了高度自 ...
- DataGridView 绑定List集合后实现自定义排序
这里只贴主要代码,dataList是已添加数据的全局变量,绑定数据源 datagridview1.DataSource = dataList,以下是核心代码. 实现点击列表头实现自定义排序 priva ...
- 【转】c++中Vector等STL容器的自定义排序
如果要自己定义STL容器的元素类最好满足STL容器对元素的要求 必须要求: 1.Copy构造函数 2.赋值=操作符 3.能够销毁对象的析构函数 另外: 1. ...
随机推荐
- Linux应急响应(一):SSH暴力破解
0x00 前言 SSH 是目前较可靠,专为远程登录会话和其他网络服务提供安全性的协议,主要用于给远程登录会话数据进行加密,保证数据传输的安全.SSH口令长度太短或者复杂度不够,如仅包含数字,或仅包 ...
- 国内CDN加速现状
什么是CDN CDN的全称是Content Delivery Network,即内容分发网络.是位于网络层与应用层之间的网络应用,其目的是通过在现有的Internet中增加一层新的网络架构,将网站的内 ...
- TOMCAT可以稳定支持的最大并发用户数
转自:http://blog.sina.com.cn/s/blog_68b7d2f50101ann7.html 服务器配置: 单硬盘,SATA 8MB缓存 测试服务器和loadrunner运行服务 ...
- hadoop自动提交脚本
自动提交到hadoop系统,然后调用wordcount的任务,并下载输出的文件. #!/bin/sh #从给定的路径获取文件列表,提交到hadoop系统,使用wordcount的功能统计单词数量 #e ...
- iOS - UITextView放在自定义cell里面-自适应高度
textView放在自定义cell里面-自适应高度 1,textView有个属性 scrollEnabled 要设置为NO; 2,设置tableview的时候 添加这两行代码: self.tabl ...
- 原创:超简单!windows配置NDK开发环境使用JNI
前段时间看android版的opencv的配置教程时,看到了它的NDK配置方法,感觉简单又不会出错!!! 1.下载NDK,设置NDK路径: 在windows的系统环境变量中添加NDK的路径,环境变量名 ...
- Delphi2010中DataSnap技术
文章来源: https://blog.csdn.net/xieyunc/article/details/47865227?_t_t_t=0.3049736963513836 一.为DataSnap系统 ...
- 【linux系列】centos安装vsftp
一.检查vsftpd软件 如果发现上不了网可以修改配置文件中的ONBOOT=no改为yes,然后重启服务试试
- css3整理--text-overflow
text-overflow语法: text-overflow : clip | ellipsis clip:表示不显示省略标记(...),而只是简单的裁切,需要在一定的高度范围内配合overflow: ...
- mysql optimize整理表碎片
当您的库中删除了大量的数据后,您可能会发现数据文件尺寸并没有减小.这是因为删 除操作后在数据文件中留下碎片所致.optimize table 可以去除删除操作后留下的数据文件碎片,减小文件尺寸,加快未 ...