
ElasticSearch AggregationBuilders java api常用聚会查询
以球员信息为例,player索引的player type包含5个字段,姓名,年龄,薪水,球队,场上位置。
index的mapping为:
"mappings": {

	"player": {

		"properties": {

			"name": {

				"index": "not_analyzed",

				"type": "string"

			},

			"age": {

				"type": "integer"

			},

			"salary": {

				"type": "integer"

			},

			"team": {

				"index": "not_analyzed",

				"type": "string"

			},

			"position": {

				"index": "not_analyzed",

				"type": "string"

			}

		},

		"_all": {

			"enabled": false

		}

	}

}
索引中的全部数据:
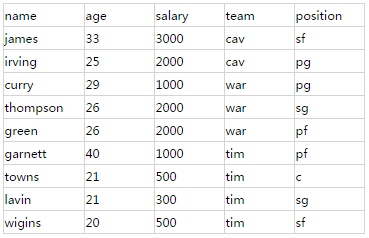
首先,初始化Builder:
SearchRequestBuilder sbuilder = client.prepareSearch("player").setTypes("player");
接下来举例说明各种聚合操作的实现方法,因为在es的api中,多字段上的聚合操作需要用到子聚合(subAggregation),初学者可能找不到方法(网上资料比较少,笔者在这个问题上折腾了两天,最后度了源码才彻底搞清楚T_T),后边会特意说明多字段聚合的实现方法。另外,聚合后的排序也会单独说明。
- group by/count
例如要计算每个球队的球员数,如果使用SQL语句,应表达如下:
select team, count(*) as player_count from player group by team;ES的java api:
TermsBuilder teamAgg= AggregationBuilders.terms("player_count ").field("team");

sbuilder.addAggregation(teamAgg);

SearchResponse response = sbuilder.execute().actionGet();
- group by多个field
例如要计算每个球队每个位置的球员数,如果使用SQL语句,应表达如下:
select team, position, count(*) as pos_count from player group by team, position;ES的java api:
TermsBuilder teamAgg= AggregationBuilders.terms("player_count ").field("team");

TermsBuilder posAgg= AggregationBuilders.terms("pos_count").field("position");

sbuilder.addAggregation(teamAgg.subAggregation(posAgg));

SearchResponse response = sbuilder.execute().actionGet();
- max/min/sum/avg
例如要计算每个球队年龄最大/最小/总/平均的球员年龄,如果使用SQL语句,应表达如下:
select team, max(age) as max_age from player group by team;ES的java api:
TermsBuilder teamAgg= AggregationBuilders.terms("player_count ").field("team");

MaxBuilder ageAgg= AggregationBuilders.max("max_age").field("age");

sbuilder.addAggregation(teamAgg.subAggregation(ageAgg));

SearchResponse response = sbuilder.execute().actionGet();
- 对多个field求max/min/sum/avg
例如要计算每个球队球员的平均年龄,同时又要计算总年薪,如果使用SQL语句,应表达如下:
select team, avg(age)as avg_age, sum(salary) as total_salary from player group by team;ES的java api:
TermsBuilder teamAgg= AggregationBuilders.terms("team");

AvgBuilder ageAgg= AggregationBuilders.avg("avg_age").field("age");

SumBuilder salaryAgg= AggregationBuilders.avg("total_salary ").field("salary");

sbuilder.addAggregation(teamAgg.subAggregation(ageAgg).subAggregation(salaryAgg));

SearchResponse response = sbuilder.execute().actionGet();
- 聚合后对Aggregation结果排序
例如要计算每个球队总年薪,并按照总年薪倒序排列,如果使用SQL语句,应表达如下:
select team, sum(salary) as total_salary from player group by team order by total_salary desc;ES的java api:
TermsBuilder teamAgg= AggregationBuilders.terms("team").order(Order.aggregation("total_salary ", false);

SumBuilder salaryAgg= AggregationBuilders.avg("total_salary ").field("salary");

sbuilder.addAggregation(teamAgg.subAggregation(salaryAgg));

SearchResponse response = sbuilder.execute().actionGet();
需要特别注意的是,排序是在TermAggregation处执行的,Order.aggregation函数的第一个参数是aggregation的名字,第二个参数是boolean型,true表示正序,false表示倒序。
- Aggregation结果条数的问题
默认情况下,search执行后,仅返回10条聚合结果,如果想反悔更多的结果,需要在构建TermsBuilder 时指定size:
TermsBuilder teamAgg= AggregationBuilders.terms("team").size(15);- Aggregation结果的解析/输出
得到response后:
Map<String, Aggregation> aggMap = response.getAggregations().asMap();

StringTerms teamAgg= (StringTerms) aggMap.get("keywordAgg");

Iterator<Bucket> teamBucketIt = teamAgg.getBuckets().iterator();

while (teamBucketIt .hasNext()) {

Bucket buck = teamBucketIt .next();

//球队名

String team = buck.getKey();

//记录数

long count = buck.getDocCount();

//得到所有子聚合

Map subaggmap = buck.getAggregations().asMap();

//avg值获取方法

double avg_age= ((InternalAvg) subaggmap.get("avg_age")).getValue();

//sum值获取方法

double total_salary = ((InternalSum) subaggmap.get("total_salary")).getValue();

//...

//max/min以此类推

}
- 总结
综上,聚合操作主要是调用了SearchRequestBuilder的addAggregation方法,通常是传入一个TermsBuilder,子聚合调用TermsBuilder的subAggregation方法,可以添加的子聚合有TermsBuilder、SumBuilder、AvgBuilder、MaxBuilder、MinBuilder等常见的聚合操作。
从实现上来讲,SearchRequestBuilder在内部保持了一个私有的 SearchSourceBuilder实例, SearchSourceBuilder内部包含一个List<AbstractAggregationBuilder>,每次调用addAggregation时会调用 SearchSourceBuilder实例,添加一个AggregationBuilder。
同样的,TermsBuilder也在内部保持了一个List<AbstractAggregationBuilder>,调用addAggregation方法(来自父类addAggregation)时会添加一个AggregationBuilder。有兴趣的读者也可以阅读源码的实现。
如果有什么问题,欢迎一起讨论,如果文中有什么错误,欢迎批评指正。
ElasticSearch AggregationBuilders java api常用聚会查询的更多相关文章
- Elasticsearch java api 常用查询方法QueryBuilder构造举例
转载:http://m.blog.csdn.net/u012546526/article/details/74184769 Elasticsearch java api 常用查询方法QueryBuil ...
- Elasticsearch中JAVA API的使用
1.Elasticsearch中Java API的简介 Elasticsearch 的Java API 提供了非常便捷的方法来索引和查询数据等. 通过添加jar包,不需要编写HTTP层的代码就可以开始 ...
- Java API 常用类(一)
Java API 常用类 super类详解 "super"关键字代表父类对象.通过使用super关键字,可以访问父类的属性或方法,也可以在子类构造方法中调用父类的构造方法,以便初始 ...
- ElasticSearch实战系列三: ElasticSearch的JAVA API使用教程
前言 在上一篇中介绍了ElasticSearch实战系列二: ElasticSearch的DSL语句使用教程---图文详解,本篇文章就来讲解下 ElasticSearch 6.x官方Java API的 ...
- 使用Java操作Elasticsearch(Elasticsearch的java api使用)
1.Elasticsearch是基于Lucene开发的一个分布式全文检索框架,向Elasticsearch中存储和从Elasticsearch中查询,格式是json. 索引index,相当于数据库中的 ...
- HDFS Java API 常用操作
package com.luogankun.hadoop.hdfs.api; import java.io.BufferedInputStream; import java.io.File; impo ...
- Elasticsearch Java API—多条件查询(must)
多条件设置 //多条件设置 MatchPhraseQueryBuilder mpq1 = QueryBuilders .matchPhraseQuery("pointid",&qu ...
- [ElasticSearch]Java API 之 词条查询(Term Level Query)
1. 词条查询(Term Query) 词条查询是ElasticSearch的一个简单查询.它仅匹配在给定字段中含有该词条的文档,而且是确切的.未经分析的词条.term 查询 会查找我们设定的准确值 ...
- ElasticSearch的java api
pom <dependencies> <dependency> <groupId>org.elasticsearch.client</groupId> ...
随机推荐
- redhat linux/CentOS 6/7 如何关闭防火墙?
redhat linux/CentOS 6/7 如何关闭防火墙?关闭防火墙iptables的具体命令如下: 临时性的完全关闭防火墙,可以不重启机器(但是重启服务器后iptables防火墙服务会自动随系 ...
- android dialog弹出的情况下监听返回键
view = LayoutInflater.from(getActivity()).inflate( R.layout.dialog_tips, null); title2 = (TextView) ...
- css盒子居中定位问题
在HTML中,div盒子的居中要通过外边距margin和width来控制,首先确定盒子的宽度,然后确定盒子方位并将其平移便可使盒子移到固定位置. <div id="divpic&quo ...
- 【转】shell学习笔记(二) ——shell变量
在shell中有3种变量:系统变量,环境变量和用户变量,其中系统变量在对参数判断和命令返回值判断时会使用,环境变量主要是在程序运行时需要设置,用户变量在编程过程中使用量最多. 1 系统变量 变量名 ...
- 【PHP】 PHPqrCode二维码类库使用方法
1.首先去官网下载PHPqrCode库文件,只需要里面的phpqrcode.php文件,下载地址:http://phpqrcode.sourceforge.net 2.二维码生成实例代码: <? ...
- 换行符\n和回车符\r
问题始于社区的一个帖子,楼主的问题如下: “在c语言中,对一个不知道大小的文件进行读操作,我用fread()将文件的内容先放到一个缓存区,然后将缓存区中的内容打印出来, 缓存区中的内容和文件中的内容不 ...
- [DeeplearningAI笔记]改善深层神经网络1.4_1.8深度学习实用层面_正则化Regularization与改善过拟合
觉得有用的话,欢迎一起讨论相互学习~Follow Me 1.4 正则化(regularization) 如果你的神经网络出现了过拟合(训练集与验证集得到的结果方差较大),最先想到的方法就是正则化(re ...
- Cypher查询语言--Neo4j 入门 (一)
目录 操作符 参数 标识符 注解 Start 通过id绑定点 通过id绑定关系 通过id绑定多个节点 所有节点 通过索引查询获取节点 通过索引查询获取关系 多个开始点 Cypher是一个描述性的图形 ...
- 面向对象编程之super内置函数的用法
先来看一段代码: 定义一个名叫People的父类,又定义了一个叫Teacher的老师类和一个叫Student的学生类 来继承People的类,并根据这两个子类实例化出两个对象s1和t1. class ...
- vue中如何获取后台数据
原文链接:http://blog.csdn.net/vergilgeekopen/article/details/68954940 需要引用vue-resource 安装请参考https://gith ...