
Python----Kernel SVM
什么是kernel
Kernel的其实就是将向量feature转换与点积运算合并后的运算,如下,
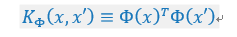
概念上很简单,但是并不是所有的feature转换函数都有kernel的特性。
常见kernel
常见kernel有多项式,高斯和线性,各有利弊。
kernel SVM
在非线性的SVM算法中,如何将一组线性不可分的数据,利用从低维到高维的投射,使它变成在高维空间中线性可分的数据。将已经分割好的数据,投射回到原先的空间,及低维空间。
(1)一维空间
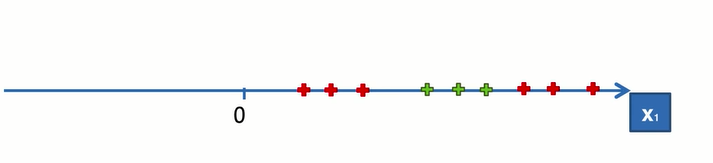
一维空间中的线性分类,找是否从在一个点,使一边都是红,一边都是绿,显然这样的线性分类器是不存在的。所以将数据投射到二维的空间里,例如:
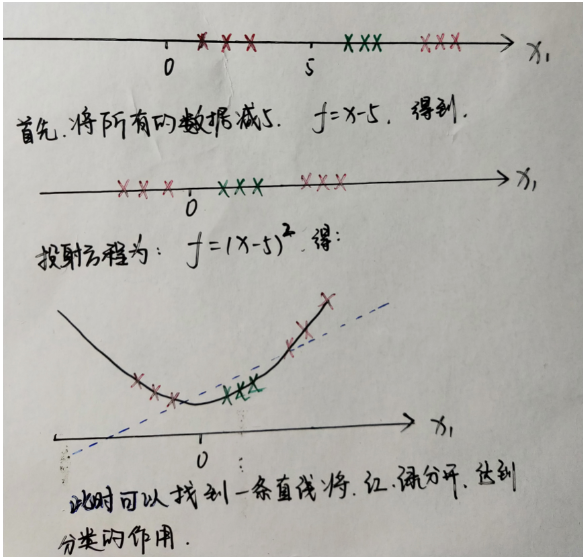
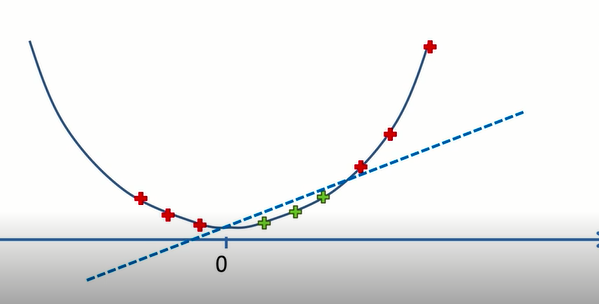
(2)二维
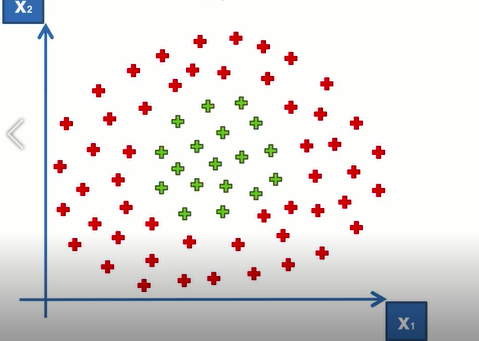
投射,保持X1轴和X2轴不变,增加第三个轴,将X1,X2两个点投射到一个三维空间里,前两个维度不变,第三个z与X1,X2有关系;在新的三维空间里,绿色和红色就变成了线性可分。线性可分在不是二维的空间中,有一个超平面,将两组数据分开。
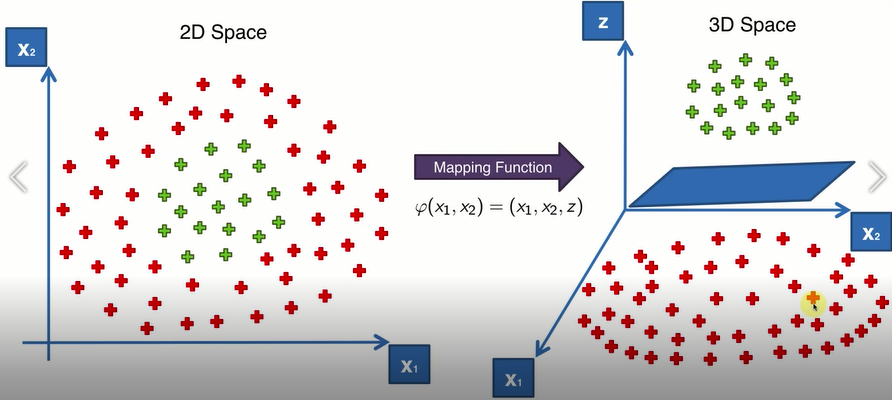
(3)反向投射
三维空间中找到的分割的平面,与数据本身结构,根据这两个信息,找出在原来数据空间二维空间中的分类界线。

核技巧在非线性SVM的应用
(1)非线性SVM最常用的核方程:

假设只有一个自变量X,而l已定,看成一个关于X的函数,此时的函数在空间中的形态
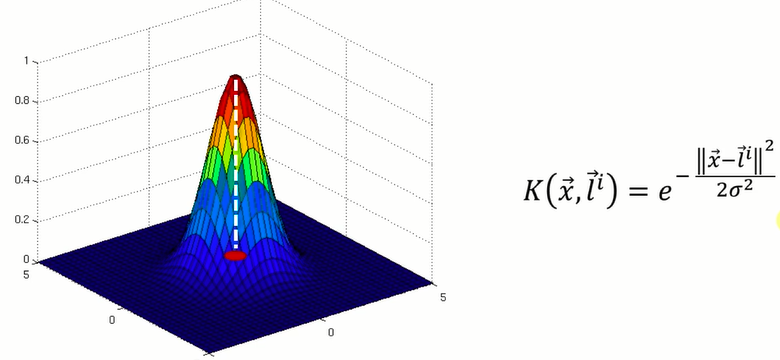 l点就是(0,0)这个点
利用高斯核函数算出分类函数:
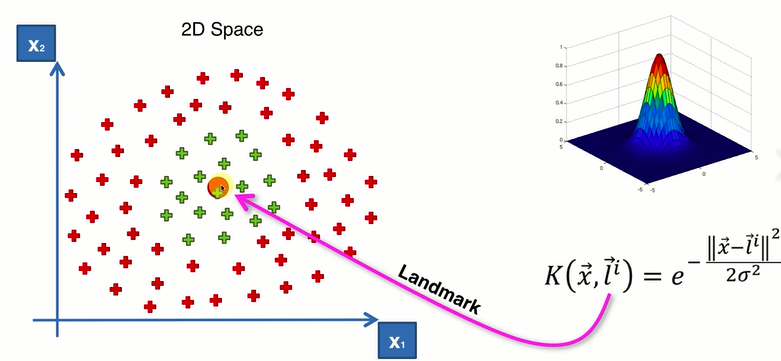
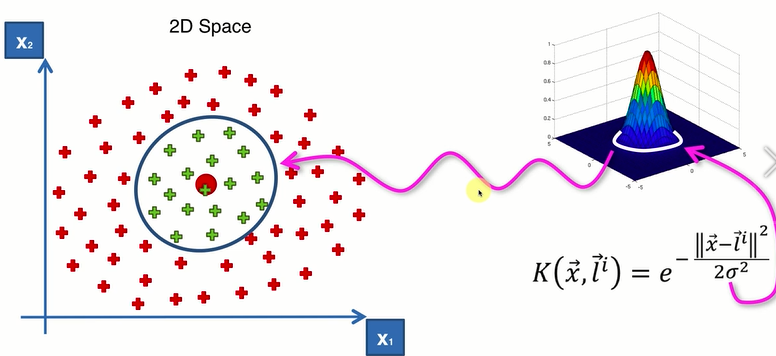
绿点所对应的高斯核函数的值,坐落在白色圈的里面(小山上);红点所对应的高斯核函数的值,坐落在周围深蓝色图像上。做出的投影图。
σ:控制圈的半径(大小)
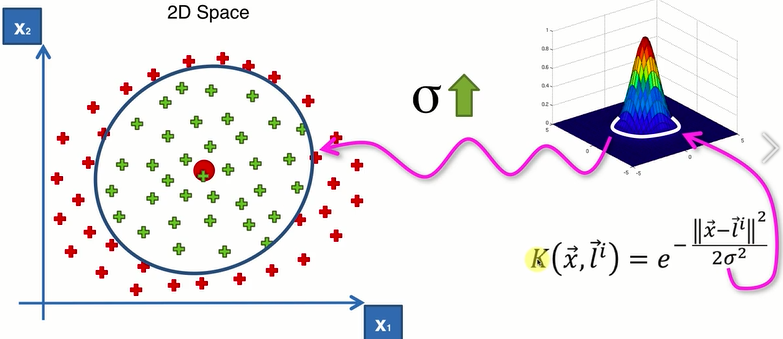
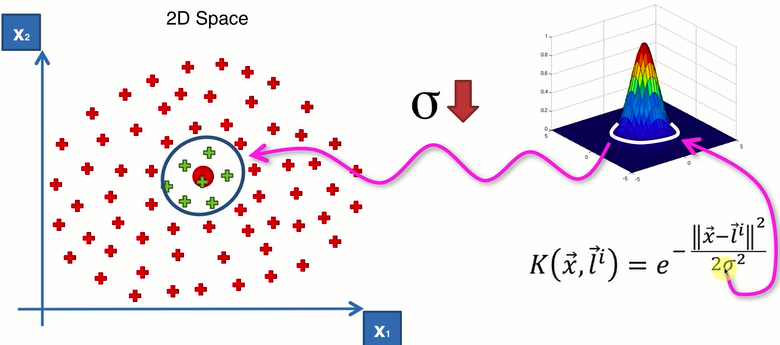
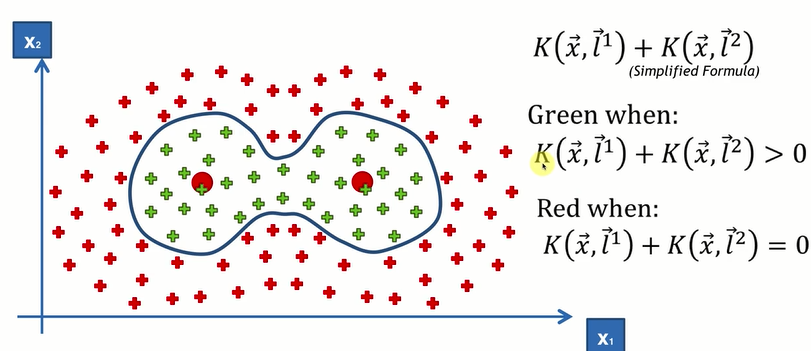
(2)较复杂的二维
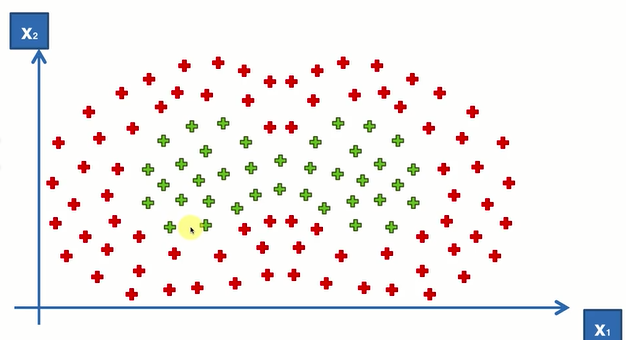 此时的核函数

实例
数据集

# Importing the libraries

import numpy as np

import matplotlib.pyplot as plt

import pandas as pd

# Importing the dataset

dataset = pd.read_csv('Social_Network_Ads.csv')

X = dataset.iloc[:, [2,3]].values

y = dataset.iloc[:, 4].values

# Splitting the dataset into the Training set and Test set

from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 0)

# Feature Scaling

from sklearn.preprocessing import StandardScaler

sc_X = StandardScaler()

X_train = sc_X.fit_transform(X_train)

X_test = sc_X.transform(X_test)

# Fitting Logistic Regression to the Training set

#训练集拟合SVM的分类器

#从模型的标准库中导入需要的类

from sklearn.svm import SVC

#创建分类器

classifier = SVC(kernel = 'rbf', random_state = 0)#rbf运用了高斯核

#运用训练集拟合分类器

classifier.fit(X_train, y_train)

# Predicting the Test set results

#运用拟合好的分类器预测测试集的结果情况

#创建变量(包含预测出的结果)

y_pred = classifier.predict(X_test)

# Making the Confusion Matrix

#通过测试的结果评估分类器的性能

#用混淆矩阵,评估性能

#65,24对应着正确的预测个数;8,3对应错误预测个数;拟合好的分类器正确率:(65+24)/100

from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred)

# Visualising the Training set results

#在图像看分类结果

from matplotlib.colors import ListedColormap

#创建变量

X_set, y_set = X_train, y_train

#x1,x2对应图中的像素;最小值-1,最大值+1,-1和+1是为了让图的边缘留白,像素之间的距离0.01;第一行年龄,第二行年收入

X1, X2 = np.meshgrid(np.arange(start = X_set[:, 0].min() - 1, stop = X_set[:, 0].max() + 1, step = 0.01),

                     np.arange(start = X_set[:, 1].min() - 1, stop = X_set[:, 1].max() + 1, step = 0.01))

#将不同像素点涂色,用拟合好的分类器预测每个点所属的分类并且根据分类值涂色

plt.contourf(X1, X2, classifier.predict(np.array([X1.ravel(), X2.ravel()]).T).reshape(X1.shape),

             alpha = 0.75, cmap = ListedColormap(('red', 'green')))

#标注最大值及最小值

plt.xlim(X1.min(), X1.max())

plt.ylim(X2.min(), X2.max())

#为了滑出实际观测的点(黄、蓝)

for i, j in enumerate(np.unique(y_set)):

    plt.scatter(X_set[y_set == j, 0], X_set[y_set == j, 1],

                c = ListedColormap(('orange', 'blue'))(i), label = j)

plt.title('Classifier (Training set)')

plt.xlabel('Age')

plt.ylabel('Estimated Salary')

#显示不同的点对应的值

plt.legend()

#生成图像

plt.show()

# Visualising the Test set results

from matplotlib.colors import ListedColormap

X_set, y_set = X_test, y_test

X1, X2 = np.meshgrid(np.arange(start = X_set[:, 0].min() - 1, stop = X_set[:, 0].max() + 1, step = 0.01),

                     np.arange(start = X_set[:, 1].min() - 1, stop = X_set[:, 1].max() + 1, step = 0.01))

plt.contourf(X1, X2, classifier.predict(np.array([X1.ravel(), X2.ravel()]).T).reshape(X1.shape),

             alpha = 0.75, cmap = ListedColormap(('red', 'green')))

plt.xlim(X1.min(), X1.max())

plt.ylim(X2.min(), X2.max())

for i, j in enumerate(np.unique(y_set)):

    plt.scatter(X_set[y_set == j, 0], X_set[y_set == j, 1],

                c = ListedColormap(('orange', 'blue'))(i), label = j)

plt.title('Classifier (Test set)')

plt.xlabel('Age')

plt.ylabel('Estimated Salary')

plt.legend()

plt.show()
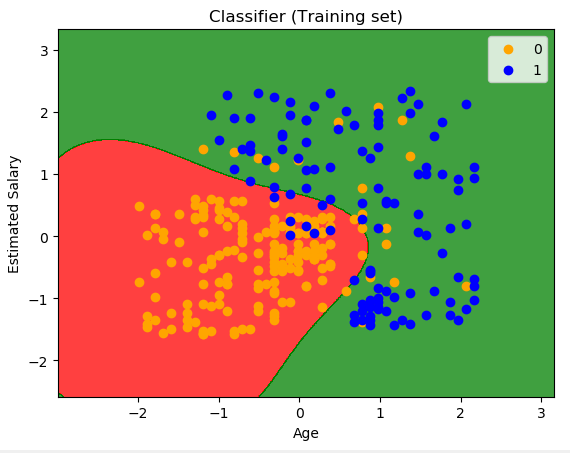
训练集图像显示结果:
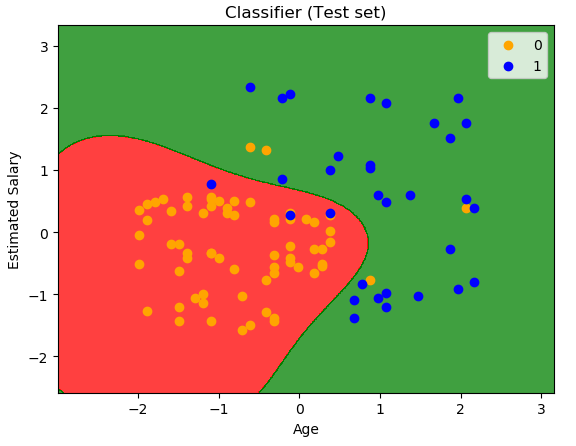
测试集图像显示结果:
Python----Kernel SVM的更多相关文章
- Kernel Methods (4) Kernel SVM
(本文假设你已经知道了hard margin SVM的基本知识.) 如果要为Kernel methods找一个最好搭档, 那肯定是SVM. SVM从90年代开始流行, 直至2012年被deep lea ...
- Python实现SVM(支持向量机)
Python实现SVM(支持向量机) 运行环境 Pyhton3 numpy(科学计算包) matplotlib(画图所需,不画图可不必) 计算过程 st=>start: 开始 e=>end ...
- 基于Python使用SVM识别简单的字符验证码的完整代码开源分享
关键字:Python,SVM,字符验证码,机器学习,验证码识别 1 概述 基于Python使用SVM识别简单的验证字符串的完整代码开源分享. 因为目前有了更厉害的新技术来解决这类问题了,但是本文作 ...
- (转载)python应用svm算法过程
除了在Matlab中使用PRTools工具箱中的svm算法,Python中一样可以使用支持向量机做分类.因为Python中的sklearn库也集成了SVM算法,本文的运行环境是Pycharm. 一.导 ...
- jupyter notebook添加Anaconda虚拟环境的python kernel
之前在自己博客上写了一个如何通过自建配置文件,让jupyter notebook可以调用conda虚拟环境的python解释器. 今天介绍一种更加简单的方式,无需手动配置文件,利用ipykernel可 ...
- 基于jupyter lab搭建网页编程环境并添加自定义python kernel和matlab kernel以及plotly的使用
内容转载自我的博客 目录 说明 1. 创建虚拟环境jupyter 2. 安装nodejs(用于jupyterlab安装扩展) 3. 安装pip包 4. 使用jupyterlab 5. 配置jupyte ...
- 【367】通过 python 实现 SVM 硬边界 算法
参考: 支持向量机整理 SVM 硬边界的结果如下: $$min \quad \frac{1}{2} \sum_{i=1}^m\sum_{j=1}^m \alpha_i\alpha_jy_iy_j \v ...
- 机器学习经典算法详解及Python实现--基于SMO的SVM分类器
原文:http://blog.csdn.net/suipingsp/article/details/41645779 支持向量机基本上是最好的有监督学习算法,因其英文名为support vector ...
- 机器学习——SVM详解(标准形式,对偶形式,Kernel及Soft Margin)
(写在前面:机器学习入行快2年了,多多少少用过一些算法,但由于敲公式太过浪费时间,所以一直搁置了开一个机器学习系列的博客.但是现在毕竟是电子化的时代,也不可能每时每刻都带着自己的记事本.如果可以掏出手 ...
- SVM之Python实现
SVM Python实现 Python实现SVM的理论知识 SVM原始最优化问题: \[ min_{w,b,\xi}{1\over{2}}{||w||}^2 + C\sum_{i=1}^m\xi^{( ...
随机推荐
- LeetCode算法题-Robot Return to Origin(Java实现)
这是悦乐书的第281次更新,第298篇原创 01 看题和准备 今天介绍的是LeetCode算法题中Easy级别的第149题(顺位题号是657).在2D平面上有一个从位置(0,0)开始的机器人.给定其移 ...
- 从壹开始微服务 [ DDD ] 之五 ║聚合:实体与值对象 (上)
前言 哈喽,老张是周四放松又开始了,这些天的工作真的是繁重,三个项目同时启动,没办法,只能在深夜写文章了,现在时间的周四凌晨,白天上班已经没有时间开始写文章了,希望看到文章的小伙伴,能给个辛苦赞
- 【Android Studio安装部署系列】三十六、从Android Studio3.1.4升级到Android studio3.2【以及创建android p模拟器(未成功)】
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 因为想要使用Android P模拟器,所以需要将Android Studio升级到3.2版本以上. 按照官网的说法:参考<ht ...
- ConfirmCancelUtilDialog【确认取消对话框封装类】
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 前言 对确认取消对话框的封装. 前提:调用对话框的Activity必须继承FragmentActivity及其子类(比如AppCompat ...
- java~接口的共享实体使用Map后更灵活
微服务时代的实体设计 在一个微服务时代,一个实体参数或者返回值,它可能是多服务之前共享的,而这个重复的实体你需要拷贝多份,这是违背DRP原则的,所以我们需要找一种更友好的方式来代替它,它就是Map,我 ...
- swagger文档转换为WebApiClient声明式代码
1 swagger简介 Swagger是一个规范且完整的框架,提供描述.生产.消费和可视化RESTful Web Service.其核心是使用json来规范描述RESTful接口,另外有提供UI来查看 ...
- Python实战171202元组访问
学生信息系统中数据为固定格式: (名字,年龄,性别,邮箱地址,......) 学生数量很大为了减小存储开销,对每个学生信息用元组表示: ('jim',18,'male','jim8765@gmail. ...
- 进阶!基于CentOS7系统使用cobbler实现单台服务器批量自动化安装不同版本系统(week3_day5_part2)-技术流ken
前言 在上一篇博文<cobbler批量安装系统使用详解-技术流ken>中已经详细讲解了cobbler的使用以及安装,本篇博文将会使用单台cobbler实现自动化批量安装不同版本的操作系统. ...
- git 取消对某个文件的跟踪
git rm --cached <fileName> 例如 : git add 后,不想提交在status里的.idea/vcs.xml.操作如下:
- 2.5 Cesium视域分析的实现
Cesium 视域分析 祝愿周末没事,技术继续分享交流,群685834990