
Cs231n-assignment 1作业笔记
KNN
assignment1 KNN讲解参见:
https://blog.csdn.net/u014485485/article/details/79433514?utm_source=blogxgwz5
np. flatnonzero(a) 返回a的展平版本中非零的索引。
a1 = np.random.choice(a=5, size=3, replace=False, p=None) 参数分别从a 中以概率p,随机选择3个, p没有指定的时候相当于是一致的分布。replacement的意思是抽样之后还放不放回去,如果是False的话,那么出来的三个数都不一样,如果是True的话, 有可能会出现重复的,因为前面抽的放回去了。
subplot(nrows, ncols, plot_number) 作用是把一个绘图区域(可以理解成画布)分成多个小区域,用来绘制多个子图。nrows和ncols表示将画布分成(nrows*ncols)个小区域,每个小区域可以单独绘制图形;plot_number表示将图绘制在第plot_number个子区域。举例: createPlot = subplot(222),表示画布分成(2*2=4)个小区域,并将图createPlot绘制在画布中的第二个子区域,也就是右上角位置。
imshow():https://matplotlib.org/api/pyplot_api.html#matplotlib.pyplot.imshow
astype('uint8'): 把图像数据类型转换为无符号八位整型,范围是0-255。如果输入图像是无符号八位整型的,返回的图像和源图像相同。
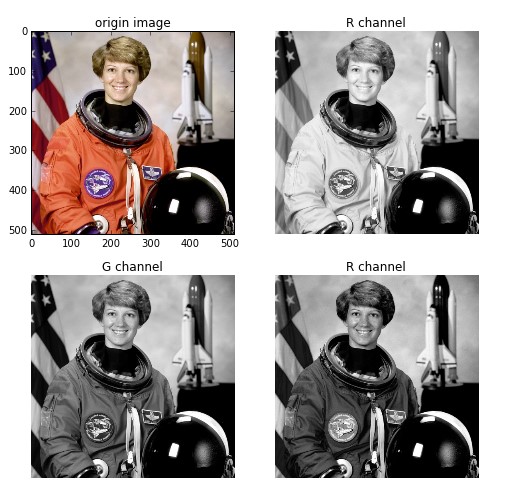
plt.axis('off') 不显示坐标尺寸,区别见下图:
numpy.reshape(a, newshape, order='C'):
a:array_like。要重新形成的数组。
newshape:int或tuple的整数。新的形状应该与原始形状兼容。如果是整数,则结果将是该长度的1-D数组。一个形状维度可以是-1。在这种情况下,从数组的长度和其余维度推断该值。
order:{'C','F','A'}可选。使用此索引顺序读取a的元素,并使用此索引顺序将元素放置到重新形成的数组中。'C'意味着使用C样索引顺序读取/写入元素,最后一个轴索引变化最快,回到第一个轴索引变化最慢。'F'意味着使用Fortran样索引顺序读取/写入元素,第一个索引变化最快,最后一个索引变化最慢。注意,'C'和'F'选项不考虑底层数组的内存布局,而只是参考索引的顺序。'A'意味着在Fortran类索引顺序中读/写元素,如果a 是Fortran 在内存中连续的,否则为C样顺序。
欧式距离(对应L2范数):最常见的两点之间或多点之间的距离表示法,又称之为欧几里得度量,它定义于欧几里得空间中。n维空间中两个点x1(x11,x12,…,x1n)与 x2(x21,x22,…,x2n)间的欧氏距离:
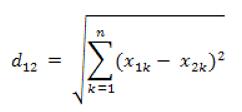
np.bincount():它大致说bin的数量比x中的最大值大1,每个bin给出了它的索引值在x中出现的次数。下面,我举个例子让大家更好的理解一下:x中最大的数为7,因此bin的数量为8,那么它的索引值为0->7
x = np.array([0, 1, 1, 3, 2, 1, 7])
索引0出现了1次,索引1出现了3次......索引5出现了0次......
np.bincount(x)
因此,输出结果为:array([1, 3, 1, 1, 0, 0, 0, 1])
np.argmax():取出a中元素最大值所对应的索引a = np.array([3, 1, 2, 4, 6, 1]),b=np.argmax(a) 此时最大值位6,其对应的位置索引值为4,(索引值默认从0开始)
np.argsort():将x中的元素从小到大排列,提取其对应的index(索引),然后输出到y。
KNN原理:找出距离最近的k个点对应的标签,然后找出出现次数最多的标签作为预测标签。
F范数:设A是mxn的矩阵,其F范数定义为:
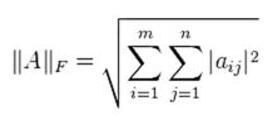
numpy.split(ary, indices_or_sections, axis=0):Split an array into multiple sub-arrays.
>>> x = np.arange(9.0)

>>> np.split(x,3)

[array([ 0.,  1.,  2.]), array([ 3.,  4., 5.]), array([ 6.,  7.,  8.])]
SVM
代码参见:https://blog.csdn.net/lifewang/article/details/80790493
matplotlib.rcParams设置:
matplotlib.rcParams[‘figure.figsize’]#图片像素
plt.rcParams['image.interpolation'] = 'nearest' # interpolation style(插值方式)
plt.rcParams['image.cmap'] = 'gray' # 设置 颜色 style
%load_ext autoreload %autoreload 2自动重新加载更改的模块
cell 4:取range(49000,50000)为验证集,取range(0,49000)为训练集,在训练集中随机选择500张为dev集,以加快训练速度。
cell7:图像预处理,均值减法(Mean subtraction)是预处理最常用的形式。它对数据中每个独立特征减去平均值,从几何上可以理解为在每个维度上都将数据云的中心都迁移到原点。在numpy中,该操作可以通过代码X -= np.mean(X, axis=0)实现。这个结果是将49000张图片的像素矩阵做了一个平均,得到了一个像素平均值矩阵,对应一张平均图片。
plt.figure(figsize=(4,4)):设置尺寸大小。
hstack(tup) :参数tup可以是元组,列表,或者numpy数组,返回结果为numpy的数组。按列顺序把数组给堆叠起来,最低维自动排序。
import numpy as np

a=[,,]

b=[,,]

print(np.hstack((a,b)))

输出:[      ]

import numpy as np

a=[[],[],[]]

b=[[],[],[]]

c=[[],[],[]]

d=[[],[],[]]

print(np.hstack((a,b,c,d)))

输出:

[[   ]

 [   ]

 [   ]]
svm_loss_naive(W, X, y, reg):W为权重,X为图片数据,y为标签,reg为正则化强度(regularization strength),返回值中gradient是梯度值,形状与W相同。
cell 16:利用验证集去调节超参数(正则化参数和学习率)。
SVM梯度计算理解:
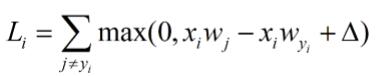
对上式求导dL/dw,j=yi时前面一项不存在了,j的规定中没有这一项,所以后一项对wyi求导剩下-xi,j≠yi时,对wj求导就是xi。
Softmax
Softmax梯度计算理解:
参见:https://blog.csdn.net/pjia_1008/article/details/66972060#commentsedit
参见:https://blog.csdn.net/yc461515457/article/details/51924604
其中第一个博客,当j!=yi时,分子应为exp(fj)。
Neural Network
思路参见:https://blog.csdn.net/lhppom/article/details/79595868
np.arange():
一个参数 默认起点0,步长为1。a = np.arange(3) 输出:[0 1 2]。
grads['b2'] = np.sum(dscores, axis = 0)/N:
这里的除于N和上式W2的除于N是因为最后的损失是各个损失的和除于N,有求导项1/N
Cs231n-assignment 1作业笔记的更多相关文章
- 笔记:CS231n+assignment1(作业一)
CS231n的课后作业非常的好,这里记录一下自己对作业一些笔记. 一.第一个是KNN的代码,这里的trick是计算距离的三种方法,核心的话还是python和machine learning中非常实用的 ...
- cs231n线性分类器作业 svm代码 softmax
CS231n之线性分类器 斯坦福CS231n项目实战(二):线性支持向量机SVM CS231n 2016 通关 第三章-SVM与Softmax cs231n:assignment1——Q3: Impl ...
- zabbix 应用监控作业笔记 ansible-playbook
目录 目录结构 zabbix-web.yaml zabbix-backup.yaml zabbix-nfs.yaml zabbix-mysql.yaml zabbix-server.yaml zabb ...
- DL基础:cs231n assignment 2
cs231n assignment 2 20210913 - 20211005. 目录 cs231n assignment 2 fully-connected nets 基本思想 编程细节 复习mul ...
- DL基础:cs231n assignment 1
cs231n assignment 1 20210804 - 20210808. 目录 cs231n assignment 1 总结 KNN 思想 cross-validation 编程细节 SVM ...
- 【cs231n作业笔记】一:KNN分类器
安装anaconda,下载assignment作业代码 作业代码数据集等2018版基于python3.6 下载提取码4put 本课程内容参考: cs231n官方笔记地址 贺完结!CS231n官方笔记授 ...
- 笔记:CS231n+assignment2(作业二)(一)
第二个作业难度很高,但做(抄)完之后收获还是很大的.... 一.Fully-Connected Neural Nets 首先是对之前的神经网络的程序进行重构,目的是可以构建任意大小的全连接的neura ...
- 【cs231n作业笔记】二:SVM分类器
可以参考:cs231n assignment1 SVM 完整代码 231n作业 多类 SVM 的损失函数及其梯度计算(最好)https://blog.csdn.net/NODIECANFLY/ar ...
- 笔记:CS231n+assignment2(作业二)(二)
一.参数更新策略 1.SGD 也就是随机梯度下降,最简单的更新形式是沿着负梯度方向改变参数(因为梯度指向的是上升方向,但是我们通常希望最小化损失函数).假设有一个参数向量x及其梯度dx,那么最 ...
- 笔记:CS231n+assignment2(作业二)(三)
终于来到了最终的大BOSS,卷积神经网络~ 这里我想还是主要关注代码的实现,具体的CNN的知识点想以后在好好写一写,CNN的代码关键就是要加上卷积层和池话层. 一.卷积层 卷积层的前向传播还是比较容易 ...
随机推荐
- 【Spark篇】---SparkStream初始与应用
一.前述 SparkStreaming是流式处理框架,是Spark API的扩展,支持可扩展.高吞吐量.容错的实时数据流处理,实时数据的来源可以是:Kafka, Flume, Twitter, Zer ...
- oracle调整内存大小
1.查看已分配内存,看到memory_max_target为20GSQL> show parameter sga NAME TYPE VALUE- ...
- Session知识点
知识点概要 - Session - CSRF - Model操作 - Form验证(ModelForm) - 中间件 - 缓存 - 信号 内容详细: 1. S ...
- C++日志系统log4cxx使用总结
原文地址:C++日志系统log4cxx使用总结作者:邵明 本文主要从log4cxx级别.layout.格式化.命名规则.Filter几个方面介绍. 一.log4cxx命名规则 Lo ...
- 使用dotnet build时复制引用dll到生成目录
默认配置下dotnet build只会输出项目代码的dll,依赖用的是dotnet缓存中的dll,只有dotnet publish才会把依赖的dll一起输出到生成目录. 在项目csproj文件中添加以 ...
- php_D3_“简易聊天室 ”实现的关键技术 详解
PHP+MySQL实现Internet上一个简易聊天室的关键技术 系统目标: 聊天室使用数据库汇集每个人的发言,并可将数据库内的发言信息显示在页面,让每个用户都可 ...
- I-think-2
最近自己的压力的确很大,对自己近期思想情况做一个总结. 本来假期都自己的未来已经做了一个详细的规划:其中近期的目标就是考上一所自己心仪的大学去读研究生,并且自己也选好了大学,作为自己研究生的目标--- ...
- python:数据库连接操作入门
模块 import pymssql,pyodbc 模块说明 pymssql和pyodbc模块都是常用的用于SQL Server.MySQL等数据库的连接及操作的模块,当然一些其他的模块也可以进行相应的 ...
- RDIFramework.NET ━ .NET快速信息化系统开发框架 V3.2->Web版本工作流部分业务处理界面与查看界面全新展示
RDIFramework.NET工作流程组件是以RDIFramework.NET框架为支撑,根据我们多年的项目经验和项目实践,结合国内各大工作流产品的特点研发的一套流程管理组件.该组件不仅考虑到从零搭 ...
- 流式大数据计算实践(7)----Hive安装
一.前言 1.这一文学习使用Hive 二.Hive介绍与安装 Hive介绍:Hive是基于Hadoop的一个数据仓库工具,可以通过HQL语句(类似SQL)来操作HDFS上面的数据,其原理就是将用户写的 ...