
tensorflow 学习纪录(持续更新)
 import tensorflow as tf

 import numpy as np

 #tensor = tf.constant([[1,2,3,4,5,6,7,8],[1,2,3,4,5,6,7,8]])

 tensor = tf.placeholder(tf.int32, [2,8])

 with tf.Session() as sess:

     sess.run(tf.global_variables_initializer())

     print sess.run(tensor,feed_dict={tensor:[[1,2,3,4,5,6,7,8],[1,2,3,4,5,6,7,8]]})

     print sess.run(tensor)

     tensorReshape = tf.reshape(tensor,[-1,4])

     print sess.run(tensorReshape)
print sess.run(tensor) 会报错,
InvalidArgumentError (see above for traceback): You must feed a value for placeholder tensor 'Placeholder' with dtype int32 and shape [2,8]
[[Node: Placeholder = Placeholder[dtype=DT_INT32, shape=[2,8], _device="/job:localhost/replica:0/task:0/device:CPU:0"]()]]
原因:feed 使用一个 tensor 值临时替换一个操作的输出结果. 你可以提供 feed 数据作为 run() 调用的参数. feed 只在调用它的方法内有效, 方法结束, feed 就会消失。
tensorflow 加减op实验结果
y_out = tf.constant([1.0,2.0,3.0],shape=[3])

#y_out = tf.constant([[1.0,2.0,3.0],[2.0,3.0,4.0]],shape=[2,3])

yy = tf.constant([[1.0,2.0,3.0],[4.0,5.0,6.0],[1.0,2.0,3.0]],shape=[3,3])

print sess.run(y_out+yy)
二维和三维矩阵相乘
tf.matmul(M1,M2)
三维*二维
M1 = tf.Variable(tf.random_normal([2,3,4])
M2 = tf.Variable(tf.random_normal([5,4])
N = tf.einsum('ijk,lk->ijl',M1,M2)
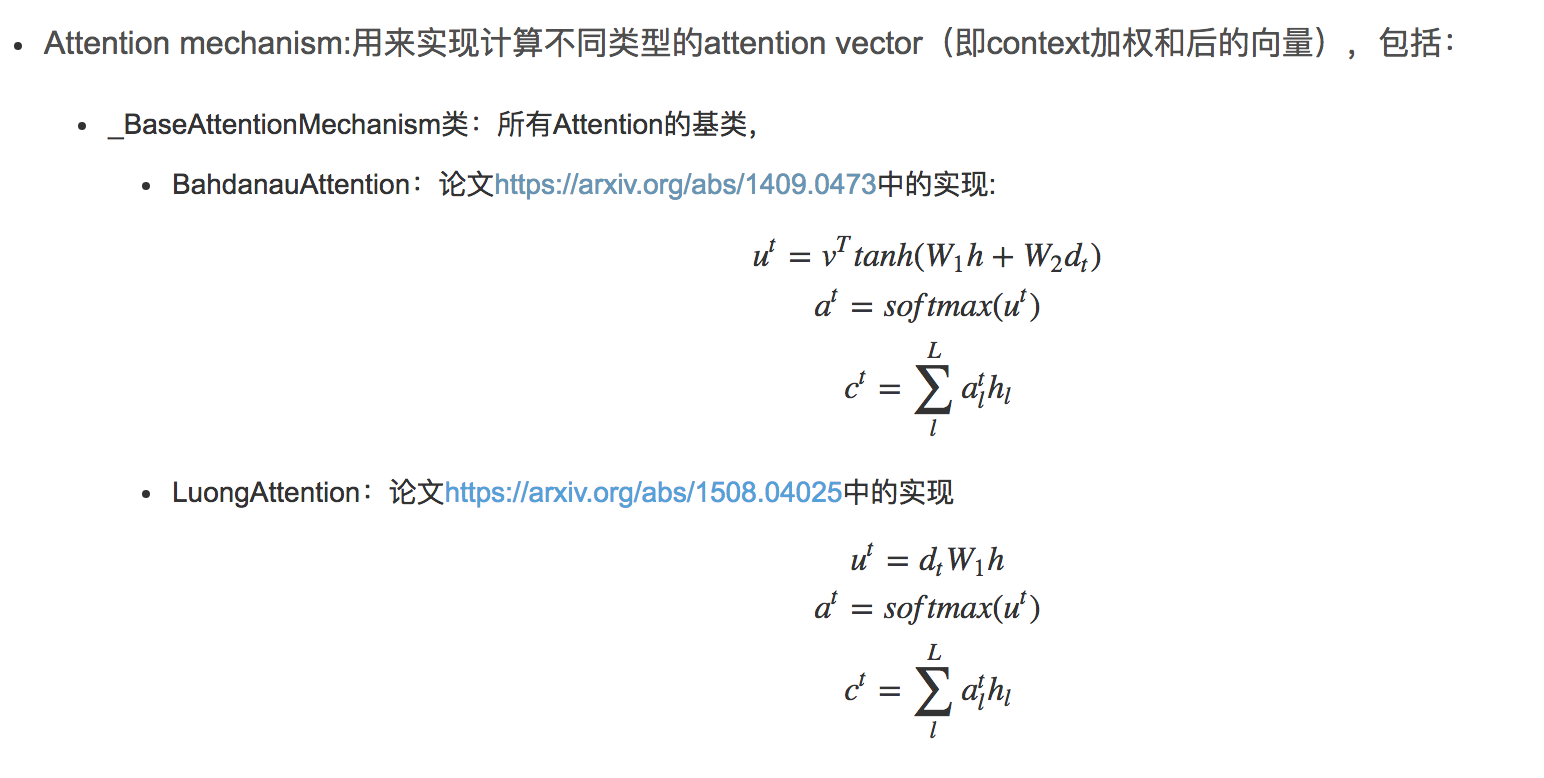
tensorflow attention
tensorflow.python.framework.errors_impl.InvalidArgumentError: Cannot assign a device for operation 'Adadelta/update_post_embedding/Cast': Could not satisfy explicit device specification '' because the node was colocated with a group of nodes that required incompatible device '/job:localhost/replica:0/task:0/device:GPU:0'
安装完tensorflow-gpu版本后,跑程序会报这样的错,是因为GPU不支持一些op运算。
解决办法是安装对应的tensorflow cpu版本就完美解决了。
参考:https://github.com/cysmith/neural-style-tf/issues/18
tensorflow-gpu 1.4.1 不支持这两个函数
#optimizer = tf.train.AdadeltaOptimizer(learning_rate=1)
#optimizer = tf.train.AdagradOptimizer(learning_rate=0.1)
tensorflow 学习纪录(持续更新)的更多相关文章
- 【pwn】学pwn日记——栈学习(持续更新)
[pwn]学pwn日记--栈学习(持续更新) 前言 从8.2开始系统性学习pwn,在此之前,学习了部分汇编指令以及32位c语言程序的堆栈图及函数调用. 学习视频链接:XMCVE 2020 CTF Pw ...
- Pig基础学习【持续更新中】
*本文参考了Pig官方文档以及已有的一些博客,并加上了自己的一些知识性的理解.目前正在持续更新中.* Pig作为一种处理大规模数据的高级查询语言,底层是转换成MapReduce实现的,可以作为MapR ...
- [读书]10g/11g编程艺术深入体现结构学习笔记(持续更新...)
持续更新...) 第8章 1.在过程性循环中提交更新容易产生ora-01555:snapshot too old错误.P257 (这种情况我觉得应该是在高并发的情况下才会产生) 假设的一个场景是系统一 ...
- Java同步学习(持续更新)
在需要考虑线程安全性的场合,可以考虑以下五种方式来实现线程的安全性: 1.同步方法 即有synchronized关键字修饰的方法. 由于java的每个对象都有一个内置锁,当用此关键字修饰方法时, ...
- Linux学习历程(持续更新整理中)
1.文件目录操作命令 (1) ls 显示文件和目录列表 a ls -l 显示文件的详细信息 b ls -a 列出当前目录的所有文件,包含隐藏文件. c stat '目录/文件' 显示指定目录 ...
- 数据分析之Pandas和Numpy学习笔记(持续更新)<1>
pandas and numpy notebook 最近工作交接,整理电脑资料时看到了之前的基于Jupyter学习数据分析相关模块学习笔记.想着拿出来分享一下,可是Jupyter导出来h ...
- Python基础学习总结(持续更新)
https://www.cnblogs.com/jin-xin/articles/7459977.html 嗯,学完一天,白天上班,眼睛要瞎了= = DAY1 1,计算机基础. CPU:相当于人的大脑 ...
- Cadence物理库 LEF 文件语法学习【持续更新】
我是 雪天鱼,一名FPGA爱好者,研究方向是FPGA架构探索. 关注公众号,拉你进"IC设计交流群". @ 目录 一.LEF简介 1.1 通用规则 1.2 管理 LEF 文件 二. ...
- [Hadoop] Hadoop学习历程 [持续更新中…]
1. Hadoop FS Shell Hadoop之所以可以实现分布式计算,主要的原因之一是因为其背后的分布式文件系统(HDFS).所以,对于Hadoop的文件操作需要有一套全新的shell指令来完成 ...
随机推荐
- js 如何判断数组元素是否存在重复项
1.如何判断数组元素是否存在重复项 1)定义测试数组 //定义测试的数组(1个没有重复元素,1个有重复元素) var arr1 = new Array("111","33 ...
- 开发企业微信打卡API笔记
获取企业微信打开API上面的数据 根据企业ID和打卡模块的secret获取access_token 打卡传参body为json格式的字符传 创建打卡对象把参数写入,useridlist为list格式. ...
- matlab 将数字矩阵转换成图像
MATLAB中,常常使用imshow()函数来显示图像,而此时的图像矩阵可能经过了某种运算.在matlab中,为了保证精度,经过了运算的图像矩阵I其数据类型会从unit8型变成double型.如果直接 ...
- python之路-变量
变量定义的规则: - 变量名只能是字母.数字.或下划线的任意组合 - 变量名的第一个字符不能是数字 - 以下关键字不能声明为变量名 ['and','as','assert','break','cla ...
- Python输入数组(一维数组、二维数组)
一维数组: arr = input("") //输入一个一维数组,每个数之间使空格隔开 num = [int(n) for n in arr.split()] //将输入每个数以空 ...
- 软工作业(JAVA)
github传送门:https://github.com/hhg52516/WC.git 项目要求 wc.exe 是一个常见的工具,它能统计文本文件的字符数.单词数和行数.这个项目要求写一个命令行程序 ...
- python简单爬虫 用lxml解析页面中的表格
目标:爬取湖南大学2018年在各省的录取分数线,存储在txt文件中 部分表格如图: 部分html代码: <table cellspacing="0" cellpadding= ...
- 002dayPython学习编码
由于计算机是美国人发明的,所以计算机最开始只能识别256个字符(ASCII码),而你在计算机中输入中文就会报错 而中国人想让计算机认识中文,就重新编写了一套支持中文的编码(GB2312) 随后由于GB ...
- 信息技术手册可视化进度报告 基于jieba的关键字提取技术
在这一篇博客之前,我已经将word文件中的内容通过爬虫的方式整理到数据库中了,但是为了前台展示的需要,还必须提取出关键字,用于检索. 我用的是jieba分词,GitHub地址:https://gith ...
- Maven中遇到Unsupported major.minor version 51.0错误
将错误复制到某度上,查询出结果显示JDK版本不匹配. 我按着步骤执行结束后还是有以下错误: 配置: Tomcat: 最终解决: 我在Initialize的时候使用的版本是JDK1.8的,导致的这个错误 ...