
Python 爬虫学习 网页图片下载
- 使用正则表达式匹配
# coding:utf-8

import  re

import urllib

def get_content(url):

    """ Evilxr, """

    html = urllib.urlopen(url)

    content = html.read()

    html.close()

    return content

def get_images(info):

    """" Download Baidu pictures.

    <img class="BDE_Image" src="http:*****">

    """

    regex = r' class="BDE_Image" src="(.+?\.jpg)" '

    pat = re.compile(regex)

    images_code = re.findall(pat, info)

    i = 0

    for image_url in images_code:

        print image_url

        urllib.urlretrieve(image_url, '%s.jpg' % i)

        i = i +1

    print len(images_code)

info = get_content("http://tieba.baidu.com/p/2299704181")

print get_images(info)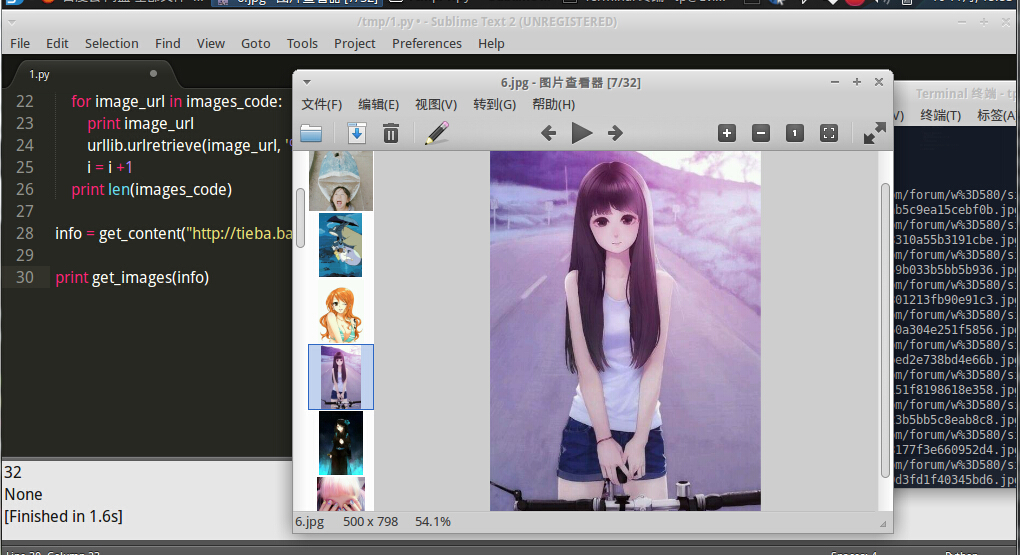
- 使用第三方库BeautifulSoup匹配
# 安装 sudo pip install beautifulsoup4
# coding:utf-8

import urllib

from bs4 import BeautifulSoup

def get_content(url):

    """ Evilxr, """

    html = urllib.urlopen(url)

    content = html.read()

    html.close()

    return content

def get_images(info):

    """

     使用BeautifulSoup在网页源码中匹配图片地址

    """

    soup = BeautifulSoup(info)

    all_img = soup.find_all('img', class_="BDE_Image" )

    i = 1

    for img in all_img:

        print img['src']

        urllib.urlretrieve(img['src'], '%s.jpg' % i)

        i = i +1

    print "一共下载了 ", len(all_img), "张图片"

info = get_content("http://tieba.baidu.com/p/3368845086")

print get_images(info)
Python 爬虫学习 网页图片下载的更多相关文章
- Python爬虫之网页图片抓取
一.引入 这段时间一直在学习Python的东西,以前就听说Python爬虫多厉害,正好现在学到这里,跟着小甲鱼的Python视频写了一个爬虫程序,能实现简单的网页图片下载. 二.代码 __author ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- Python实战:美女图片下载器,海量图片任你下载
Python应用现在如火如荼,应用范围很广.因其效率高开发迅速的优势,快速进入编程语言排行榜前几名.本系列文章致力于可以全面系统的介绍Python语言开发知识和相关知识总结.希望大家能够快速入门并学习 ...
- Python实战:Python爬虫学习教程,获取电影排行榜
Python应用现在如火如荼,应用范围很广.因其效率高开发迅速的优势,快速进入编程语言排行榜前几名.本系列文章致力于可以全面系统的介绍Python语言开发知识和相关知识总结.希望大家能够快速入门并学习 ...
- python爬虫学习视频资料免费送,用起来非常666
当我们浏览网页的时候,经常会看到像下面这些好看的图片,你是否想把这些图片保存下载下来. 我们最常规的做法就是通过鼠标右键,选择另存为.但有些图片点击鼠标右键的时候并没有另存为选项,或者你可以通过截图工 ...
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- python爬虫抓网页的总结
python爬虫抓网页的总结 更多 python 爬虫 学用python也有3个多月了,用得最多的还是各类爬虫脚本:写过抓代理本机验证的脚本,写过在discuz论坛中自动登录自动发贴的脚本,写过自 ...
随机推荐
- .ipynb文件 与ipython notebook
没有安装ipython notebook 后看见.ipynb文件直接手足无措了 一.安装ipython notebook 使用命令 pip ipython [all] 为所有用户安装 ipython ...
- seek指针大文件上传
package mainimport ( // "bufio" "fmt" "github.com/axgle/mahonia&qu ...
- Spring + Mybatis 使用 PageHelper 插件分页
原文:http://www.cnblogs.com/yucongblog/p/5330886.html 先增加maven依赖: <dependency> <groupId>co ...
- php注意事项2
1.不要使用相对路径 常常会看到: require_once('../../lib/some_class.php'); 该方法有很多缺点: 它首先查找指定的php包含路径, 然后查找当前目录. 因此会 ...
- Spring Boot工程发布到Docker
先聊聊闲话 搞过企业级的application运维的同仁肯定深有感触,每个application的功能交叉错杂,数据交换就让人焦头烂额(当然这和顶层业务设计有关系), 几十个application发布 ...
- Mysqldump源码分析
版权声明:本文由王珏原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/261 来源:腾云阁 https://www.qclou ...
- angular中的代码执行顺序和$scope.$digest();
angular中,在一个controller里$scope.whatever=function(){...} ,这样写只是在这个scope作用域里定义了一个函数,如果要执行的话还得在这个control ...
- win7文件夹共享(不新建账户、不带密码直接访问)
1.右键需要共享的文件夹>共享>特定用户>选择Everyone>“添加”>“共享” 2.打开控制面板>按类别的查看方式>网络和Internet下的选择家庭组和 ...
- 鼠标滚轮控制侧边div上下翻动效果
css部分: <style> * { margin: 0; padding: 0;} .wrap { width: 1000px; margin: 0 auto; overflow: hi ...
- 用纯Css作三角形
<style> //向上三角形 .triangle_up{ width:0; height:0; border-left:30px solid transparent; border-ri ...