
人人贷网的数据爬取(利用python包selenium)
记得之前应同学之情,帮忙爬取人人贷网的借贷人信息,综合网上各种相关资料,改善一下别人代码,并能实现数据代码爬取,具体请看我之前的博客:http://www.cnblogs.com/Yiutto/p/5890906.html。
但过了一段时间,发现之前的代码运行不能爬取到数据,而且数据爬取过多也会出现一些错误(我估摸这后台检测到同一个帐号过多访问,给强制下线了)老是弹出下面的错误如下图: 总而言之,代码可用性不高,性能不是很好。
def parse_userinfo(loanid):
timestamp=str(int(time.time())) + '%03d' % random.randint(0,999)
urll="http://www.we.com/lend/detailPage.action?loanId=%.0f×tamp=" % loanid+timestamp
result = s.get(urll,headers=headers)
html = BeautifulSoup(result.text,'lxml')
info = html.find_all('table',class_="ui-table-basic-list")
info1= info[0]
info2 = info1.find_all('div',class_="basic-filed")
userinfo = {}
for item in info2:
vartag = item.find('span')
var = vartag.string
if var == '信用评级':
var = '信用评分'
pf1 = repr(item.find('em'))
value = re.findall(r'\d+',pf1)
else:
valuetag = item.find('em')
value = valuetag.string
userinfo[var]=value
data = pd.DataFrame(userinfo)
return data

后根据错误进行分析,发现原来是根本获取不到借贷人信息出现的错误,
就是info = html.find_all('table',class_="ui-table-basic-list")执行这条语句,info是空的,意思就是根本找class_="ui-table-basic-list"这个东东,后来思前想后,发现,原来人人贷网站需要用户登录才能看到其相应的借贷人信息。也就是说在爬取数据时,需要用户登录。回顾之前的代码,我想是保存cookie这种方法是不能用了。必须找到一种新的方法来模拟登录网站。查了许多资料,数据捉取无外乎有3种方法:1.直接抓取数据。 2.模拟浏览器抓取数据。 3.基于API接口抓取数据
综合分析,我决定用第2种方法"模拟浏览器登录",那得找好相应的python包,网上有:mechanize,selenium等等。
1.mechanize包的尝试
br.select_form(nr = 0) # Find the login form

br['vb_login_username'] = '你的用户名'

br['vb_login_password'] = '你的注册密码'
这段代码中老是遇到问题,第一,select_form中的nr怎么找,第二,在人人贷网站源代码中如何找所谓的'vb_login_username','vb_login_password'的专有名词。
其实我在代码测试中还是找到对于的nr=0,但是找了好久找不到对应的'vb_login_username'。(个人不太懂html,学的比较菜,有兴趣的可以尝试一下)。后来听朋友说可以试试selenium。
前面废话说了一大堆,都是我学的比较菜,也就是我的经验之谈。
2.selenium包的尝试(重点)
首先你得安装好它,直接pip install selenium即可。而且还要下载相应的浏览器驱动(这里我的运行环境是linux,python好像是3.0以上的,浏览器是firefox)
驱动的下载地址为https://github.com/mozilla/geckodriver/releases(下载好自己系统的版本),然后放到相应的PATH路径中,否则找不到driver。
Window下驱动的放置位置:
将geckodriver.exe复制到C:\Program Files (x86)\mozilla firefox目录下;
并在环境变量Path中添加路径:C:\Program Files (x86)\mozilla firefox;
重启cmd,再次运行即可;
Linux下驱动的放置位置:
解压后将geckodriver存放至 /usr/local/bin/ 路径下即可
sudo mv ~/Downloads/geckodriver /usr/local/bin/
相应代码如下:
from selenium import webdriver

from selenium.webdriver.common.keys import Keys

import time

import pandas as pd

import re

import numpy as np

from bs4 import BeautifulSoup

driver = webdriver.Firefox()

def LoginRRD(username, password):

    try:

        print(u'准备登陆人人贷网站...')

        driver.get("https://www.we.com/loginPage.action")

        elem_user = driver.find_element_by_name("j_username")

        elem_user.send_keys(username)

        elem_pwd = driver.find_element_by_name("j_password")

        elem_pwd.send_keys(password)

        elem_rem = driver.find_element_by_name("rememberme")

        elem_rem.submit()

        time.sleep(1) #这里设置睡眠时间,是为了使浏览器有时间保存cookies

        print(u'登录 successful!')

    except Exception as e:

        print("Error:", e)

    finally:

        print(u'End Login!\n')

def parse_userinfo(loanid):#自定义解析借贷人信息的函数

    urll="http://www.we.com/loan/%s"  % loanid

    #这个urll我也不知道怎么来的,貌似可以用urll="http://www.we.com/loan/%f" % loanid+timestamp (就是页面本身

    driver.get(urll)

    html = BeautifulSoup(driver.page_source,'lxml')

    info = html.find_all('table',class_="ui-table-basic-list")

    info1= info[0]

    info2 = info1.find_all('div',class_="basic-filed")

    userinfo = {}

    for item in info2:

        vartag = item.find('span')

        var = vartag.string

        if var == '信用评级':

            var = '信用评分'

            pf1 = repr(item.find('em'))

            value = re.findall(r'\d+',pf1)

        else:

            valuetag = item.find('em')

            value = valuetag.string

        userinfo[var]=value

    data = pd.DataFrame(userinfo)

    return data

rrd=pd.read_csv('loanId2.csv') #loanId是之前散标数据中的loanId,将其单独整理为一个csv文档

loanId=rrd.ix[:,'loanId']

user_info = ['昵称', '信用评分',

            '年龄', '学历', '婚姻',

            '申请借款', '信用额度', '逾期金额', '成功借款', '借款总额', '逾期次数','还清笔数', '待还本息', '严重逾期',

            '收入', '房产', '房贷', '车产', '车贷',

'公司行业', '公司规模', '岗位职位', '工作城市', '工作时间']

table = pd.DataFrame(np.array(user_info).reshape(1, 24), columns=user_info)


#帐号密码的话,你自己用手机在人人贷网上申请

username = ""

password = u""

LoginRRD(username, password)

i = 1

for loanid in loanId:

    table = pd.concat([table, parse_userinfo(loanid)])

    print(i)

    i += 1 #看一下循环多少次

table.to_csv('userinfo2.csv',header=False)
相应数据图展示: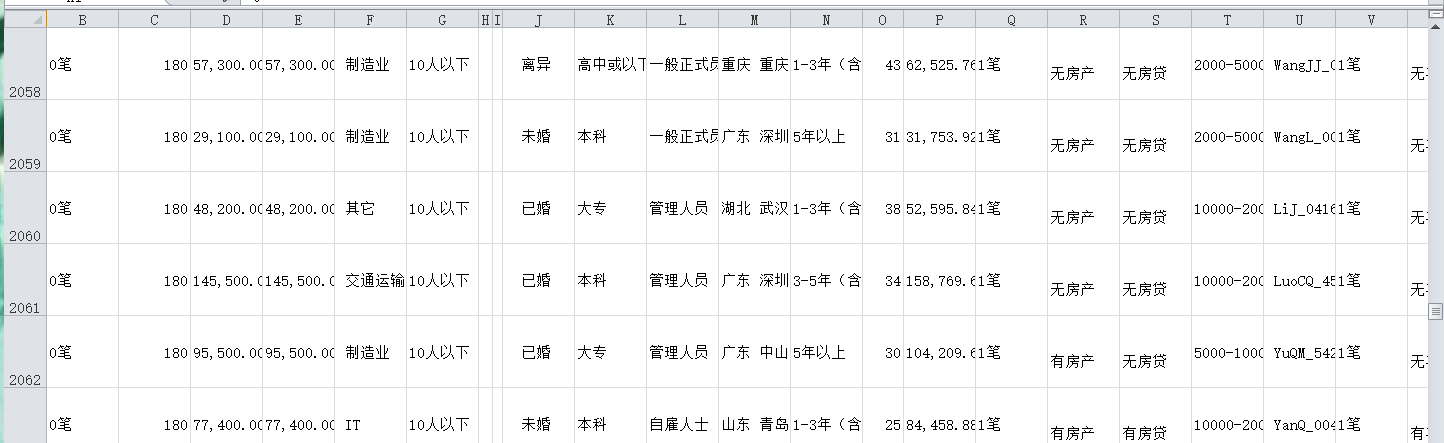
PS:
  其中'loanId2.csv'是之前博客(http://www.cnblogs.com/Yiutto/p/5890906.html)爬取整理的loanId,只有通过loanId才能爬取借贷人信息。
后来运行上述代码大概爬了3000多条就中断了(应该是同一ip访问过多的问题),如果需要大量数据的可以考虑分批爬取,多台电脑同时进行。
欢迎打赏点赞,如有需要转载,请附属作者源地址。当然运行代码遇到问题可以@我。
人人贷网的数据爬取(利用python包selenium)的更多相关文章
- 移动端数据爬取和Scrapy框架
移动端数据爬取 注:抓包工具:青花瓷 1.配置fiddler 2.移动端安装fiddler证书 3.配置手机的网络 - 给手机设置一个代理IP:port a. Fiddler设置 打开Fiddler软 ...
- 小爬爬5:重点回顾&&移动端数据爬取1
1. ()什么是selenium - 基于浏览器自动化的一个模块 ()在爬虫中为什么使用selenium及其和爬虫之间的关联 - 可以便捷的获取动态加载的数据 - 实现模拟登陆 ()列举常见的sele ...
- Web Scraper——轻量数据爬取利器
日常学习工作中,我们多多少少都会遇到一些数据爬取的需求,比如说写论文时要收集相关课题下的论文列表,运营活动时收集用户评价,竞品分析时收集友商数据. 当我们着手准备收集数据时,面对低效的复制黏贴工作,一 ...
- 芝麻HTTP:JavaScript加密逻辑分析与Python模拟执行实现数据爬取
本节来说明一下 JavaScript 加密逻辑分析并利用 Python 模拟执行 JavaScript 实现数据爬取的过程.在这里以中国空气质量在线监测分析平台为例来进行分析,主要分析其加密逻辑及破解 ...
- Python爬虫 股票数据爬取
前一篇提到了与股票数据相关的可能几种数据情况,本篇接着上篇,介绍一下多个网页的数据爬取.目标抓取平安银行(000001)从1989年~2017年的全部财务数据. 数据源分析 地址分析 http://m ...
- Ajax数据爬取
Ajax的基本原理 以菜鸟教程的代码为例: XMLHTTPRequest对象是JS对Ajax的底层实现: var xmlhttp; if (window.XMLHttpRequest) { // IE ...
- Python爬虫入门教程 11-100 行行网电子书多线程爬取
行行网电子书多线程爬取-写在前面 最近想找几本电子书看看,就翻啊翻,然后呢,找到了一个 叫做 周读的网站 ,网站特别好,简单清爽,书籍很多,而且打开都是百度网盘可以直接下载,更新速度也还可以,于是乎, ...
- 基于 PHP 的数据爬取(QueryList)
基于PHP的数据爬取 官方网站站点 简单. 灵活.强大的PHP采集工具,让采集更简单一点. 简介: QueryList使用jQuery选择器来做采集,让你告别复杂的正则表达式:QueryList具有j ...
- Scrapy 框架 CrawlSpider 全站数据爬取
CrawlSpider 全站数据爬取 创建 crawlSpider 爬虫文件 scrapy genspider -t crawl chouti www.xxx.com import scrapy fr ...
随机推荐
- console.log() 替代函数
var log = console.log.bind(console); log('d')
- Redux和React-Redux的实现(三):中间件的原理和applyMiddleware、Thunk的实现
现在我们的Redux和React-Redux已经基本实现了,在Redux中,触发一个action,reducer立即就能算出相应的state,如果我要过一会才让reducer计算state呢怎么办?也 ...
- 20180711-统计PDB中的蛋白质种类、膜蛋白文件个数及信息等
20180710完成这份工作.简单,但是完成了还是很开心.在我尝试如何使用pickle保存数据后,尝试保存PDB文件中“HEADER”中的信息.文件均保存于实验室服务器(97.73.198.168)/ ...
- 电梯调度系统(界面由C图形库编绘)
电梯调度系统编程 1.编程题目 电梯调度. 2.结对编程组员 黄冠译,刘畅. 3.编程语言 C语言图形库. 4.题目要求: 5.代码运行及结果调试: ① 运行界面为C++图形库支持,开始运行的初始界面 ...
- ASP.NET MVC 4.0 参考源码索引
http://www.projky.com/asp.netmvc/4.0/Microsoft/AspNet/Mvc/Facebook/FacebookAppSettingKeys.cs.htmlhtt ...
- Sprint1回顾
Sprint目标 此产品为适用于小学生使用的四则运算训练软件.关于第一期Sprint冲刺的目标,我们打算实现产品的以下几点的功能: •1.初始界面设计 •2.四则基本运算算法 •3.能产生随机式子 • ...
- IT行业的个人见解
IT这个行业是近代历史上的新新行业,它的就业前景是非常的好的,就业率高,但是这个行业的需求人才精英不是那些半桶水的所谓IT男.我现在学习的是计算机专业中的软件工程目标是成为一名合格的软件工程师,软件工 ...
- fx投影效果分离
虽然忙着花花二期三期bug.bug ing,修改等待中突然看见一张logo.文字下面的阴影图,如下,就满脑子在想阴影到底咋做的.. 七拼八凑的尝试后大体样子是有,终究没有上图那种字体轮廓的阴影... ...
- 学习mysql触发器遇到的问题
在 mysql.exe 下面运行的.如果是的话, 可能是需要加一个 定义 DELIMITER // 意思是告诉 mysql , 遇到 // 符号以后, 才认为语句结束了. 否则 mysql 遇到 分号 ...
- Tween.js 动画效果
一.apply,和call的用法. 先来一个与本次博文无关的东西,就是apply和call的用法.其实apply和call的用法都一样,只是他们的传参不一样.apply是数组,而call是单独的传,类 ...