
Hadoop基础-HDFS数据清理过程之校验过程代码分析
Hadoop基础-HDFS数据清理过程之校验过程代码分析
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
想称为一名高级大数据开发工程师,不但需要了解hadoop内部的运行机制,还需要掌握hadoop在写入过程中的报文分析。当然代码的调试步骤是一个开发必须得会的技能!想要掌握这三个技能,我们就可以拿HDFS写入过程来练练手,了解一下平时就几行的代码在它的内部是如何帮我们实现数据传输的。
一.Idea代码调试简介
1>.编写测试代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E8%BF%9B%E9%98%B6%E4%B9%8B%E8%B7%AF/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hdfs;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.FSDataOutputStream;

 import org.apache.hadoop.fs.FileSystem;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.io.IOUtils;

 import java.io.FileInputStream;

 import java.io.IOException;

 public class WriterToHdfs {

     public static void main(String[] args) throws IOException {

         //设置访问hdfs的用户名为“yinzhengjie”

         System.setProperty("HADOOP_USER_NAME","yinzhengjie");

         Configuration conf = new Configuration();

         FileSystem fs = FileSystem.get(conf);

         //定义需要在hdfs中写入的路径,别忘记把core-site.xml文件放在resources目录下哟!并fs.defaultFS的值设置为"hdfs://s101:8020"

         Path p = new Path("/yinzhengjie.sql");

         //通过fs对象create方法创建一个输出流,第一个参数是hdfs路径,第二个参数表示当hdfs中存在时是否覆盖

         FSDataOutputStream fos = fs.create(p,true);

         FileInputStream fis = new FileInputStream("D:\\10.Java\\IDE\\yhinzhengjieData\\MyHadoop\\yinzhengjie.sql");

         //通过hadoop提供的IOUtils工具类对拷数据

         IOUtils.copyBytes(fis,fos,1024);

         fis.close();

         fos.close();

     }

 }
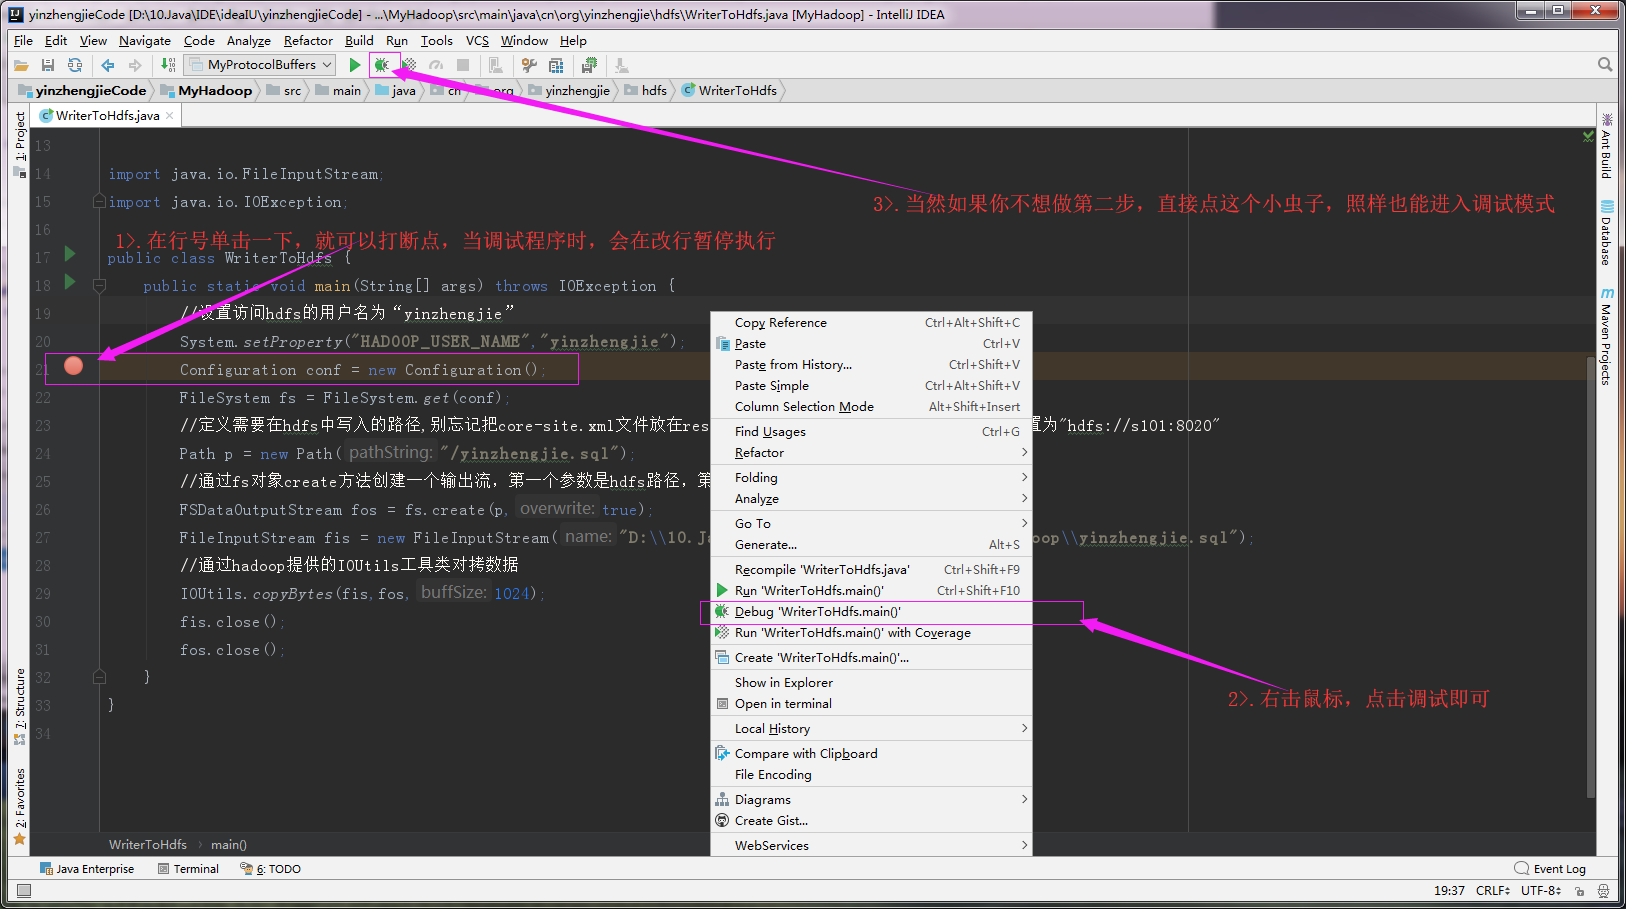
2>.进入调试模式
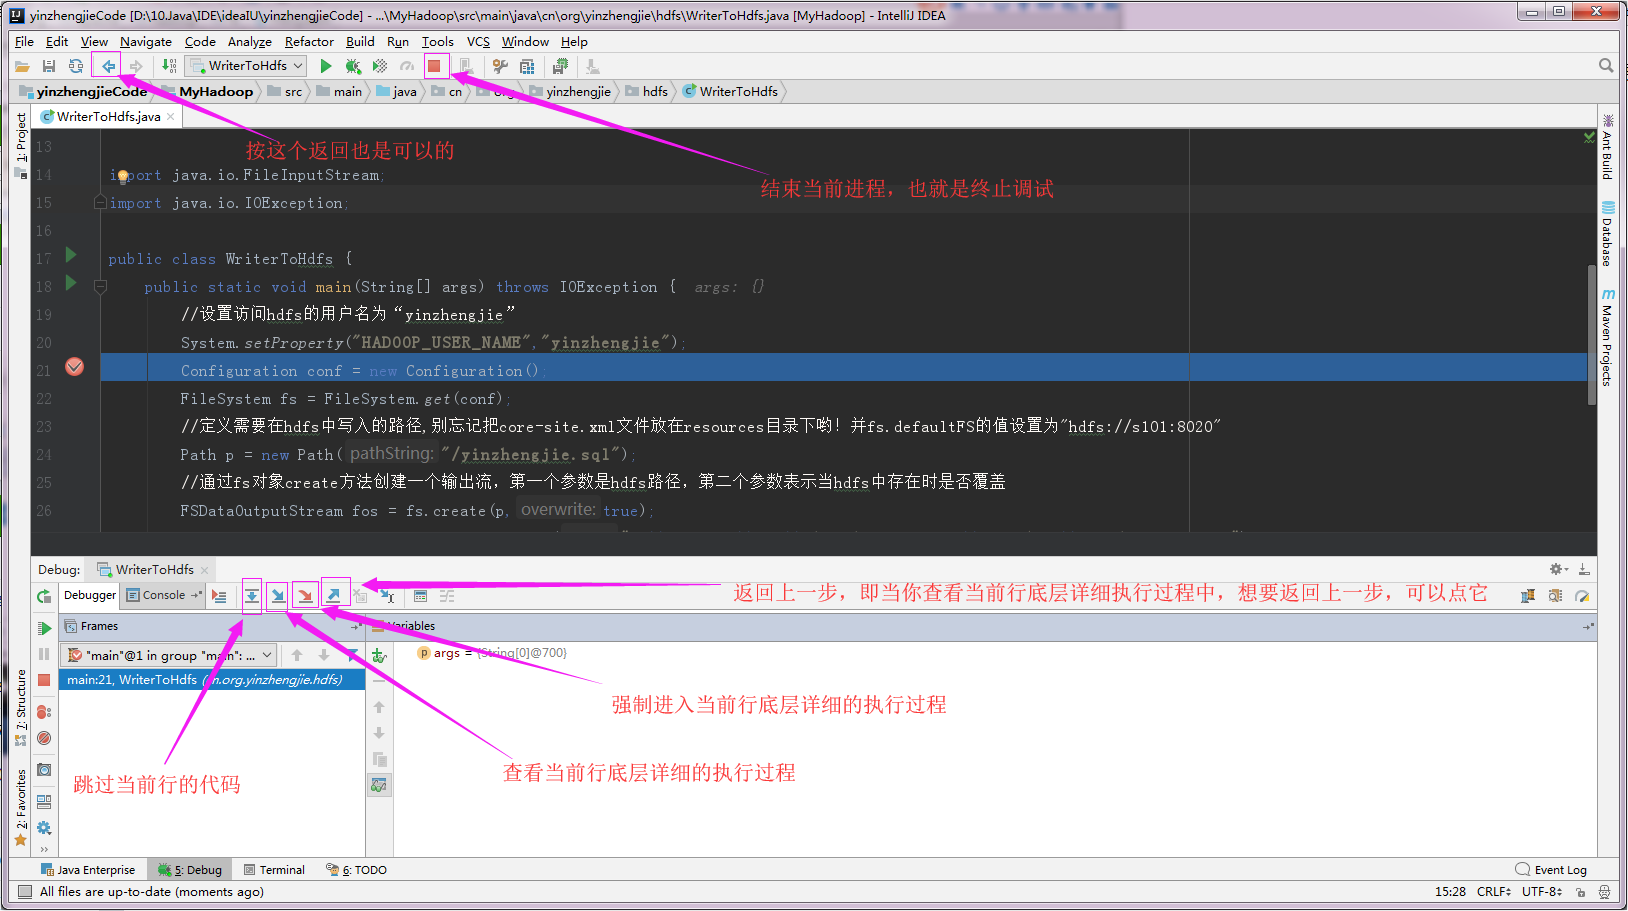
3>.查看源码执行过程,流程控制按键介绍:
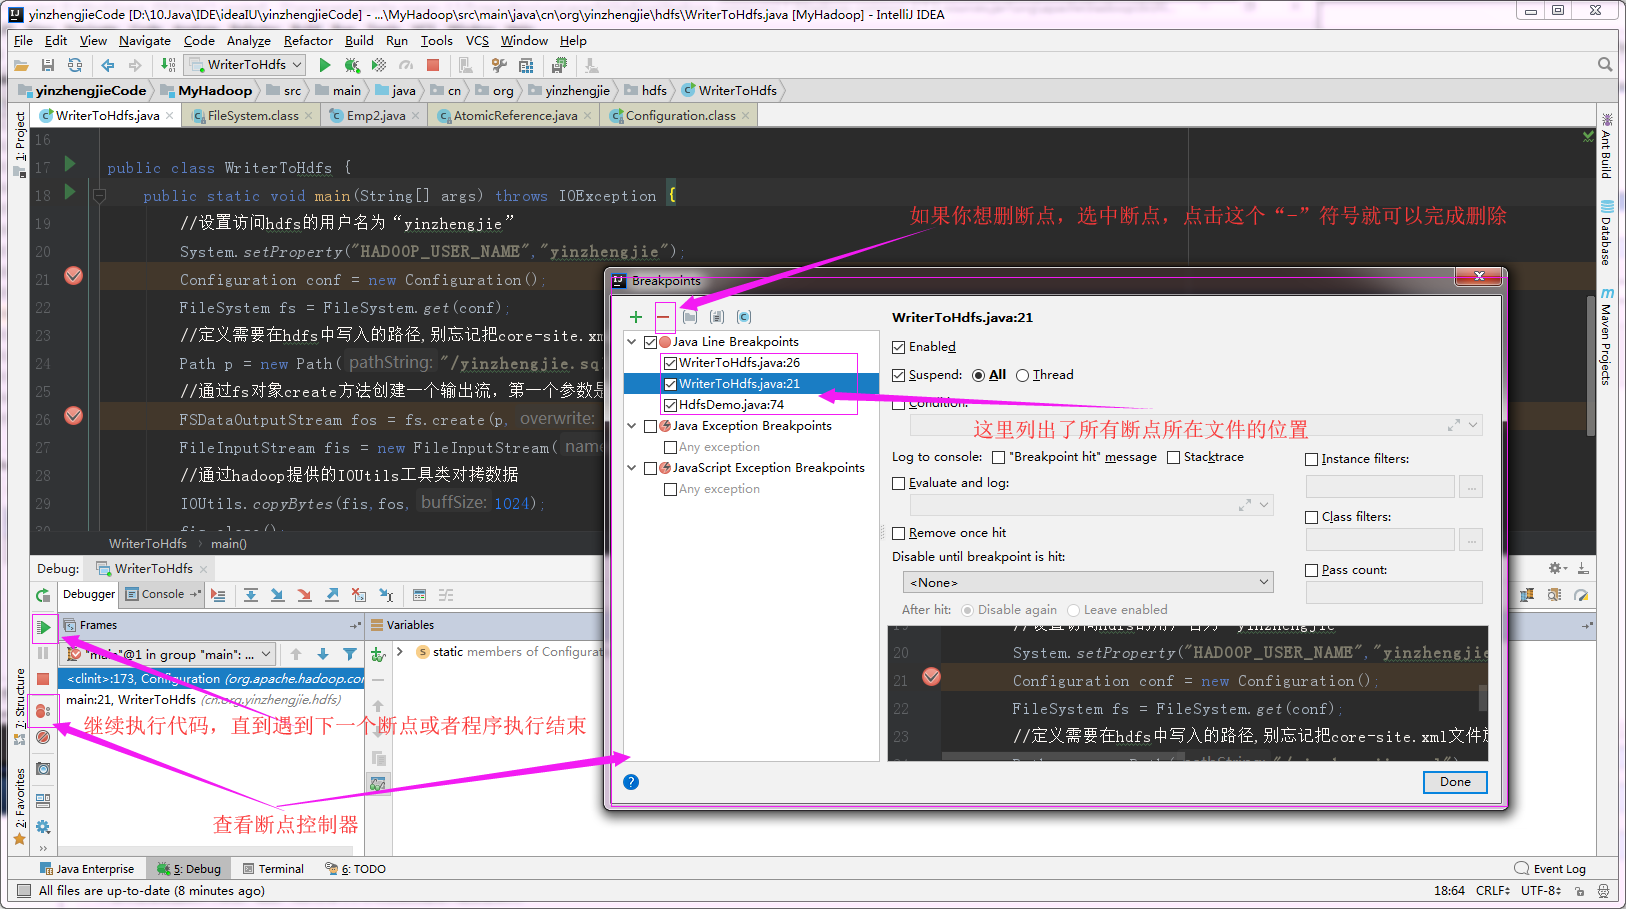
4>.断点列表管理
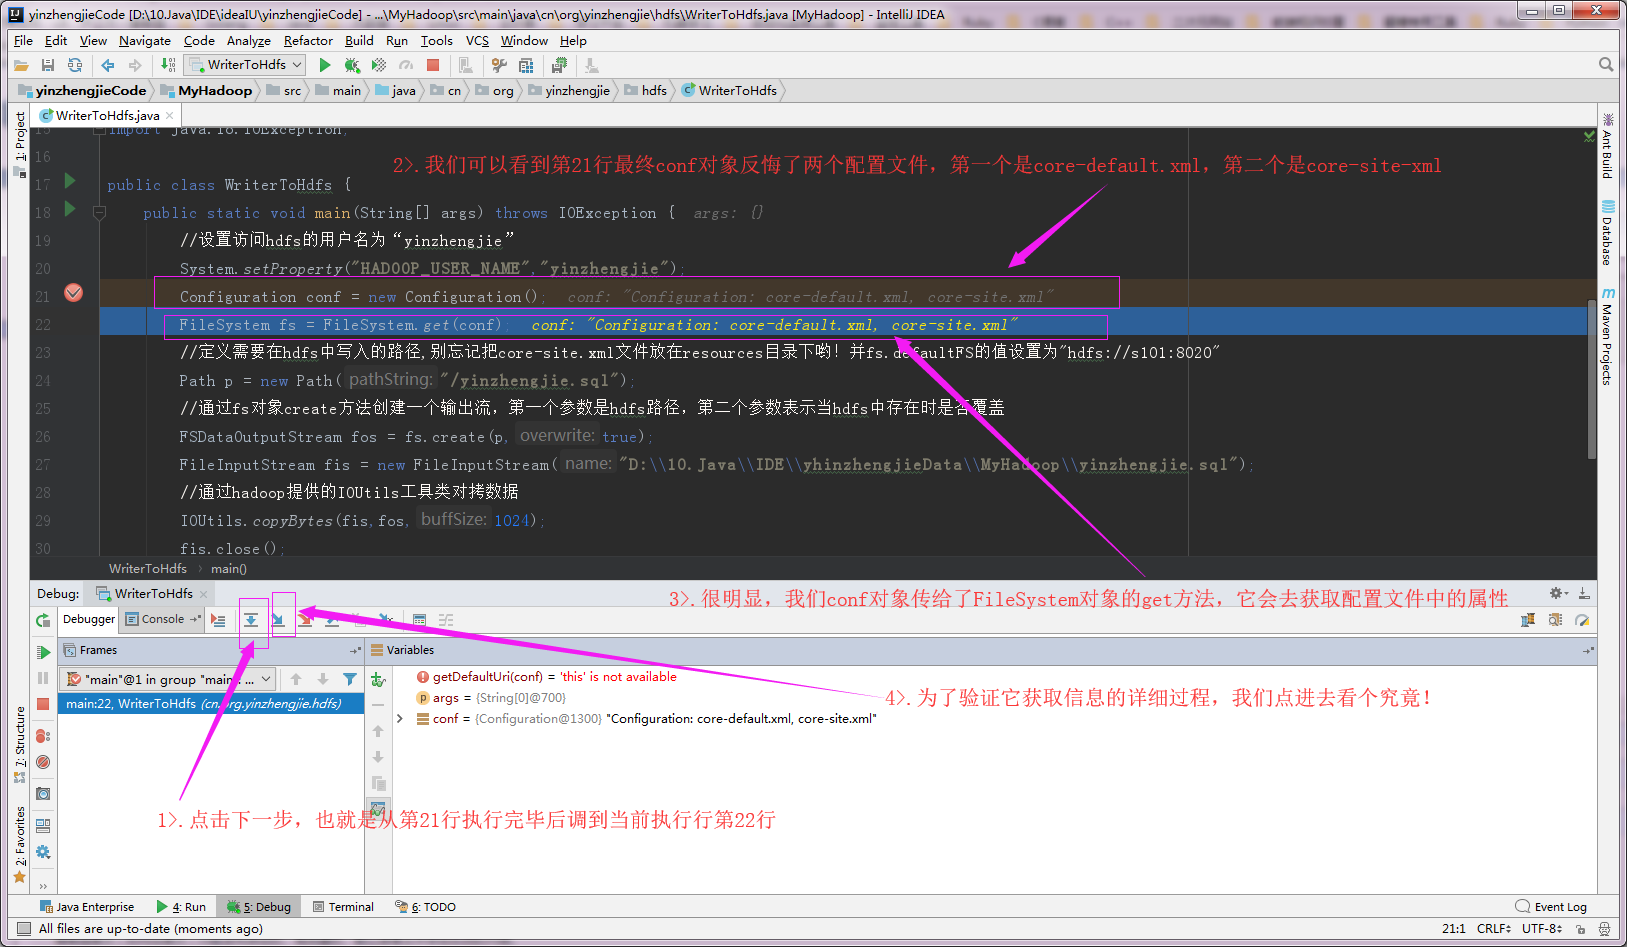
二.查看 “FileSystem fs = FileSystem.get(conf)” 的由来
1>.查看conf的返回值
2>.进入“FileSystem.get”方法(我们需要在return那一行右击就可以弹出图中的对话框,其实不用刻意去选中getDefaultUri)
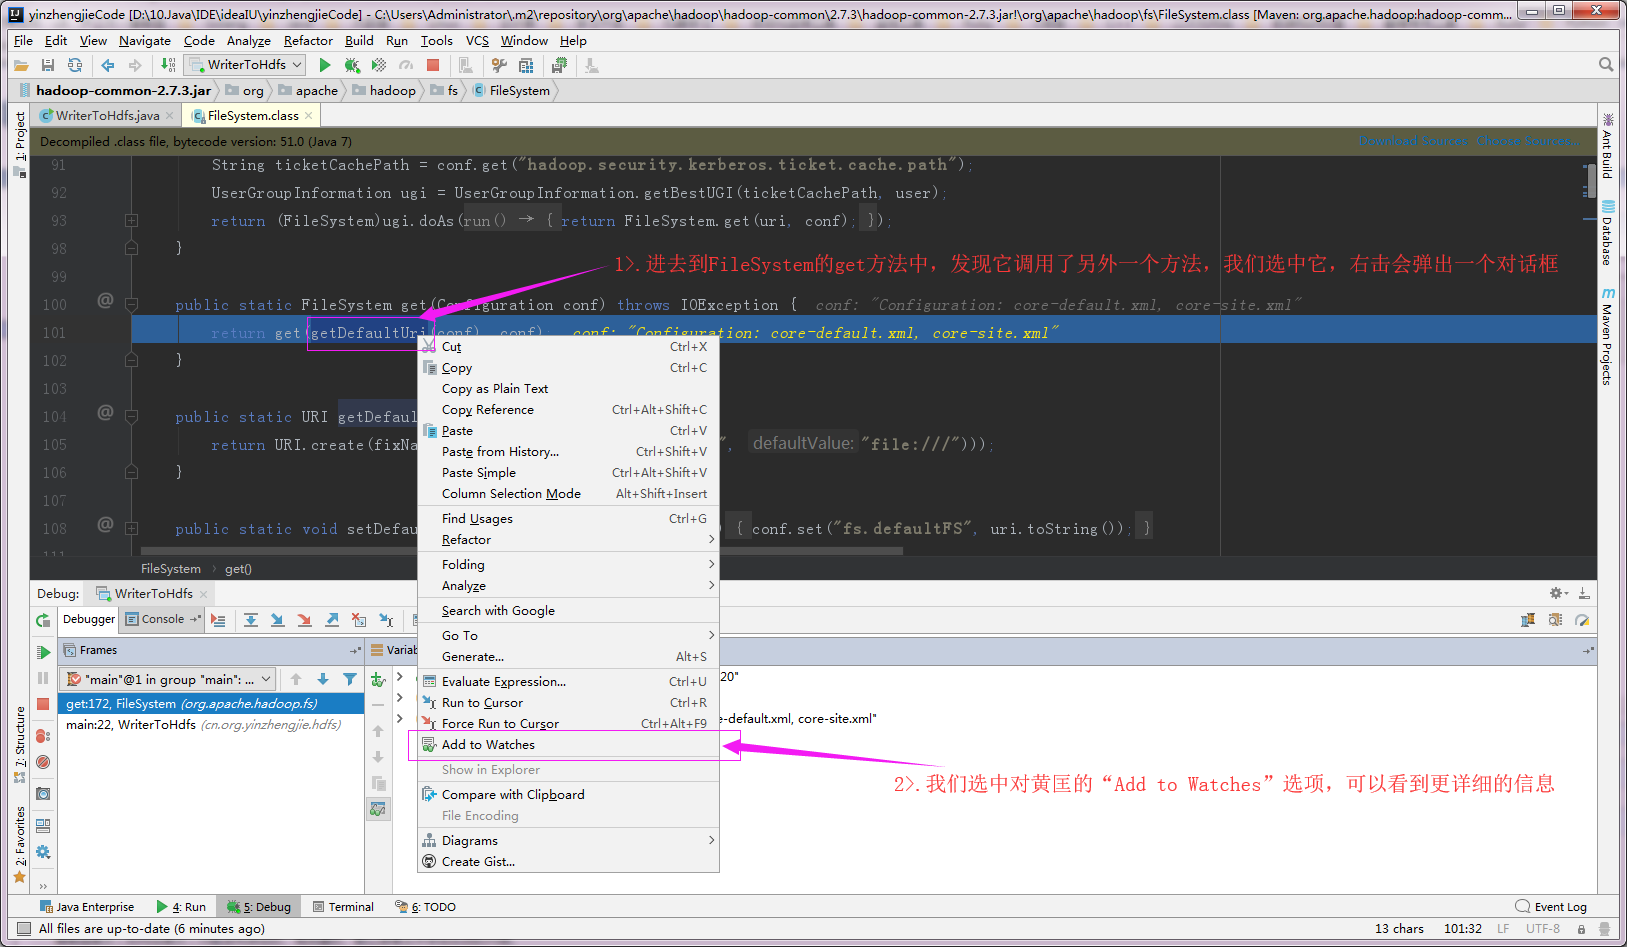
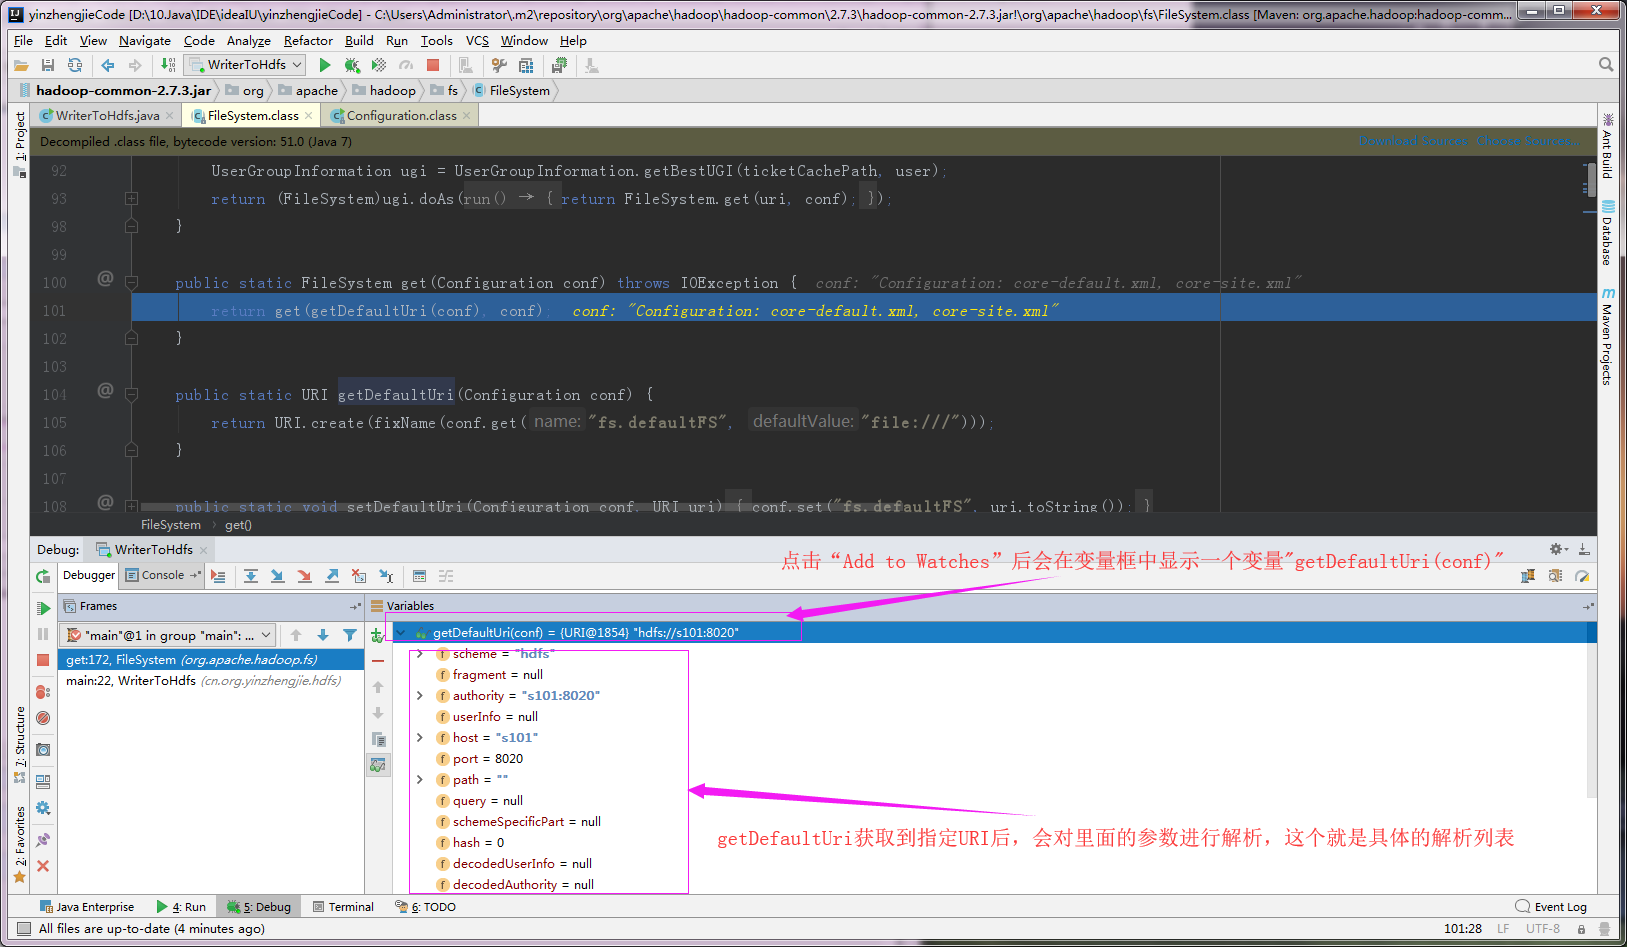
3>.查看“getDefaultUri(conf)”返回的参数
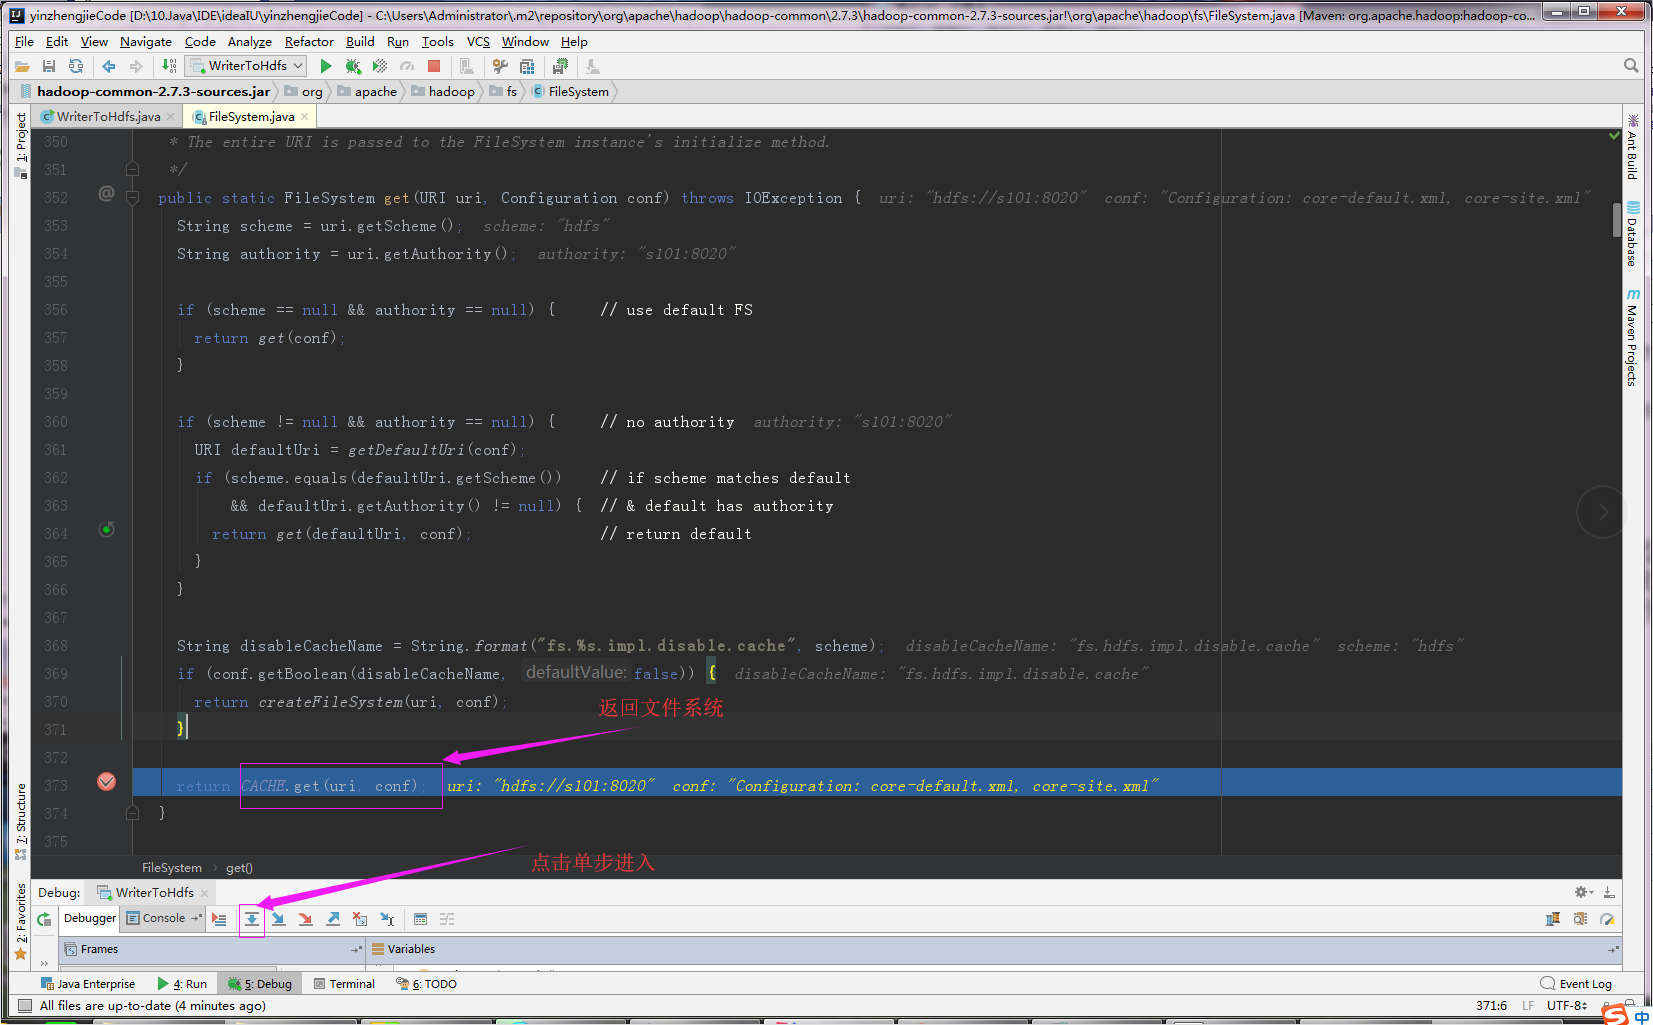
4>.通过“CACHE.get(uri, conf)”返回文件系统
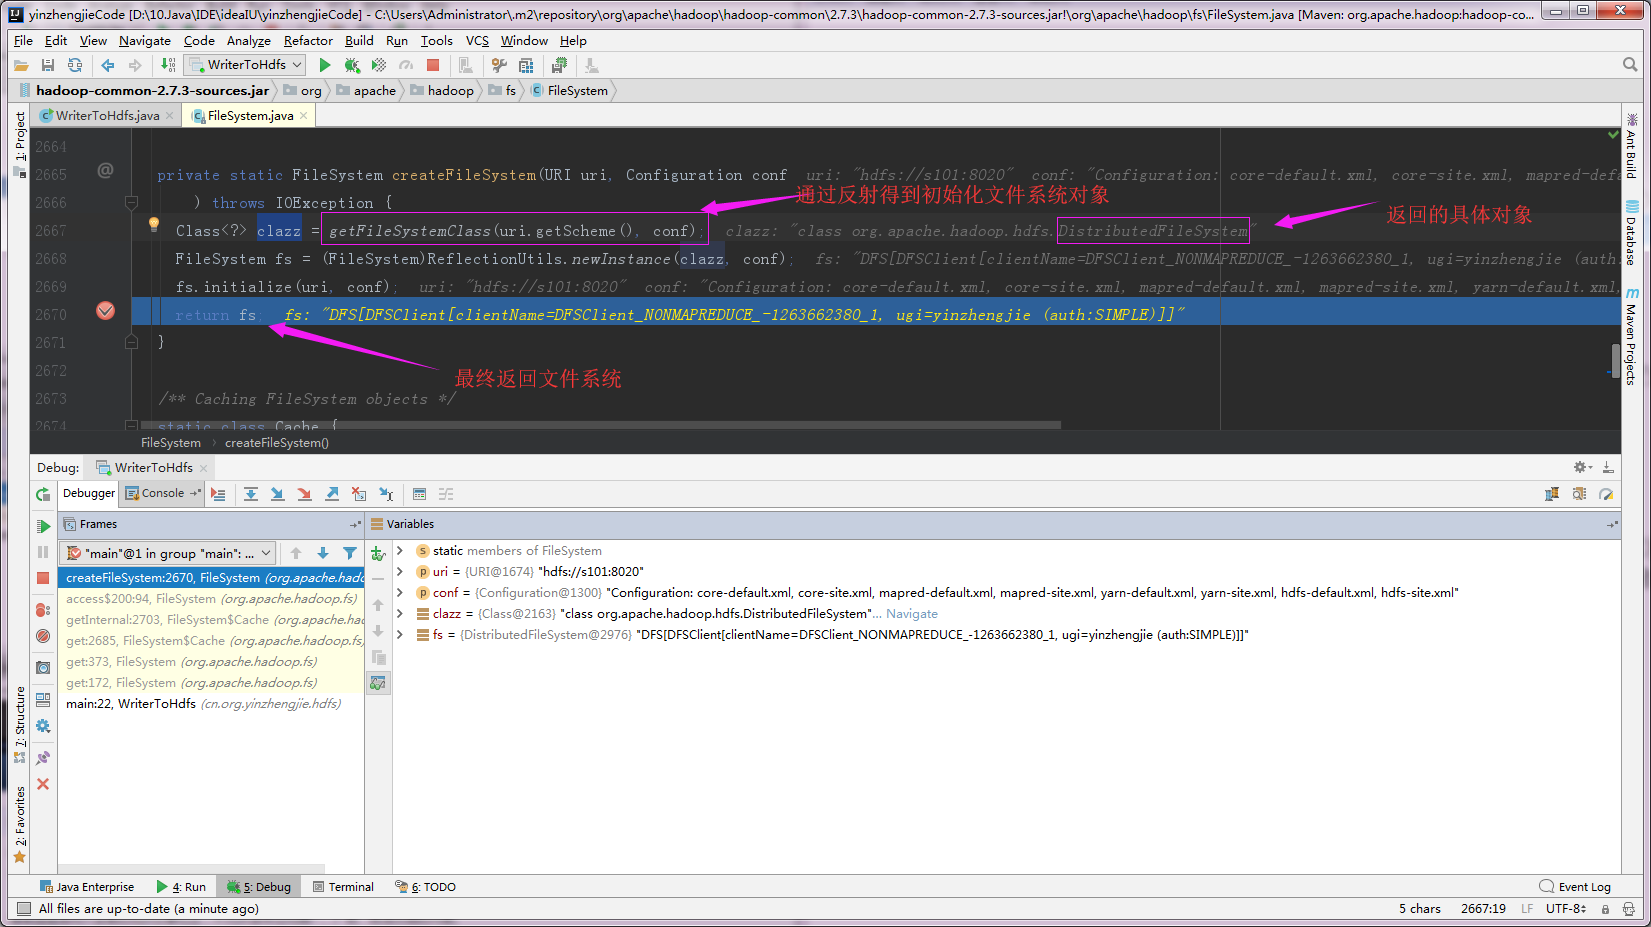
5>.返回文件系统
三.查看“fs.create(p, true)”创建流的详细过程
1>.单步进入“fs.create(p, true)”创建流
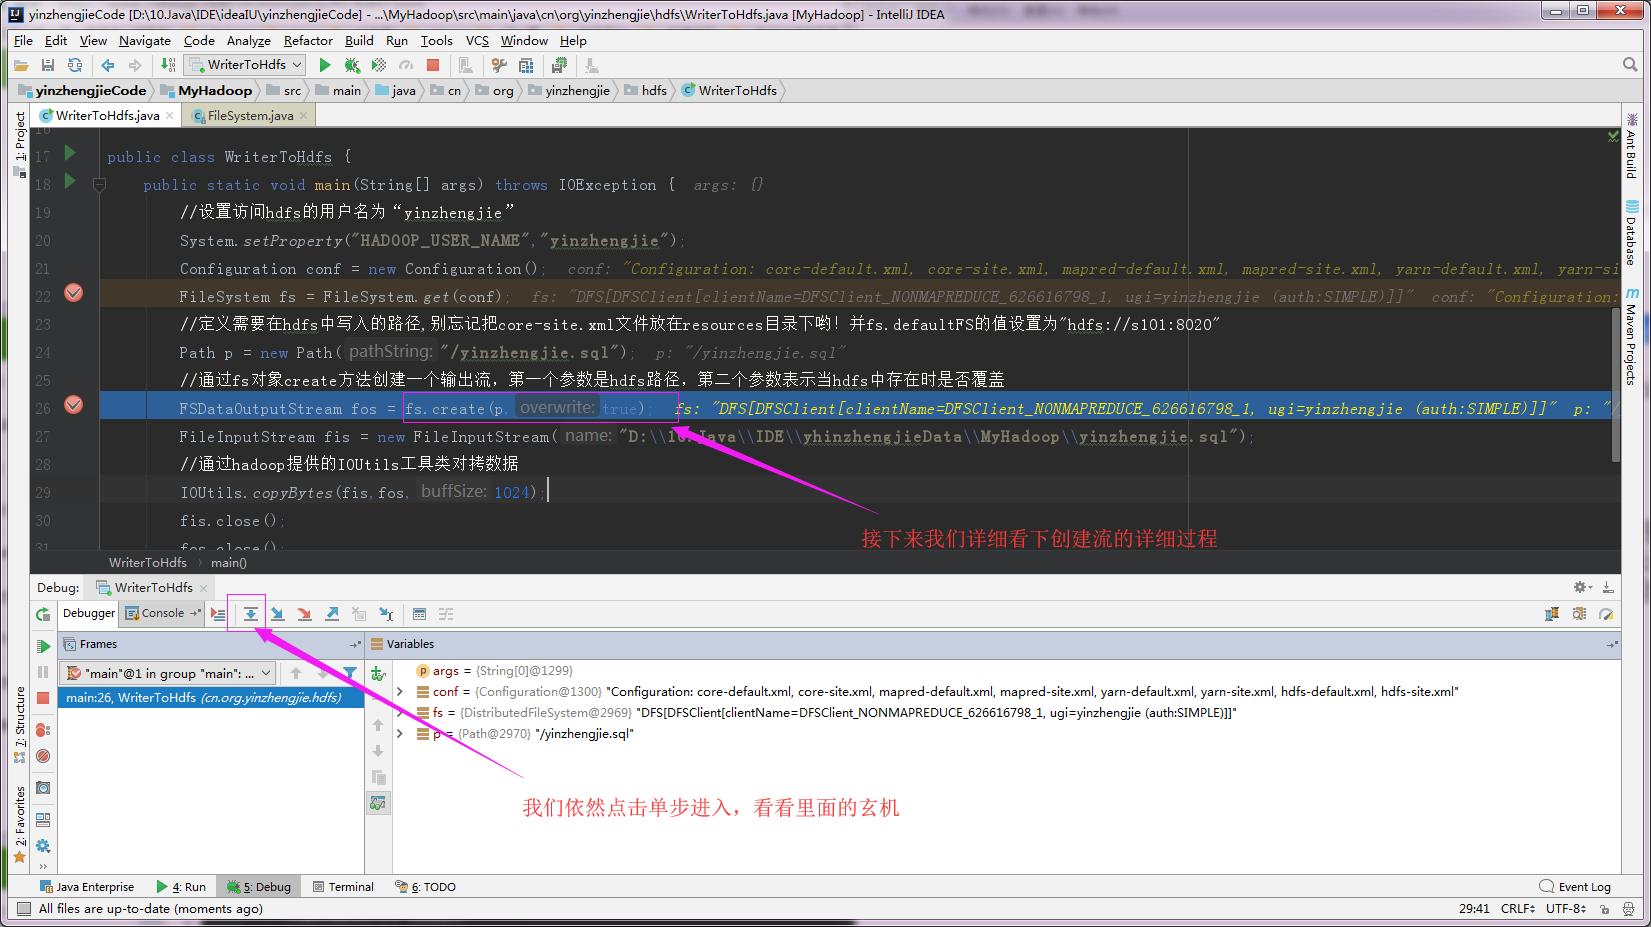
2>.经过断电跟踪,发现最后返回的是HDFSOutputStream,也就是创建流,此时还没有真正的写入数据
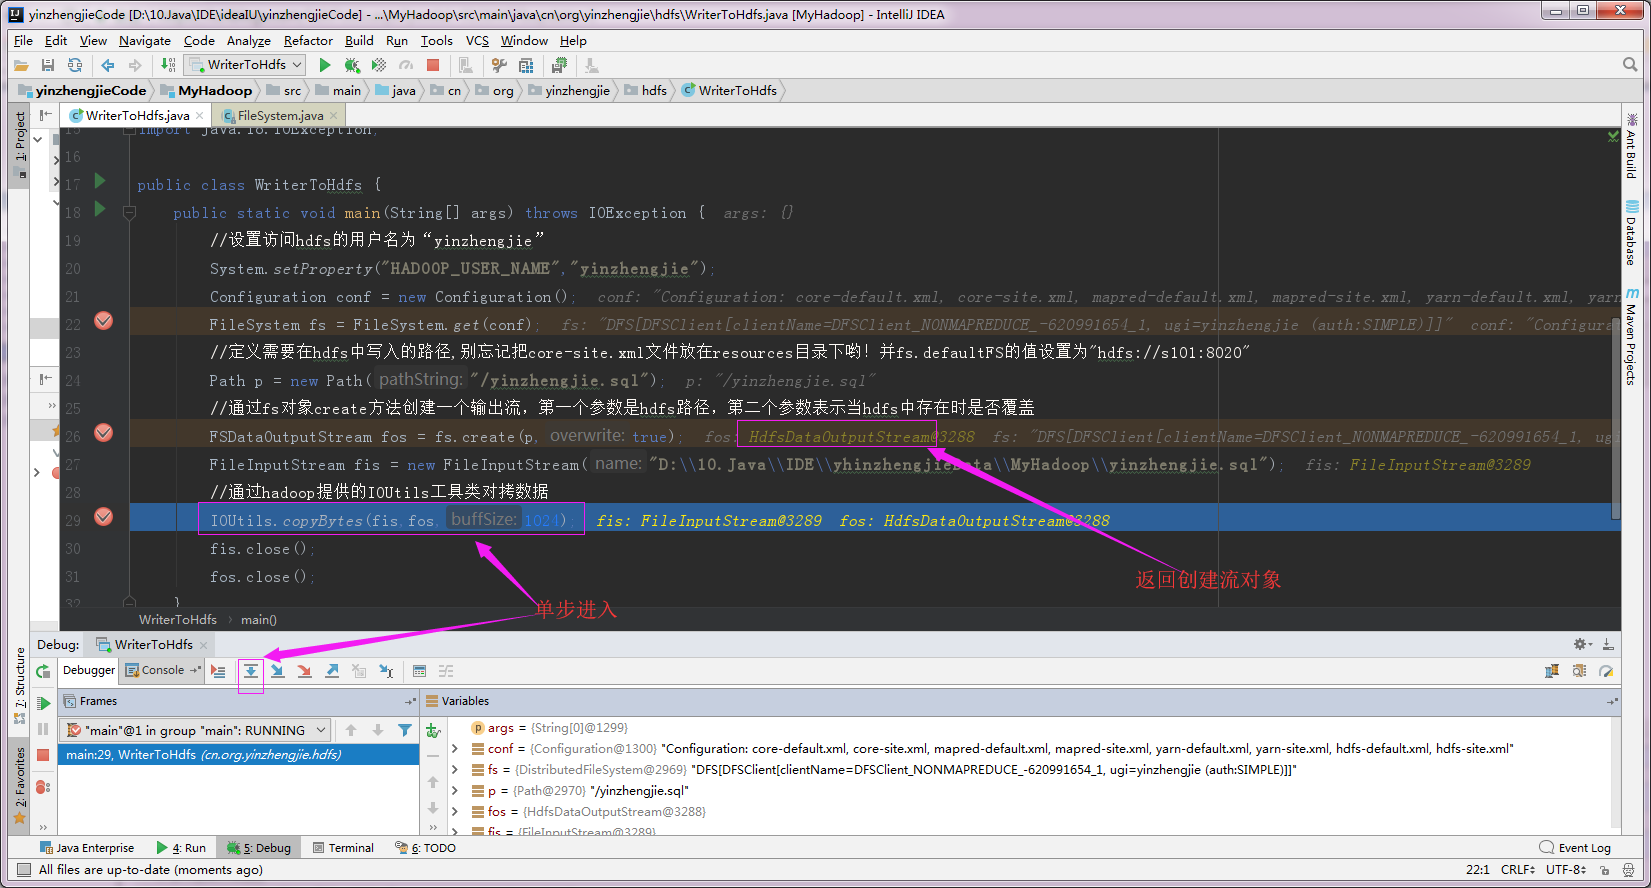
3>.在写入过程中进入到write1方法
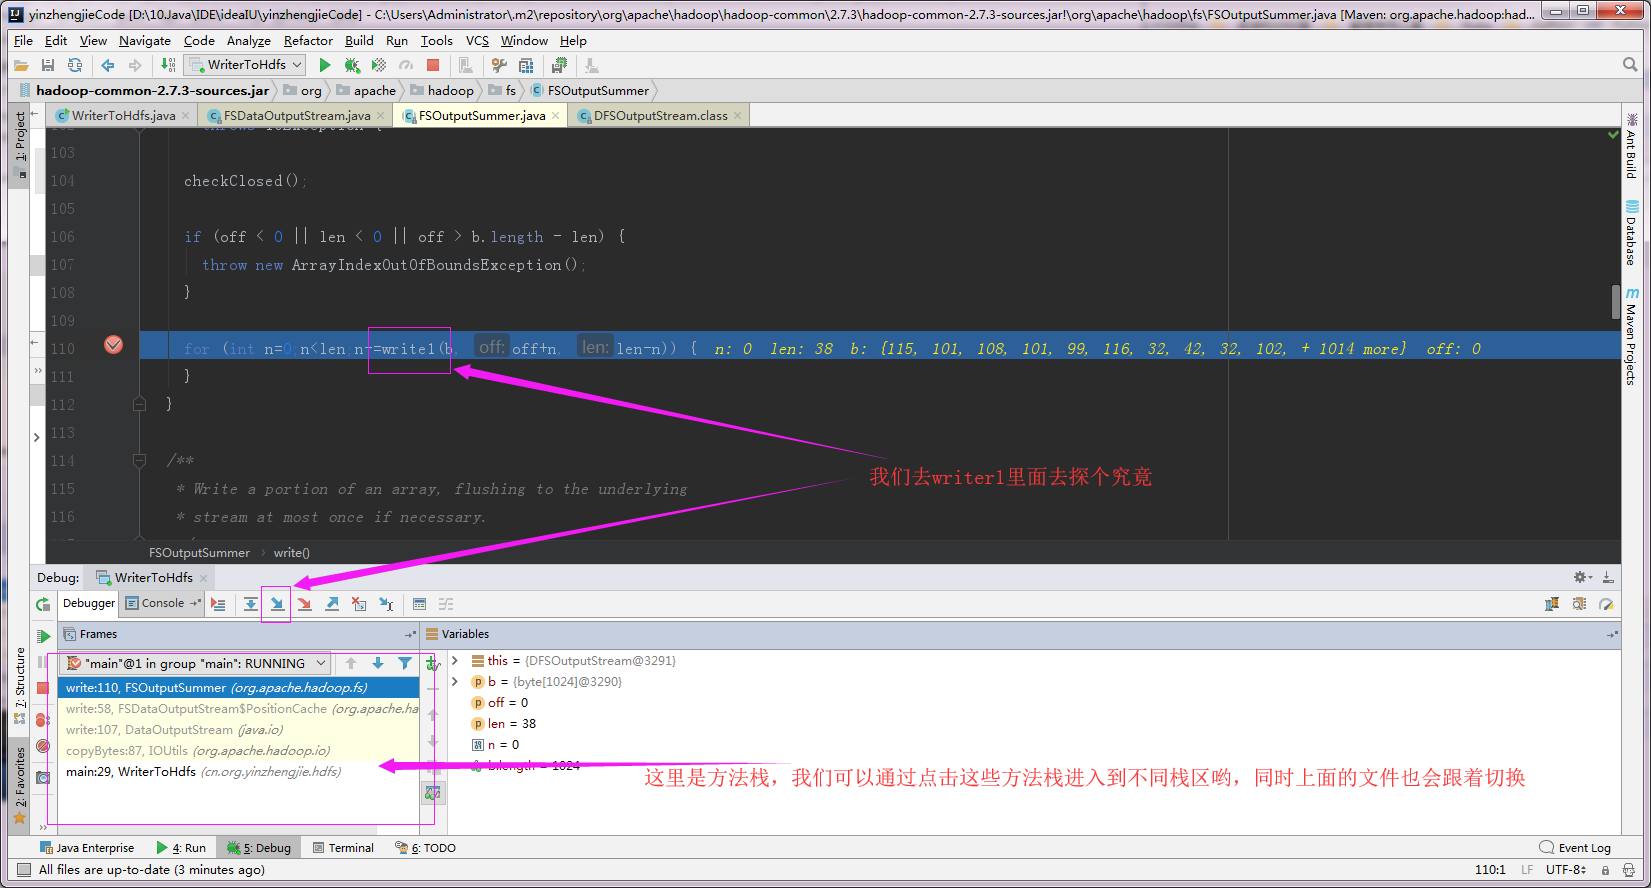
4>.再进入到FlushBuffer,目的是清理chunk
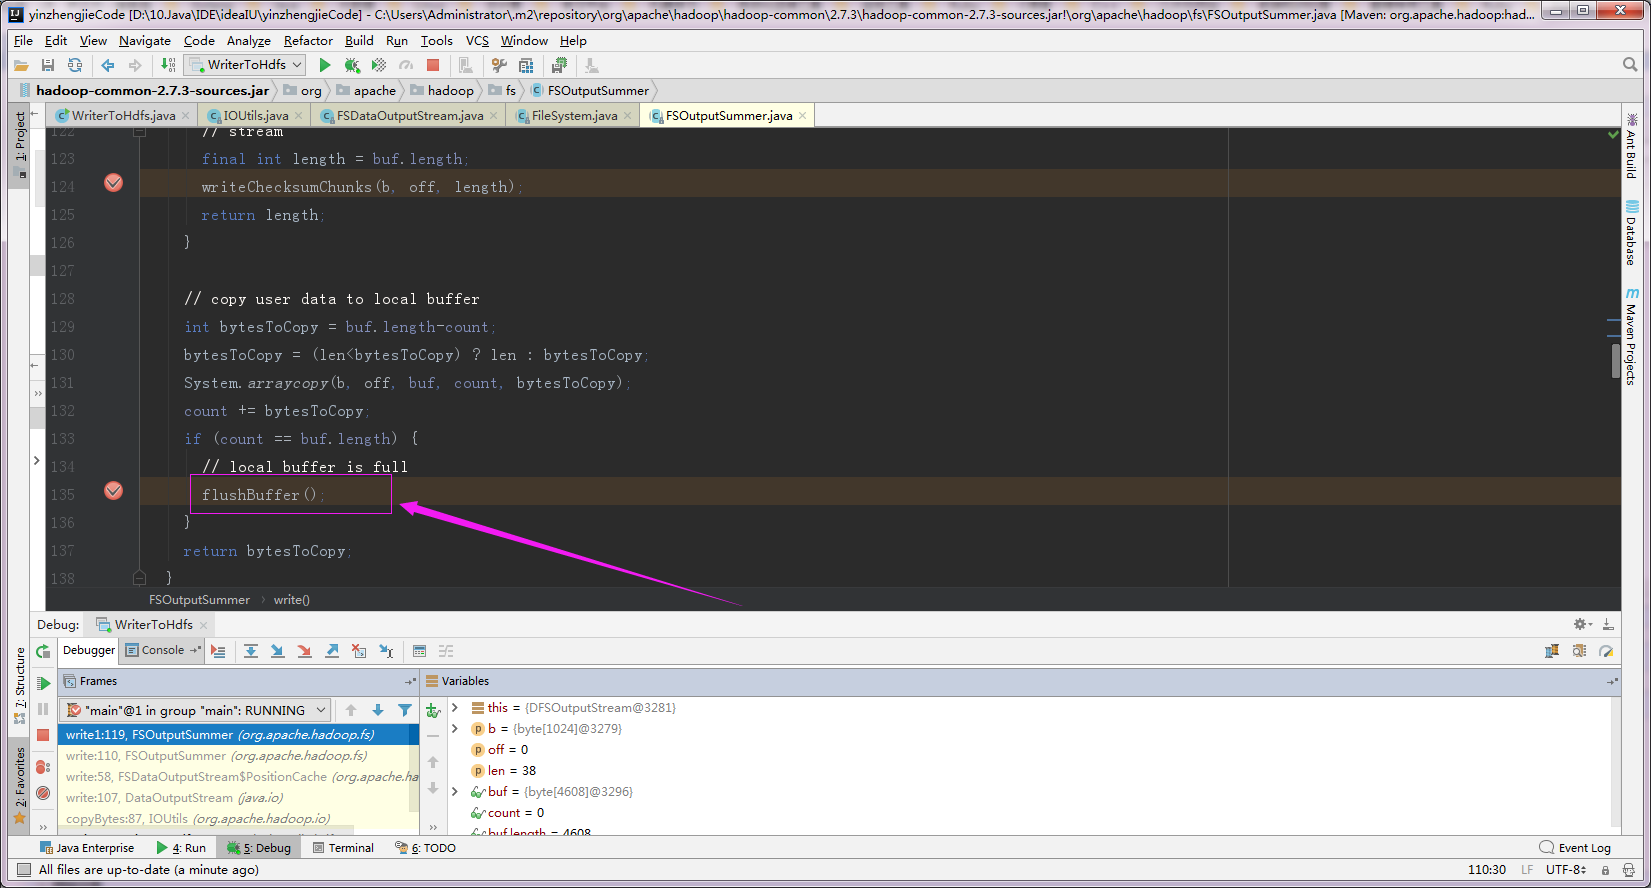
5>.验证chunk大小为512字节
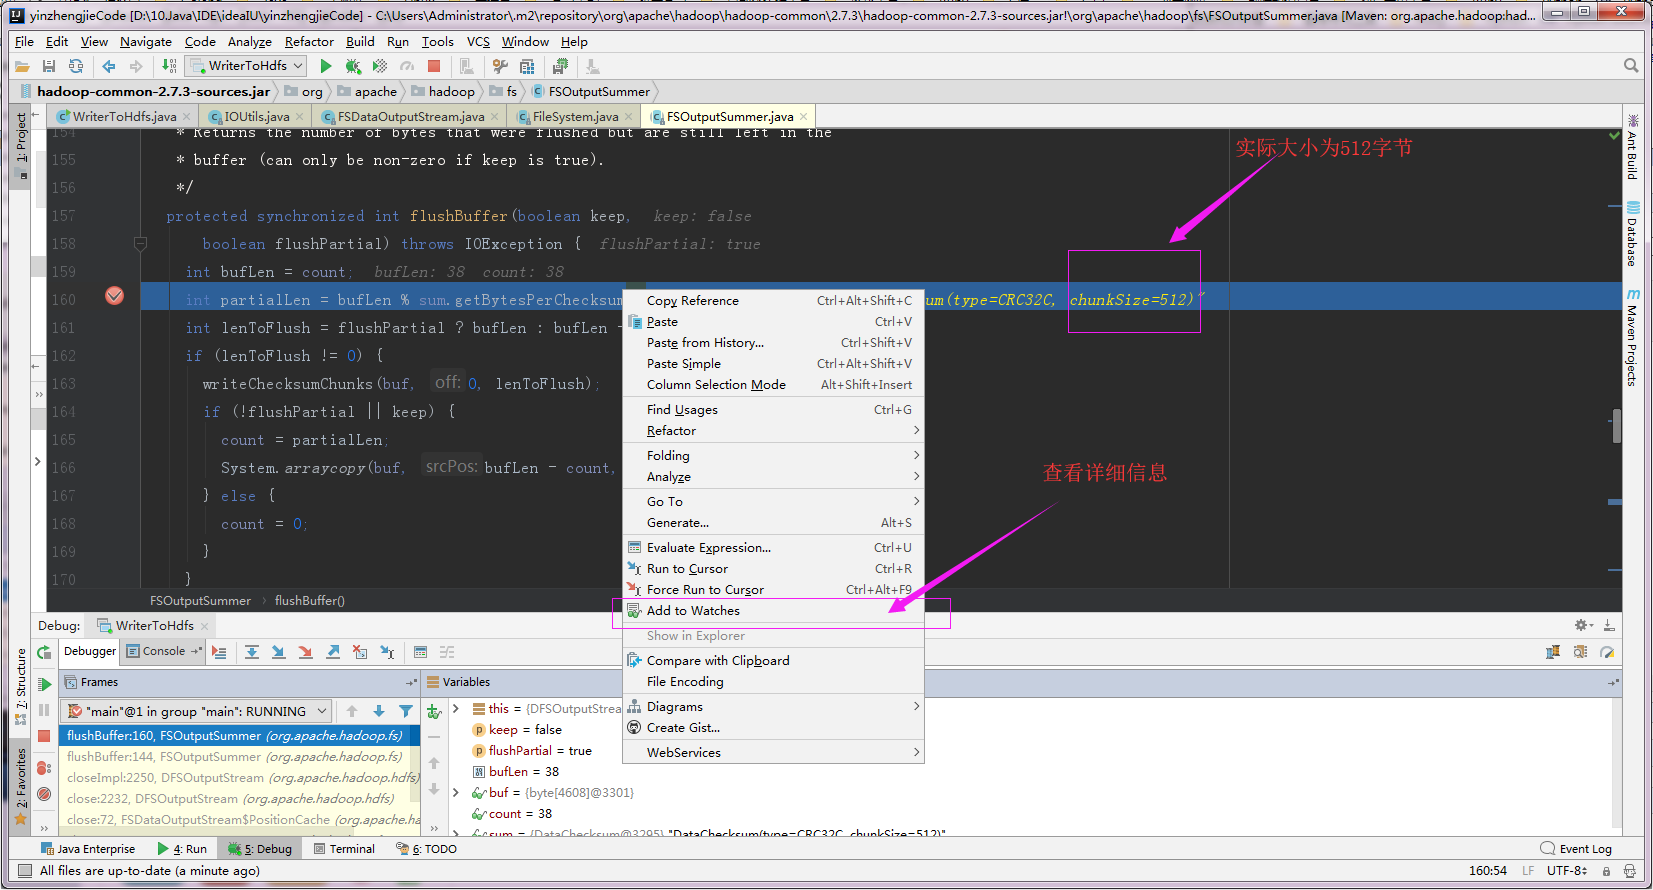
6>.我们通过打断点的方式查出来chunk的大小为512字节,这个大小意思的是每个512字节就会进行一次校验。
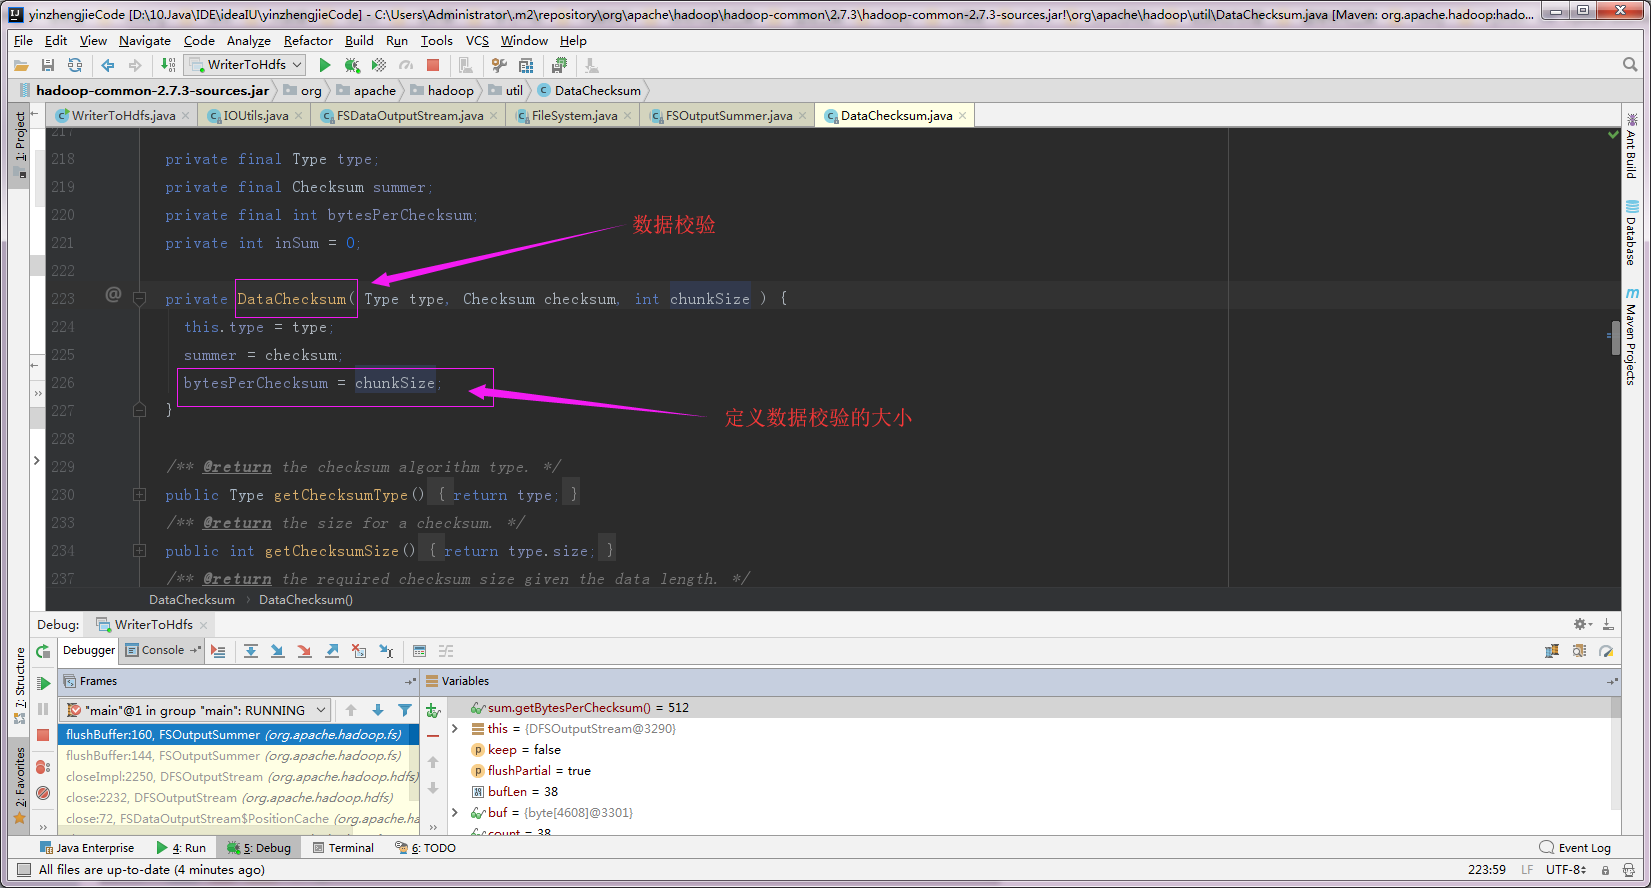
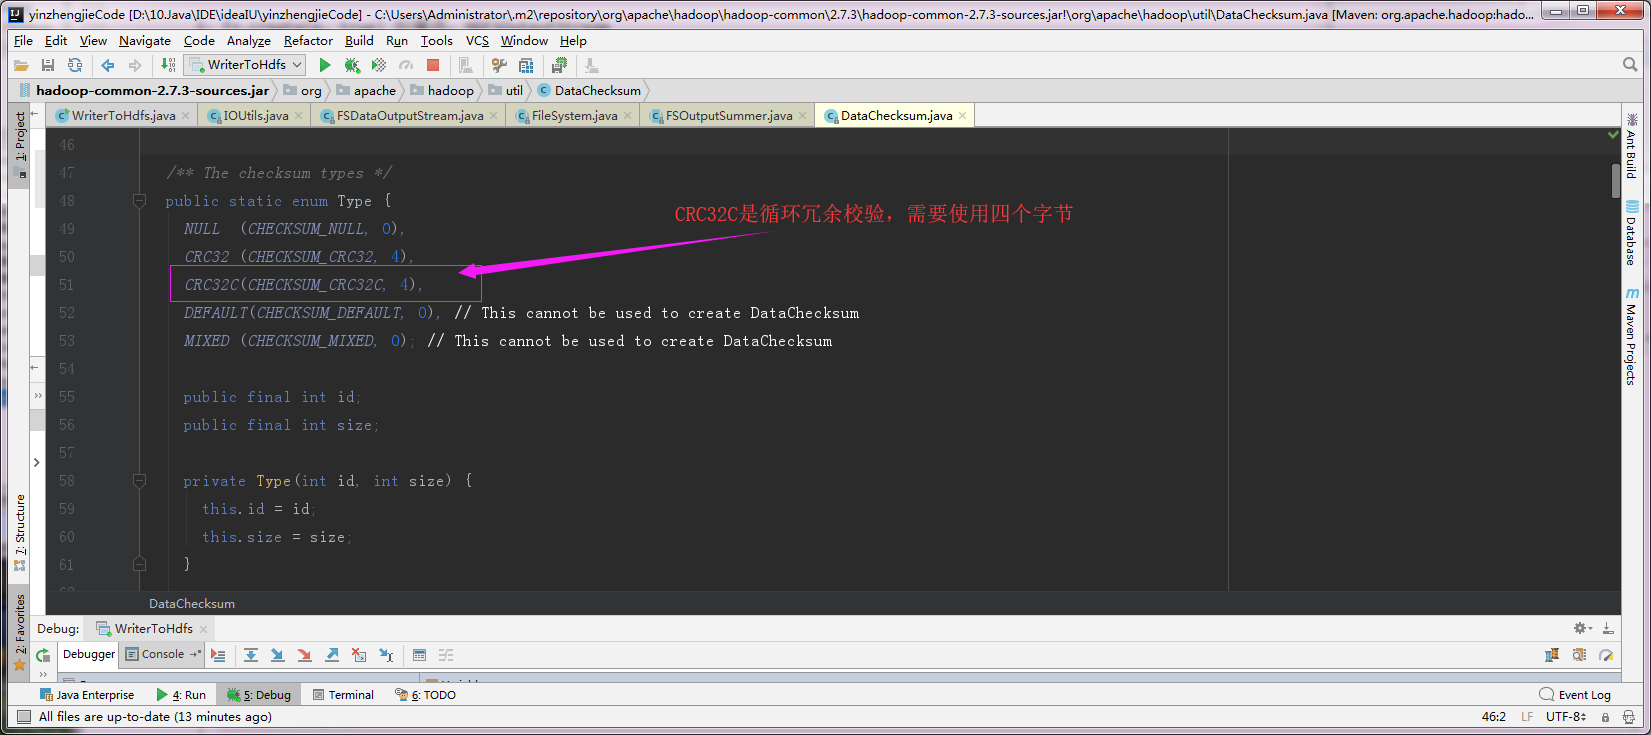
7>.使用“sum.calculateChunkedSums”来计算校验和,使用循环冗余校验(CRC32C),大小4个字节
四.知识点小结
1>.chunk数据块
第一:通过断点调试估计大家也知道chunk的做作用了,它就是数据块,512字节,在上面调试代码中看到的"sum.getBytesChecksum()"的大小就是512,它的意思就是每个512字节进行依次校验;
第二:上图调试中的"sum.caculateChunkedSums"是来计算校验和的,使用 循环冗余校验(CRC32C),占用4个字节;
2>.data数据
数据包括两个方面,估计你也猜到了,没错,就是真实数据和校验数据。校验数据大小 = 7字节头 + 检验和个数(每512字节进行依次校验) x 4
不管你信不信,反转我是信了,我们举个例子,如下:
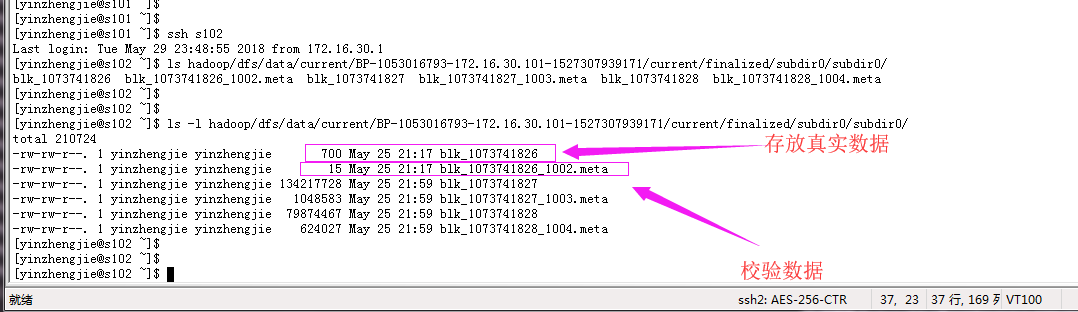
比如上面的“blk_1073741826”大小是700字节,将其除以512字节,商为2(如果有余数的话商要加1)。那么校验大小就应该是"7 + 4 x 2 = 15",即校验和为15字节,
Hadoop基础-HDFS数据清理过程之校验过程代码分析的更多相关文章
- Hadoop基础-HDFS集群中大数据开发常用的命令总结
Hadoop基础-HDFS集群中大数据开发常用的命令总结 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本盘博客仅仅列出了我们在实际生成环境中常用的hdfs命令,如果想要了解更多, ...
- Hadoop基础-Hdfs各个组件的运行原理介绍
Hadoop基础-Hdfs各个组件的运行原理介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.NameNode工作原理(默认端口号:50070) 1>.什么是NameN ...
- Hadoop基础-HDFS的读取与写入过程剖析
Hadoop基础-HDFS的读取与写入过程剖析 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客会简要介绍hadoop的写入过程,并不会设计到源码,我会用图和文字来描述hdf ...
- Hadoop基础-HDFS的读取与写入过程
Hadoop基础-HDFS的读取与写入过程 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 为了了解客户端及与之交互的HDFS,NameNode和DataNode之间的数据流是什么样 ...
- Hadoop基础-HDFS的API实现增删改查
Hadoop基础-HDFS的API实现增删改查 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客开发IDE使用的是Idea,如果没有安装Idea软件的可以去下载安装,如何安装 ...
- Hadoop基础-HDFS的API常见操作
Hadoop基础-HDFS的API常见操作 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本文主要是记录一写我在学习HDFS时的一些琐碎的学习笔记, 方便自己以后查看.在调用API ...
- Hadoop基础-HDFS安全管家之Kerberos实战篇
Hadoop基础-HDFS安全管家之Kerberos实战篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 我们都知道hadoop有很多不同的发行版,比如:Apache Hadoop ...
- Hadoop基础-HDFS分布式文件系统的存储
Hadoop基础-HDFS分布式文件系统的存储 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HDFS数据块 1>.磁盘中的数据块 每个磁盘都有默认的数据块大小,这个磁盘 ...
- Hadoop基础-HDFS递归列出文件系统-FileStatus与listFiles两种方法
Hadoop基础-HDFS递归列出文件系统-FileStatus与listFiles两种方法 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. fs.listFiles方法,返回Loc ...
随机推荐
- Task 4.3 求环形数组的最大子数组和
任务要求:输入一个整形数组,数组里有正数也有负数. 数组中连续的一个或多个整数组成一个子数组,每个子数组都有一个和. 如果数组A[0]……A[j-1]首尾相邻,允许A[i-1], …… A[n- ...
- Head First Java & 重载 覆盖
- ASP.NET MVC 3.0 参考源码索引
http://www.projky.com/asp.netmvc/3.0/Microsoft/Internal/Web/Utils/CommonResources.cs.htmlhttp://www. ...
- Redis&PHP的使用安装-windows版
Redis是一个Key-value的数据结构存储系统,可以以数据库的形式,缓存系统,消息处理器使用,它支持的存储value类型很多,例如,string.list(链表).set(集合).zset(so ...
- PHP 中各种命名规则的总结
一般约定而言 类.函数和变量的名字应该是能够让代码阅读者能够容易地知道这些代码的作用,应该避免使用凌磨两可的命名. 以下是在开发过程中常见的命名规则总结 1.类的命名 使用大写字母作为词的分割,其余的 ...
- [转帖] Linux buffer 和 cache相关内容
Linux中Buffer/Cache清理 Lentil2018年9月6日 Linux中的buff/cache可以被手动释放,释放缓存的代码如下: https://lentil1016.cn/linux ...
- 抽奖系统 random()
random() 方法可返回介于 0 ~ 1 之间的一个随机数. document.write(parseInt(10*Math.random())); //输出0-10之间的随机整数document ...
- 微信小程序组件 日历
js文件 'use strict'; let choose_year = null, choose_month = null; const conf = { data: { hasEm ...
- hdu 4686 Arc of Dream(矩阵快速幂)
链接:http://acm.hdu.edu.cn/showproblem.php?pid=4686 题意: 其中a0 = A0ai = ai-1*AX+AYb0 = B0bi = bi-1*BX+BY ...
- 半夜思考之查漏补缺, Spring 中的容器后处理器
之前学 Spring 的时候 , 还没听过容器后处理器 , 但是一旦写出来 , 就会觉得似曾相识 . 容器配置器通常用于对 Spring 容器进行处理 , 并且总是在容器实例化任何其他 Bean 之前 ...