
SparkSql自定义数据源之读取的实现
一.sparksql读取数据源的过程
1.spark目前支持读取jdbc,hive,text,orc等类型的数据,如果要想支持hbase或者其他数据源,就必须自定义
2.读取过程
(1)sparksql进行 session.read.text()或者 session.read .format("text") .options(Map("a"->"b")).load("")
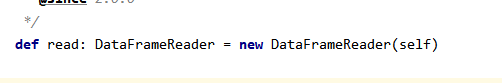

read.方法:创建DataFrameReader对象
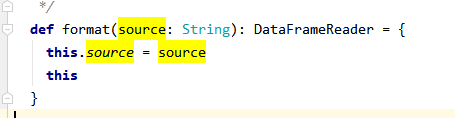
format方法:赋值DataFrameReade数据源类型
options方法:赋值DataFrameReade额外的配置选项

进入 session.read.text()方法内,可以看到format为“text”
(2)进入load方法
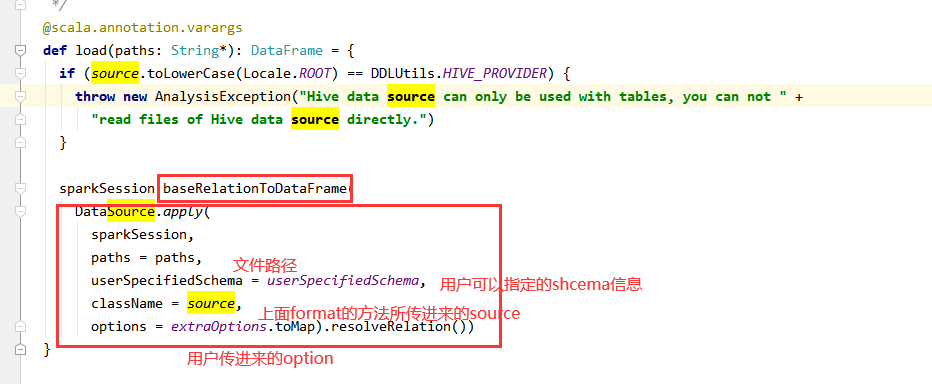
load原来是:sparkSession.baseRelationToDataFrame这个方法最终创建dataframe
(3)进入DataSource的resolveRelation()方法
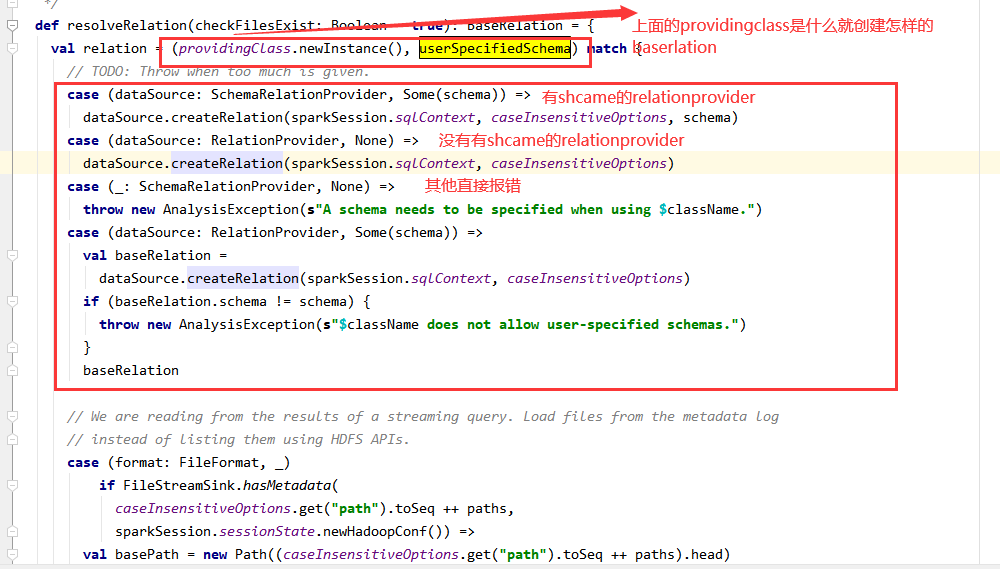
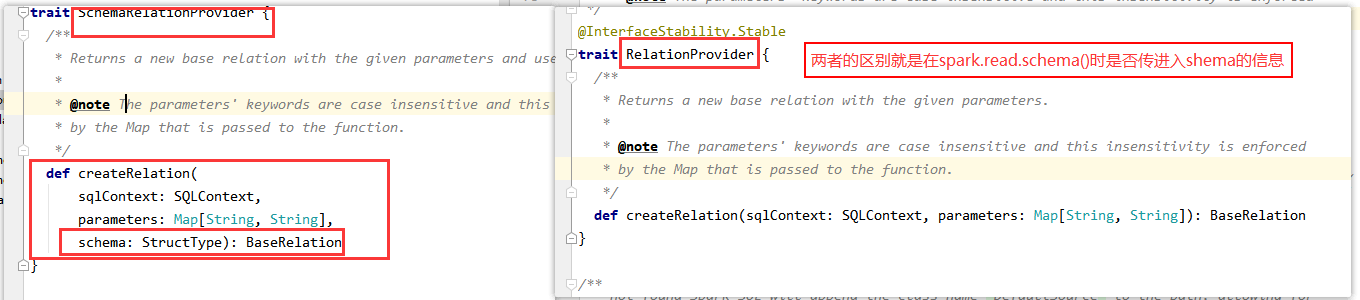
此段就是:providingClass这个类是哪一个接口的实现类,分为有shema与没有传入schema的两种
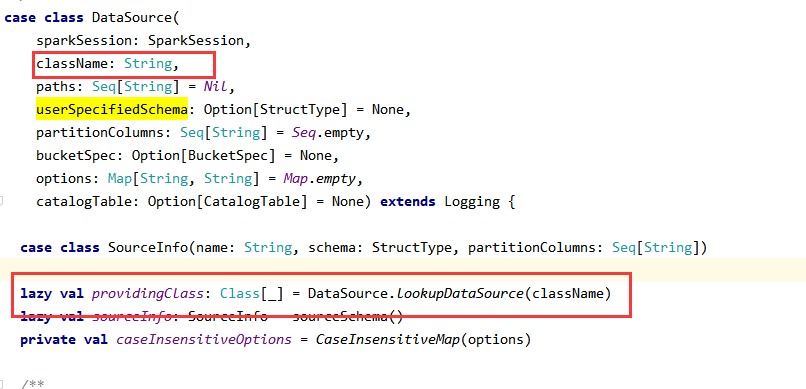
(3)providingClass是format传入的数据源类型,也就是前面的source
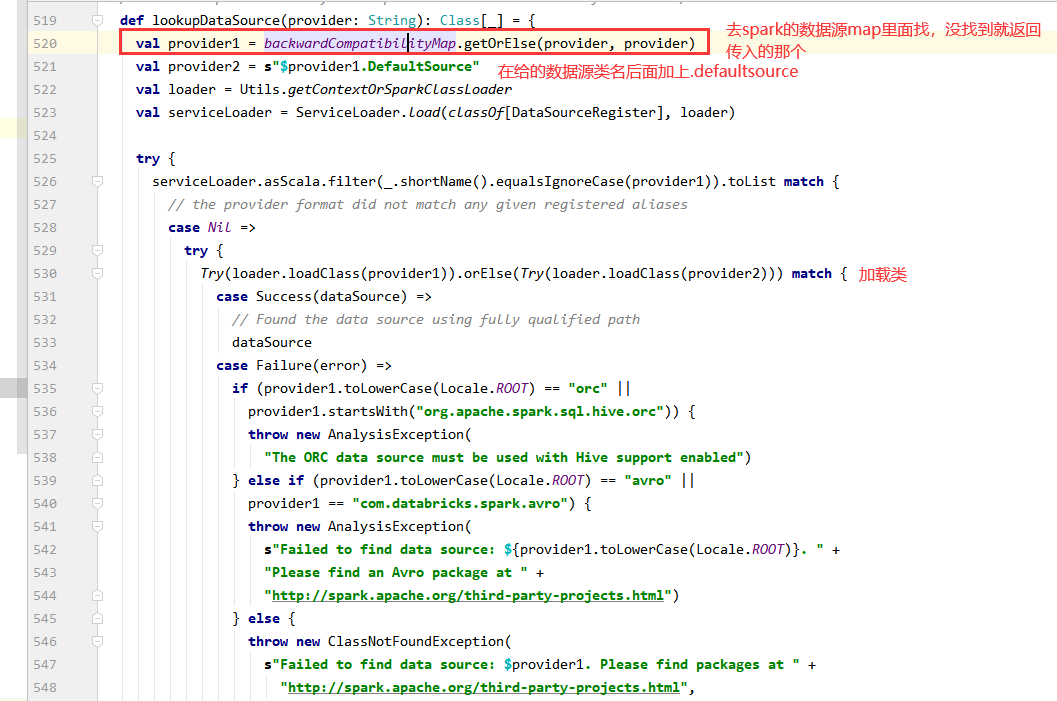
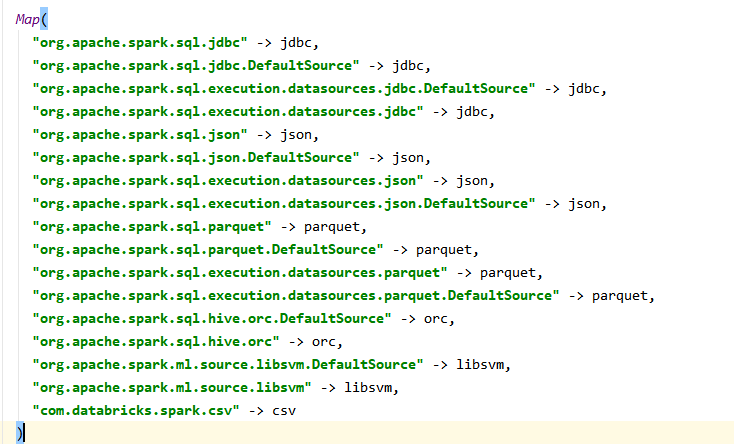
spark提供的所有数据源的map
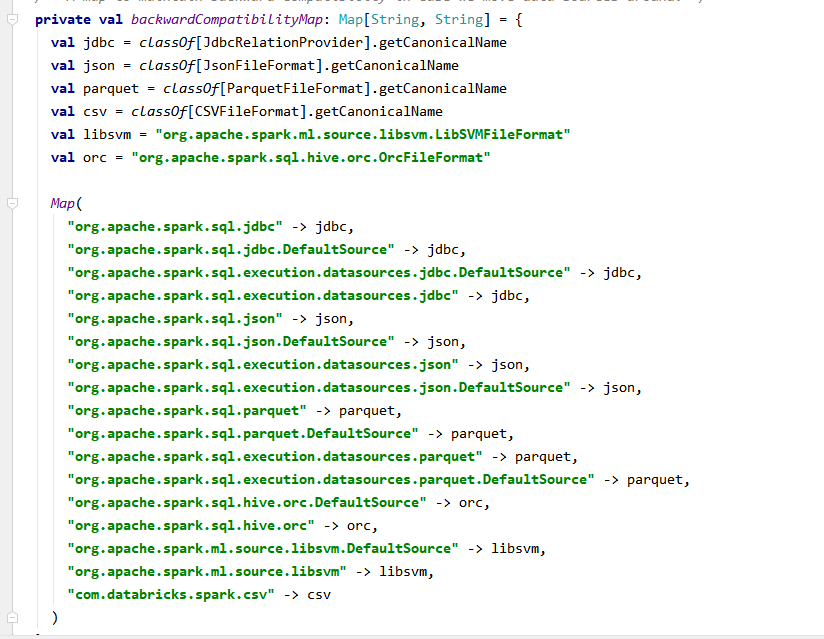
4.得出结论只要写一个类,实现RelationProvider下面这个方法,在方法里面返回一个baserelation
def createRelation(sqlContext: SQLContext, parameters: Map[String, String]): BaseRelation
我们在实现baserelation里面的逻辑就可以了

5.看看spark读取jdbc类
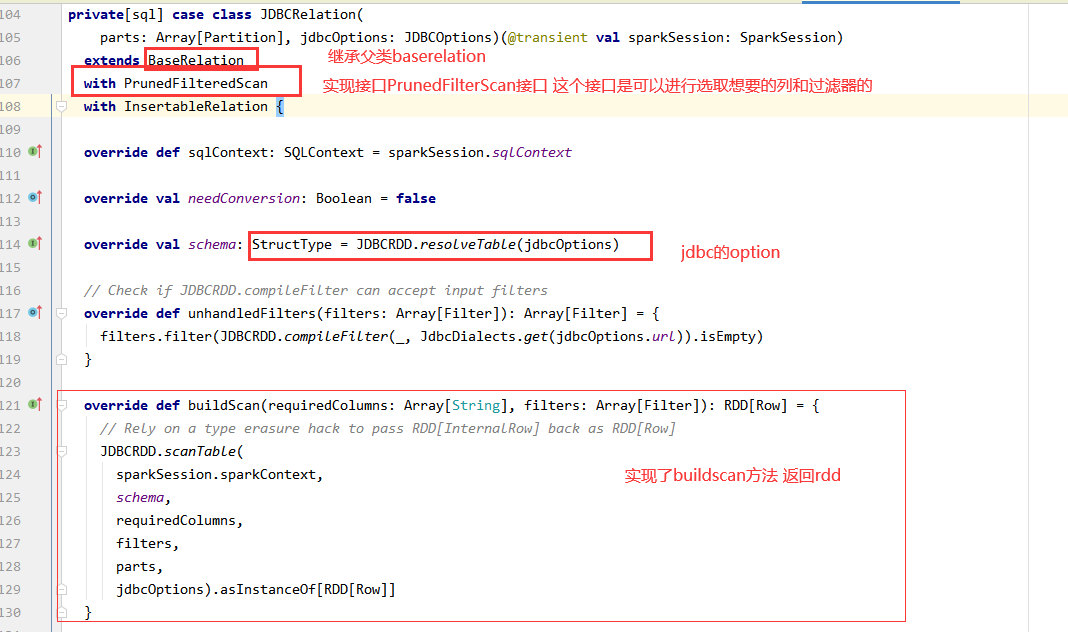
需要一个类,实现xxxScan这中类,这种类有三种,全局扫描tableScan,PrunedFilteredScan(列裁剪与谓词下推),PrunedScan ,
实现buildscan方法返回row类型rdd,结合baserelation有shcame这个变量 ,就凑成了dataframe
6.jdbcRdd.scanTable方法,得到RDD
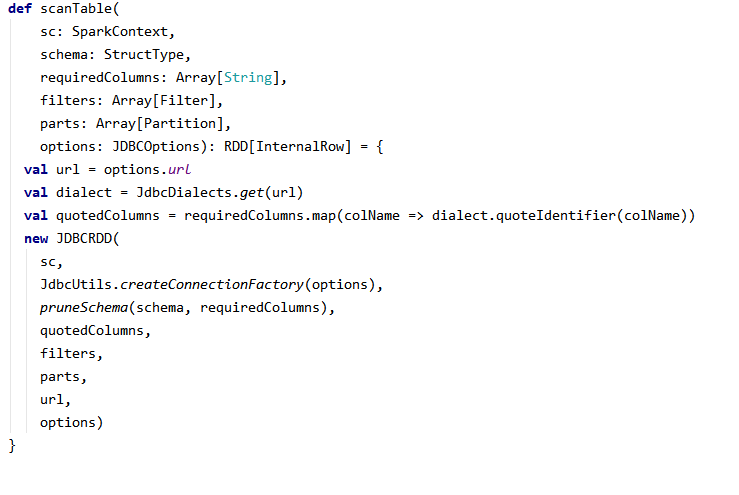
7.查看jdbcRDD的compute方法,是通过jdbc查询sql的方式获取数据
RDD的计算是惰性的,一系列转换操作只有在遇到动作操作是才会去计算数据,而分区作为数据计算的基本单位。在计算链中,无论一个RDD有多么复杂,其最终都会调用内部的compute函数来计算一个分区的数据。
override def compute(thePart: Partition, context: TaskContext): Iterator[InternalRow] = {

    var closed = false

    var rs: ResultSet = null

    var stmt: PreparedStatement = null

    var conn: Connection = null

    def close() {

      if (closed) return

      try {

        if (null != rs) {

          rs.close()

        }

      } catch {

        case e: Exception => logWarning("Exception closing resultset", e)

      }

      try {

        if (null != stmt) {

          stmt.close()

        }

      } catch {

        case e: Exception => logWarning("Exception closing statement", e)

      }

      try {

        if (null != conn) {

          if (!conn.isClosed && !conn.getAutoCommit) {

            try {

              conn.commit()

            } catch {

              case NonFatal(e) => logWarning("Exception committing transaction", e)

            }

          }

          conn.close()

        }

        logInfo("closed connection")

      } catch {

        case e: Exception => logWarning("Exception closing connection", e)

      }

      closed = true

    }

    context.addTaskCompletionListener{ context => close() }

    val inputMetrics = context.taskMetrics().inputMetrics

    val part = thePart.asInstanceOf[JDBCPartition]

    conn = getConnection()

    val dialect = JdbcDialects.get(url)

    import scala.collection.JavaConverters._

    dialect.beforeFetch(conn, options.asProperties.asScala.toMap)

    // H2's JDBC driver does not support the setSchema() method.  We pass a

    // fully-qualified table name in the SELECT statement.  I don't know how to

    // talk about a table in a completely portable way.

//坐上每个分区的Filter条件

    val myWhereClause = getWhereClause(part)

  //最終查询sql语句

    val sqlText = s"SELECT $columnList FROM ${options.table} $myWhereClause"

//jdbc查询

    stmt = conn.prepareStatement(sqlText,

        ResultSet.TYPE_FORWARD_ONLY, ResultSet.CONCUR_READ_ONLY)

    stmt.setFetchSize(options.fetchSize)

    rs = stmt.executeQuery()

    val rowsIterator = JdbcUtils.resultSetToSparkInternalRows(rs, schema, inputMetrics)

//返回迭代器

    CompletionIterator[InternalRow, Iterator[InternalRow]](

      new InterruptibleIterator(context, rowsIterator), close())

  }
SparkSql自定义数据源之读取的实现的更多相关文章
- JDBC 学习笔记(三)—— 数据源(数据库连接池):DBCP数据源、C3P0 数据源以及自定义数据源技术
本文目录: 1.应用程序直接获取连接的缺点(图解) 2.使用数据库连接池优化程序性能(图解) 3.可扩展增强某个类方法的功能的三种方式 4.自定 ...
- Pro自定义数据源原理
1. 概念 Connector:定义连接到一个数据源的连接信息,用于创建datastore. Datastore:代表一个数据源的实例,用于打开一个或多个tables或feature class. ...
- 入门大数据---SparkSQL外部数据源
一.简介 1.1 多数据源支持 Spark 支持以下六个核心数据源,同时 Spark 社区还提供了多达上百种数据源的读取方式,能够满足绝大部分使用场景. CSV JSON Parquet ORC JD ...
- FastReport自定义数据源及ListView控件的使用
##1.想批量生成一堆物资信息卡,效果如下图所示,fastreport可以一下全部生成,并且发现不用单独写东西, ##2.发现FastReport官方给出的Demo.exe很友好,基本可以满足要求,想 ...
- C#读取Excel文件:通过OleDb连接,把excel文件作为数据源来读取
转载于:http://developer.51cto.com/art/200908/142392.htm C#读取Excel文件可以通过直接读取和OleDb连接,把excel文件作为数据源来读取: ...
- Aspose.Word邮件合并之自定义数据源
Aspose.Word在进行邮件合并时,默认的几个重载方法对Database支持比较友好,但是也可以通过自定义数据源来实现从集合或者对象中返回数据进行邮件合并. 自定义数据源主要是通过实现IMailM ...
- 20. Spring Boot 默认、自定义数据源 、配置多个数据源 jdbcTemplate操作DB
Spring-Boot-2.0.0-M1版本将默认的数据库连接池从tomcat jdbc pool改为了hikari,这里主要研究下hikari的默认配置 0. 创建Spring Boot项目,选中 ...
- WinForm中使用CrystalReport水晶报表——基础,分组统计,自定义数据源
开篇 本篇文章主要是帮助刚开始接触CrystalReport报表的新手提供一个循序渐进的教程.该教程主要分为三个部分1)CrystalReport的基本使用方法:2)使用CrystalReport对数 ...
- 如何在ASP.NET Core自定义中间件中读取Request.Body和Response.Body的内容?
原文:如何在ASP.NET Core自定义中间件中读取Request.Body和Response.Body的内容? 文章名称: 如何在ASP.NET Core自定义中间件读取Request.Body和 ...
随机推荐
- PyQt(Python+Qt)学习随笔:Qt Designer中主窗口对象dockNestingEnabled属性
dockNestingEnabled 属性是确认主窗口的浮动部件(dock widget)是否允许嵌套的一个属性. 如果此属性为False,则浮动部件停靠区域只能包含一个浮动部件(水平或垂直).如果此 ...
- Scrum冲刺_Day01
一.团队展示: 1.项目:light_note备忘录 2.队名:删库跑路队 3.团队成员 队员(不分先后) 项目角色 黄敦鸿 后端工程师.测试 黄华 后端工程师.测试 黄骏鹏 后端工程师.测试 黄源钦 ...
- 手把手教你写DI_0_DI是什么?
DI是什么? Dependency Injection 常常简称为:DI. 它是实现控制反转(Inversion of Control – IoC)的一个模式. fowler 大大大神 "几 ...
- Social Infrastructure Information Systems Division, Hitachi Programming Contest 2020 C题题解
首先,我们将题目理解成若\(i\)与\(j\)距离恰好为\(3\),则不可能\(p_i \equiv p_j \equiv 1 \space or \space 2 (\bmod 3)\).这就相当于 ...
- stringbuilder和stringbuffer速度比较
同样的代码,只改了类型,分别为stringbuilder和stringbuffer,只比较一下,执行引擎为hive. 当数据量为100000条,string builder耗时280秒,stringb ...
- Robot Framework+adb框架自动化测试Android设备案例⑹——源码地址、测试报告
一.源码地址 GitHub:https://github.com/xiongye105554598/DVR8010_AutoTest 二.测试报告
- Jmeter(3)返回内容乱码
一.创建jmeter实例测试百度接口返回 1.添加线程组 2.添加取样器 3.添加监听器 二.运行结果如下 返回结果中有乱码,原因是Jmeter取样器结果的编码默认为sampleresult.defa ...
- [python学习手册-笔记]004.动态类型
004.动态类型 ❝ 本系列文章是我个人学习<python学习手册(第五版)>的学习笔记,其中大部分内容为该书的总结和个人理解,小部分内容为相关知识点的扩展. 非商业用途转载请注明作者和出 ...
- ecshop v2 v3 EXP
import requests import binascii def get_v2Payload(code): '''Ecshop V2.x payload''' code = "{$ab ...
- CCNP第二天之复习CCNA
1.静态路由的扩展配置: (1).环回接口: 在设备上用于测试TCP/IP协议栈能否正常使用.默认没有.需要手工创建 R1(config)#interface loopback 1 ...