
第3章 探索性数据分析(单因子&对比)与可视化
1、理论铺垫
Dataframe和Series均适用
~集中趋势:均值mean()、中位数median()、与分位数quantile(q=0.25)、众数mode()
~离中趋势:标准差std()、方差var()
数据分布:偏态skew()与峰态kurt()、正态分布与三大分布正偏态(mean>median)
import scipy.stats as ss
正态分布:ss.norm 、卡方分布:ss.chi2 、t分布:ss.chi2、f分布:ss.chi2
偏态系数:数据平均值偏离状态的衡量
峰态系数:数据分布集中强度的衡量
~ 抽样定理:抽样误差、抽样精度
data.sample(10) #抽10个
data.sample(frac = 0.001) #抽样百分比为0.001
2、数据分类
· 定类(类别):根据事物离散、无差别属性进行的分类,如:名族
· 定序(顺序):可以界定数据的大小,但不能测定差值:如:收入的低、中、高
· 定距(间隔):可以界定数据大小的同时,可测定差值,但无绝对零点,如:温度
· 定比(比率):可以界定数据大小,可测定差值,有绝对零点,如:身高、体重
3、单属性分析
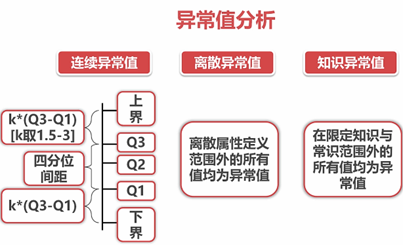
3.1异常值分析
离散异常值,连续异常值,常识异常值
3.2对比分析
绝对数与相对数(比什么),时间、空间、经验与计划(如何比)
绝对数比较:绝对的数字的比较,例如:收入
相对数比较:将几个有联系的指标进联合,构成一个新的数
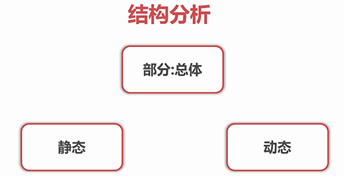
3.3结构分析
各组成部分的分布与规律
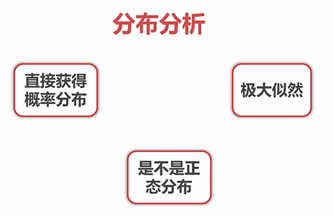
3.4分布分析
数据分布频率的显式分析
其中seaborn是matplotlib的封装
Seaborn官网: http://seaborn.pydata.org/api.html
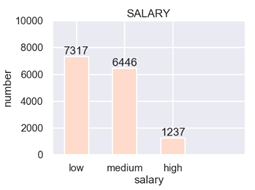
(1)柱状图 --- 以纵轴表示数值大小
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
#其中seaborn是matplotlib的封装
data = pd.read_csv('HR.csv',sep=',')
pd.set_option('display.max_columns',None) #控制列的输出
#处理异常之后的数据
data = data[data['last_evaluation']<=1][data['department']!='sale'][data['salary']!='nme']
#设置图画格式
sns.set_style(style="darkgrid")#style="whitegrid"

sns.set_context(context="poster",font_scale=0.5)

sns.set_palette(sns.color_palette('Reds'))

plt.title('SALARY')

plt.xlabel('salary')

plt.ylabel('number')

#设置横轴的显示

plt.xticks(0.5+np.arange(len(data['salary'].value_counts())),data['salary'].value_counts().index)

#设置横轴显示的最小值是0,最大是4;纵轴显示的最小值是0,最大值是10000

plt.axis([0,4,0,10000])

plt.bar(0.5+np.arange(len(data['salary'].value_counts())),data['salary'].value_counts(),width=0.5)

for x,y in zip(0.5+np.arange(len(data['salary'].value_counts())),data['salary'].value_counts()):

    plt.text(x,y,y,ha="center",va="bottom")#对每一类进行标注,标注的值为y,水平位置是center,垂直位置是bottom

plt.show()

# sns.countplot(x="salary",data=data)

sns.countplot(x="salary",hue= "department",data=data)#多层绘制,例如以部门为分割

plt.show()
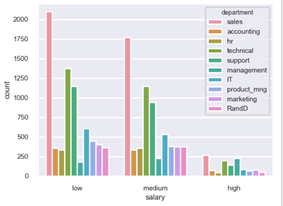
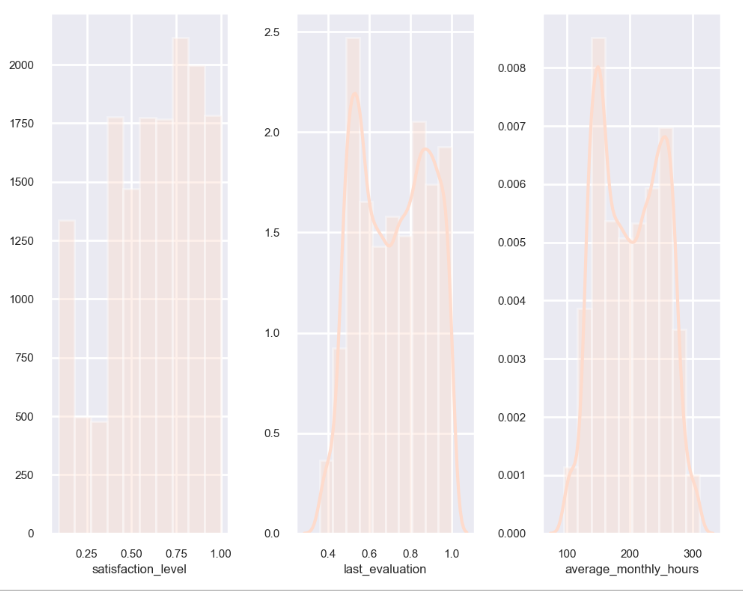
(2)直方图---以面积表示数值大小
横轴表示数据类型,纵轴表示分布情况
plt.figure(figsize=(10,8))

plt.subplot(1,3,1)

#其中kde表示可密度估计,hist表示直方图

sns.distplot(data['satisfaction_level'],bins=10,kde=False,hist=True)

plt.subplot(1,3,2)

sns.distplot(data['last_evaluation'],bins=10,kde=True,hist=True)

plt.subplot(1,3,3)

sns.distplot(data['average_monthly_hours'],bins=10,kde=True,hist=True)

plt.show()
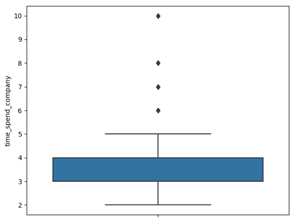
(3)箱线图
用于显示一组数据分散情况的统计图
#saturation=0.75表示上四分位数,whis=3表示k=3,默认值是1.5,其中y表示呈现方式

sns.boxplot(y = data['time_spend_company'],saturation=0.75,whis=1.5)

plt.show()
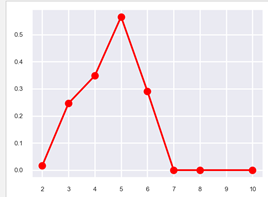
(4)折线图
matplotlib--- plt.plot();seaborn--- sns.poinplot()
值得一提的是:sns中对折线图有两种画法
(见标黄部分,可以直接指定x和y,两种写法一样,结果还可以指定上下界----此处疯狂打call)
sub_data = data.groupby('time_spend_company').mean()

# print(sub_data)

sns.pointplot(sub_data.index,sub_data['left'])

# sns.pointplot(data['time_spend_company'],data['left'])

# plt.plot(sub_data.index,sub_data['left'],'ro-')

plt.show()

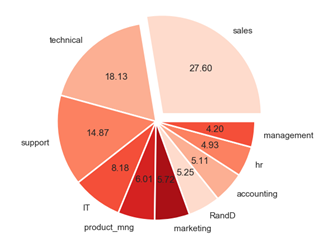
(5)饼图
seabon库中没有饼图的画法,只有matplotlib中有
libs = data['department'].value_counts().index

explodes = [0.1 if i == 'sales' else 0 for i in libs]

plt.pie(data['department'].value_counts(normalize=True),labels=libs,autopct="%.2f",colors=sns.color_palette('Reds'),explode = explodes)

plt.show()
第3章 探索性数据分析(单因子&对比)与可视化的更多相关文章
- 探索性数据分析EDA综述
目录 1. 数据探索的步骤和准备 2. 缺失值处理 为什么需要处理缺失值 Why data has missing values? 缺失值处理的技术 3. 异常值检测和处理 What is an ou ...
- “全栈2019”Java第四十九章:重载与重写对比详解
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java第 ...
- HTML第三章:表单
第三章:表单 表单标签form:<form></form>//相当于一张记录用户信息的单子 常用属性:method:表单的提交方式,常用的值有两个 ...
- 2017.2.28 activiti实战--第六章--任务表单(二)外置表单
学习资料:<Activiti实战> 第六章 任务表单(二)外置表单 6.3 外置表单 考虑到动态表单的缺点(见上节),外置表单使用的更多. 外置表单的特点: 页面的原样显示 字段值的自动填 ...
- 2017.2.28 activiti实战--第六章--任务表单(一)动态表单
学习资料:<Activiti实战> 第六章 任务表单(一)动态表单 内容概览:本章要完成一个OA(协同办公系统)的请假流程的设计,从实用的角度,讲解如何将activiti与业务紧密相连. ...
- 2017.2.22 activiti实战--第六章--任务表单
学习资料:<Activiti实战> 第六章 任务表单 本章将一步步完成一个协同办公系统(OA)的请假流程的设计,讲解如何将Activiti和实际业务联系起来. 首先讲解动态表单与外置表单的 ...
- 探索性数据分析(Exploratory Data Analysis,EDA)
探索性数据分析(Exploratory Data Analysis,EDA)主要的工作是:对数据进行清洗,对数据进行描述(描述统计量,图表),查看数据的分布,比较数据之间的关系,培养对数据的直觉,对数 ...
- python Pandas Profiling 一行代码EDA 探索性数据分析
文章大纲 1. 探索性数据分析 代码样例 效果 解决pandas profile 中文显示的问题 1. 探索性数据分析 数据的筛选.重组.结构化.预处理等都属于探索性数据分析的范畴,探索性数据分析是帮 ...
- 动态可视化 数据可视化之魅D3,Processing,pandas数据分析,科学计算包Numpy,可视化包Matplotlib,Matlab语言可视化的工作,Matlab没有指针和引用是个大问题
动态可视化 数据可视化之魅D3,Processing,pandas数据分析,科学计算包Numpy,可视化包Matplotlib,Matlab语言可视化的工作,Matlab没有指针和引用是个大问题 D3 ...
随机推荐
- 第一章 java基本多线程技能
第一章 java多线程技能 1 线程:进程是操作系统结构的基础,是一次程序的执行,是一个程序及其数据在处理顺序时发生的活动:是程序在一个数据集合上运行的过程,他是系统进行资源分配和调度的一个独立单位. ...
- Markdown小白教学15分钟速成
第一部分 基础篇 演示第二阶标题 1.1 目录与标题 代码过程 一级标题: 最高阶标题 基础篇 ===== 二级标题: 演示第二阶标题 一 ----- 注意: 这里"="和& ...
- 阿里云Linux CentOS8.1 64位服务器安装LNMP(Linux+Nginx+MySQL+PHP) 并发调试之Nginx配置
搭建好LNMP环境之后,接着要考虑的就是整个系统的并发能力了. 一.Nginx的配置 Nginx有很好的并发能力.但是要想使它的并发能力能够施展出来,需要在初步安装好的Nginx上做一些配置.主要需要 ...
- 如何快速部署一条Simplechain子链
我们都知道Simplechain是一种主子链架构,主链Simplechain是POW共识算法的公链.那如何快速创建一条属于自己的子链呢?下面我们就是快速部署一条子链流程.首先clone 源码, 然后按 ...
- 「疫期集训day2」高地
硝烟从凡尔登高地的东方升起...我只知道这里会发生世界上前所未有的一次战役------凡尔登的法军士兵 今天运气挺好,早自习刚复习完数论和二分图,考试时又复习了状压和Tarjan 于是乎成绩惨不忍睹 ...
- 使用CodeMirror插件遇到的问题
CodeMirror的正常使用: //首先通过<script>标签引入相应的js,这个就不必说了 var myCodeMirror = CodeMirror.fromTextArea(my ...
- InnoDB表存储结构及keyring加密
ibdata是InnoDB最重要的系统表空间文件,它记录了InnoDB的核心信息,包括事务系统信息.元数据信息,记录InnoDB change buffer的btree,防止数据损坏的double w ...
- 使用Vue做出跑马灯效果
<div id="pmd"> <h4> {{msg}}</h4> <input type="b ...
- bzoj3062[Usaco2013 Feb]Taxi*
bzoj3062[Usaco2013 Feb]Taxi 题意: Bessie在农场上为其他奶牛提供出租车服务,她必须赶到这些奶牛的起始位置,并把他们带到它们的目的地.Bessie的车很小,所以她只能一 ...
- bzoj3437小P的牧场
bzoj3437小P的牧场 题意: n个牧场,在每个牧场见控制站的花费为ai,在该处建控制站能控制从此处到左边第一个控制站(或边界)之间的牧场.一个牧场被控制的花费等于它到控制它的控制站之间的牧场数目 ...