
在单机Hadoop上面增加Slave
之前的文章已经介绍了搭建单机Hadoop, HBase, Hive, Spark的方式:link
现在希望在单机的基础上,加一个slave。
首先需要加上信任关系,加信任关系的方式,见前一篇文章:link
把05和06这两台机器,分别和对方添加上信任关系。
把05上面的目录 /home/work/data/installed/hadoop-2.7.3/ 拷贝到06机器,
把 etc/hadoop 里面的 IP 10.117.146.12 都改成 11
然后06机器 要安装 jumbo 和 Java1.8
安装好之后,JAVA_HOME应该和05机器上配置的一样:
export JAVA_HOME=/home/work/.jumbo/opt/sun-java8
另外要创建这个目录 /home/work/data/hadoop/dfs
然后启动下面这些服务:
首先格式化hdfs:
 ./bin/hdfs namenode -format myclustername

// :: INFO util.ExitUtil: Exiting with status
在slave上面要部署的服务有 datanode, node_manager(没有namenode)
启动datanode
$ ./sbin/hadoop-daemon.sh --script hdfs start datanode

starting datanode, logging to /home/work/data/installed/hadoop-2.7./logs/hadoop-work-datanode-gzns-ecom-baiduhui--m42n06.gzns.baidu.com.out
启动node manager
$ ./sbin/yarn-daemon.sh start nodemanager

starting nodemanager, logging to /home/work/data/installed/hadoop-2.7./logs/yarn-work-nodemanager-gzns-ecom-baiduhui--m42n06.gzns.baidu.com.out
在master上面增加slave (etc/hadoop/slaves) :
localhost

10.117.146.11
然后看下master的几个管理平台:
Overview: http://10.117.146.12:8305
Yarn: http://10.117.146.12:8320
Job History: http://10.117.146.12:8332/jobhistory
Spark:http://10.117.146.12:8340/
上网搜了一个,用root帐号将两台机器的 /etc/hosts都改成了
127.0.0.1               localhost.localdomain localhost

10.117.146.12           master.Hadoop

10.117.146.11           slave1.Hadoop

以下一样:

127.0.0.1               localhost.localdomain localhost

10.117.146.12           master.Hadoop

10.117.146.11           slave1.Hadoop
然后把 etc/hadoop/slaves里的内容都改成:
slave1.Hadoop
加了一个文件 etc/hadoop/masters
master.Hadoop
但是,还是始终发现master和slave是各自独立的,然后在slave上起了namenode 和 yarn之后,slave就知看到自己一个live node了。
看了一下,把所有的服务都停掉,看是否能用 ./sbin/start-all.sh ,跑了一下,发现有提示输入 work@localhost密码的,然后grep了一下localhost,发现在core-site.xml有localhost的配置:
<name>fs.defaultFS</name>

<value>hdfs://localhost:8390</value>
感觉需要把slave的这里也改掉。然后试了一下,把master和slave的这个地方都改成如下:
<name>fs.defaultFS</name>

<value>hdfs://master.Hadoop:8390</value>
然后,在slave启动datanode报错,错误日志:
-- ::, WARN org.apache.hadoop.hdfs.server.common.Storage: Failed to add storage directory [DISK]file:/home/work/data/hadoop/dfs/data/

java.io.IOException: Incompatible clusterIDs in /home/work/data/hadoop/dfs/data: namenode clusterID = CID-9808571a-21c3-4aeb-a114-19b99b4722d2; datanode clusterID = CID-c2a59c40-0a4b-4aba-bbab-31ec15b8d64d
貌似是namenode和datanode冲突了。用 rm -rf /home/work/data/hadoop/dfs/data/ 把data node目录整体删掉。
重新启动master上面的所有服务。
然后在slave上面重新启动datanode:
./sbin/hadoop-daemon.sh --script hdfs start datanode

在日志里能看到heartbeat的内容,看起来通信成功了。
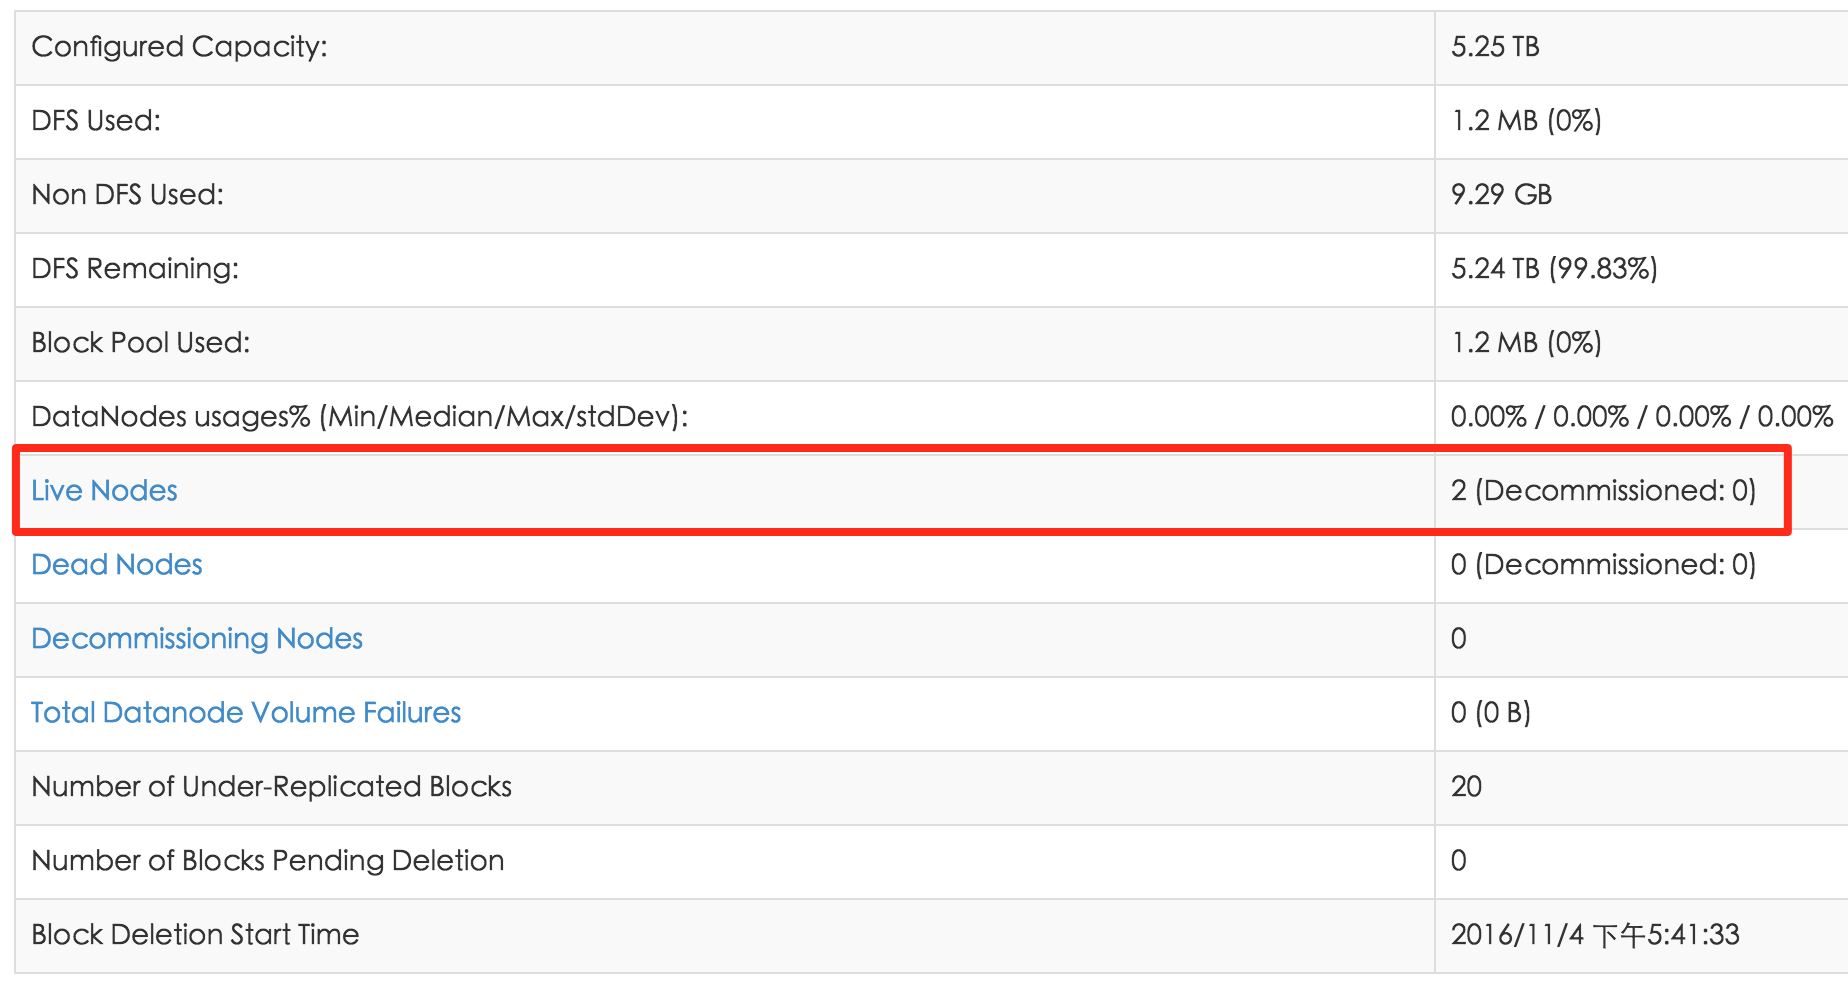
再打开master的管理界面:
http://10.117.146.12:8305/dfshealth.html 能够看到两台node了:
现在再把slave的node manager也启动:
$ ./sbin/yarn-daemon.sh start nodemanager

starting nodemanager, logging to /home/work/data/installed/hadoop-2.7./logs/yarn-work-nodemanager-gzns-ecom-baiduhui--m42n06.gzns.baidu.com.out
然后观察下管理界面的各个指标。
发现yarn里面还是只看到一台机器。感觉还是配置的地方有问题。
首先master和slave的配置应该是一样的。改了如下的地方:
hdfs-site.xml
<property>

        <name>dfs.namenode.http-address</name>

        <value>master.Hadoop:</value>

    </property>

    <property>

        <name>dfs.namenode.secondary.http-address</name>

        <value>master.Hadoop:</value>

    </property>
mapred-site.xml
<property>

        <name>mapreduce.jobhistory.address</name>

        <value>master.Hadoop:</value>

    </property>

    <property>

        <name>mapreduce.jobhistory.webapp.address</name>

        <value>master.Hadoop:</value>

    </property>
yarn-site.xml
<property>

        <name>yarn.resourcemanager.hostname</name>

        <value>master.Hadoop</value>

    </property>

    <property>

        <name>yarn.resourcemanager.webapp.address</name>

        <value>master.Hadoop:</value>

    </property>
<property>
<name>yarn.log.server.url</name>
<value>http://master.Hadoop:8325/jobhistory/logs/</value>
</property>
然后重启master和slave的所有服务。
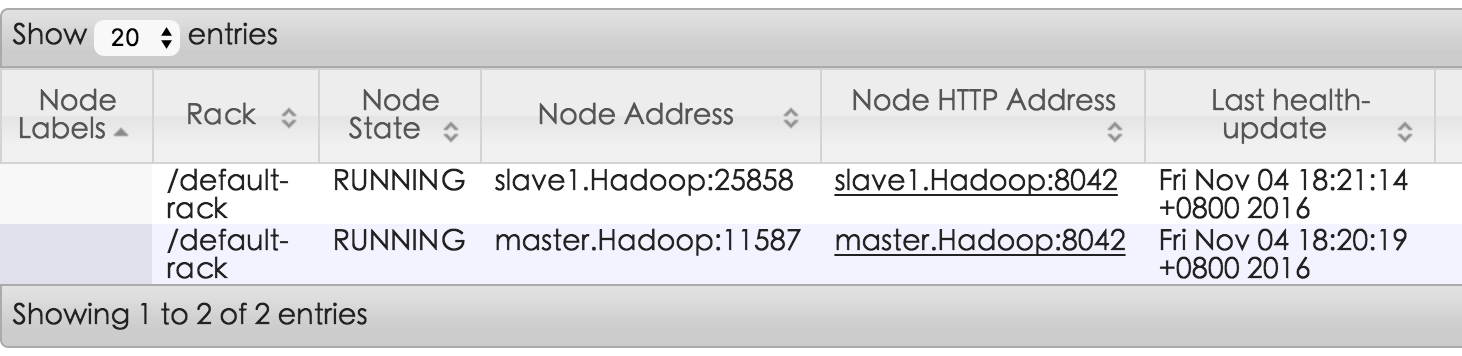
启动完成之后,在以上各个管理界面能够正常看到两个节点啦。
http://10.117.146.12:8305/dfshealth.html#tab-overview
http://10.117.146.12:8332/jobhistory
http://10.117.146.12:8320/cluster/nodes
跑一条命令试试:
$ ./bin/hadoop jar ./share/hadoop/tools/lib/hadoop-streaming-2.7..jar -input /input -output /output -mapper cat -reducer wc

packageJobJar: [/tmp/hadoop-unjar8343786587698780884/] [] /tmp/streamjob8627318309812657341.jar tmpDir=null

// :: INFO client.RMProxy: Connecting to ResourceManager at master.Hadoop/10.117.146.12:

// :: INFO client.RMProxy: Connecting to ResourceManager at master.Hadoop/10.117.146.12:

// :: ERROR streaming.StreamJob: Error Launching job : Output directory hdfs://master.Hadoop:8390/output already exists

Streaming Command Failed!
发现失败。要删除output目录,但是像以前那样删不行,要加上hdfs的前缀:
$ ./bin/hadoop fs -rm output

rm: `output': No such file or directory

$ ./bin/hadoop fs -rm -r hdfs://master.Hadoop:8390/output

// :: INFO fs.TrashPolicyDefault: Namenode trash configuration: Deletion interval =  minutes, Emptier interval =  minutes.

Deleted hdfs://master.Hadoop:8390/output
然后重新跑:
$ ./bin/hadoop jar ./share/hadoop/tools/lib/hadoop-streaming-2.7..jar -input /input -output /output -mapper cat -reducer wc

命令成功

$ ./bin/hadoop fs -ls hdfs://master.Hadoop:8390/output

Found  items

-rw-r--r--    work supergroup           -- : hdfs://master.Hadoop:8390/output/_SUCCESS

-rw-r--r--    work supergroup          -- : hdfs://master.Hadoop:8390/output/part-00000

$ ./bin/hadoop fs -cat hdfs://master.Hadoop:8390/output/part-00000
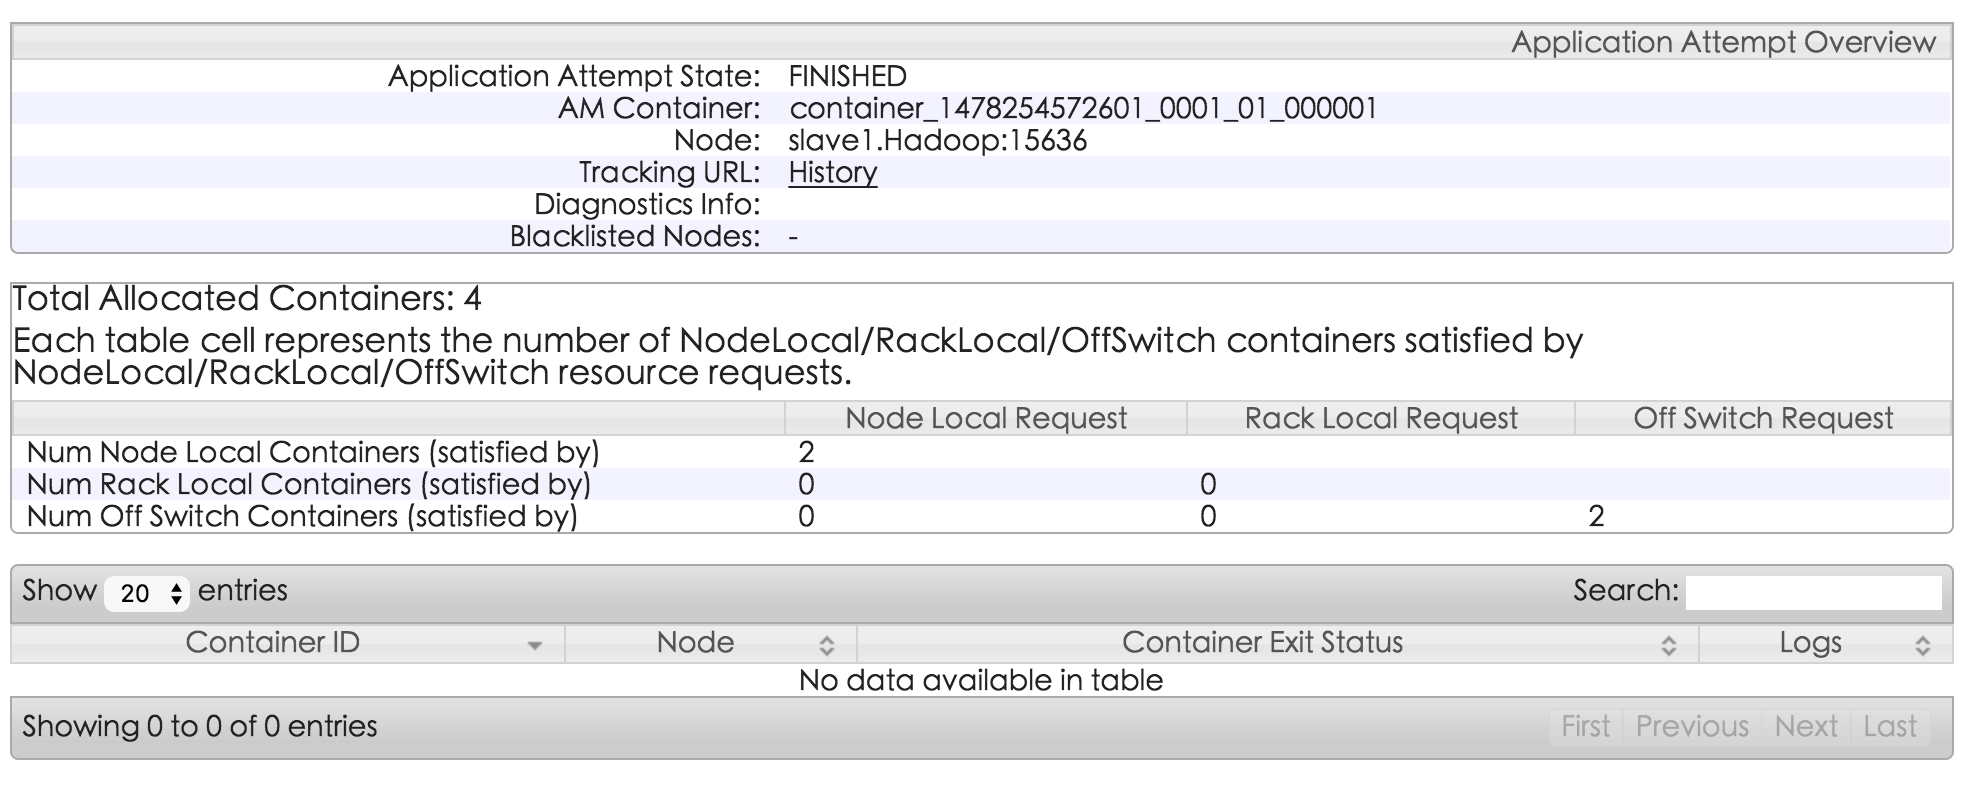
得到了结果。也不太看的出来是哪台机器上跑的。
在单机Hadoop上面增加Slave的更多相关文章
- 单机Hadoop搭建
通过一段时间的学习,我在我的centos上安装了单机hadoop,如果这对你有帮助,就进来探讨学习一下 Hadoop伪分布式配置 Hadoop 可以在单节点上以伪分布式的方式运行,Hadoop 进程以 ...
- Hadoop,master和slave简单的分布式搭建
搭建过程中配置免密钥登录为了以后方便使用 [提醒]安装Hadoop中会遇到新建文件夹,配置路径等问题,这个不能生搬硬套,要使用自己配置的路径,灵活使用. Hadoop的部署配置文件在http://bl ...
- 单机Hadoop的安装与使用
第一步:安装操作系统并创建Hadoop用户 OS:RHEL6.5 [root@hadoop ~]# useradd hadoop [root@hadoop ~]# passwd hadoop 第二步: ...
- Centos 7 配置单机Hadoop
Centos 7 配置单机Hadoop 2018年10月11日 09:48:13 GT_Stone 阅读数:82 系统镜像:CentuOS-7-x86_64-Everything-1708 Jav ...
- Hadoop单机Hadoop测试环境搭建
Hadoop单机Hadoop测试环境搭建: 1. 安装jdk,并配置环境变量,配置ssh免密码登录 2. 下载安装包hadoop-2.7.3.tar.gz 3. 配置/etc/hosts 127.0. ...
- Hadoop 添加删除Slave
Hadoop 添加删除Slave @(Hadoop) 在hdfs-site.xml文件中添加如下配置: <property> <name>dfs.hosts</name& ...
- 1、大数据 Hadoop配置和单机Hadoop系统配置
#查看服务器ip ip add #设置主机名称 hostnamectl set-hostname master bash #查看 hostname #绑定ip vi /etc/hosts 添加 服务器 ...
- 【3】测试搭建成功的单机hadoop环境
1.关闭防火墙service iptables stop,(已经设置开机关闭的忽略) 2.进入hadoop目录,修改hadoop配置文件(4个) core-site.xml(核心配置,fs.defau ...
- 安装单机Hadoop系统(完整版)——Mac
在这个阴雨绵绵的下午,没有睡午觉的我带着一双惺忪的眼睛坐在了电脑前,泡上清茶,摸摸已是略显油光的额头(笑cry),,奋斗啊啊啊啊!!%>_<% 1.课程回顾. 1.1 Hadoop系统运行 ...
随机推荐
- 无法解决 equal to 运算中 "Chinese_PRC_CI_AS" 和 "SQL_Latin1_General_CP1_CI_AS" 之间的排序规则冲突。
什么是排序规则(collation) 关于SQL Server的排序规则,估计大家都不陌生,在创建数据库时我们经常要选择一种排序规则(conllation),一般我们会留意到每一种语言的排序规则都有许 ...
- SSRF攻击实例解析
ssrf攻击概述 很多web应用都提供了从其他的服务器上获取数据的功能.使用用户指定的URL,web应用可以获取图片,下载文件,读取文件内容等.这个功能如果被恶意使用,可以利用存在缺陷的web应用作为 ...
- [转载]为什么我希望用C而不是C++来实现ZeroMQ
来源: http://blog.jobbole.com/19647/ 开始前我要先做个澄清:这篇文章同Linus Torvalds这种死忠C程序员吐槽C++的观点是不同的.在我的整个职业生涯里我都在使 ...
- 教你如何利用xml格式的sitemap文件做好SEO
教你如何利用xml格式的sitemap文件做好SEO 浏览: | 更新:-- : 一般的网站中都有网站地图文件,它有HTML格式与XML格式,网站地图可以帮助搜索引擎抓取.帮助用户找到自己所需要的内容 ...
- idHTTP访问百度
百度屏蔽了indy的客户端标识的 Mozilla/3.0 (compatible; Indy Library),把‘Indy Library’去掉就可以了. try IdHTTP1.Request.U ...
- springmvc web应用程序 java
搭建普通 springmvc 1.如图建立相关文件 建立在WEB-INF下比较安全,不能直接访问资源. 2.建立Controller控制器,如图 3.需要导入的jar包 commons-logging ...
- C# 与C/C++相互调用
C++调用C#的DLLhttp://www.csharpwin.com/csharpspace/11385r8940.shtml C#调用C/C++动态库必须注意的几个问题http://www.rob ...
- 【OpenCV入门教程之二】 一览众山小:OpenCV 2.4.8组件结构全解析
转自: http://blog.csdn.net/poem_qianmo/article/details/19925819 本系列文章由zhmxy555(毛星云)编写,转载请注明出处. 文章链接:ht ...
- Android Drawable体系
- Linux操作系统下的Sudo命令
查看.修改或者执行某些命令需要root用户的权限,如果不想直接切换到root用户,就可以使用sudo命令.sudo命令用于针对单个命令授予临时权限.sudo仅在需要时授予用户权限,减少了用户因为错误执 ...