
...python の 学习
5.14
...上次学python 好像是一个月前..
写点东西记录下叭..
现在在看李老大写的博客写..可能直接开抄代码...
感觉自己写的总是爬不成功,之前写的爬豆瓣影评的爬虫还是残的...
1.最简单的爬取一个网页
import urllib2
html = urllib2.urlopen('http://music.163.com/')
print html.read()
2.把爬取到的网页存起来
可是好像因为之前用了那个网页映射工具,现在生成 的 html 里面是当前目录下的东西,而不是自己爬的那个网页里面的内容...sigh..
import urllib2

response = urllib2.urlopen('http://music.163.com/')

html = response.read()

open('testt.html',"w").write(html)
3.爬取ZOL 的一张壁纸
import urllib2

import re # 正则表达式所用到的库

# 我们所要下载的图片所在网址

url = 'http://desk.zol.com.cn/bizhi/6377_78500_2.html'

response = urllib2.urlopen(url)

# 获取网页内容

html = response.read()

# 确定一个正则表达式,用来找到图片的所在地址

reg = re.compile(r'<img id="bigImg" src="(.*?jpg)" .*>');

imgurl = reg.findall(html)[]

# 打开图片并保存为haha.jpg

imgsrc = urllib2.urlopen(imgurl).read()

open("haha.jpg","w").write(imgsrc)
是直接抄的老大的代码
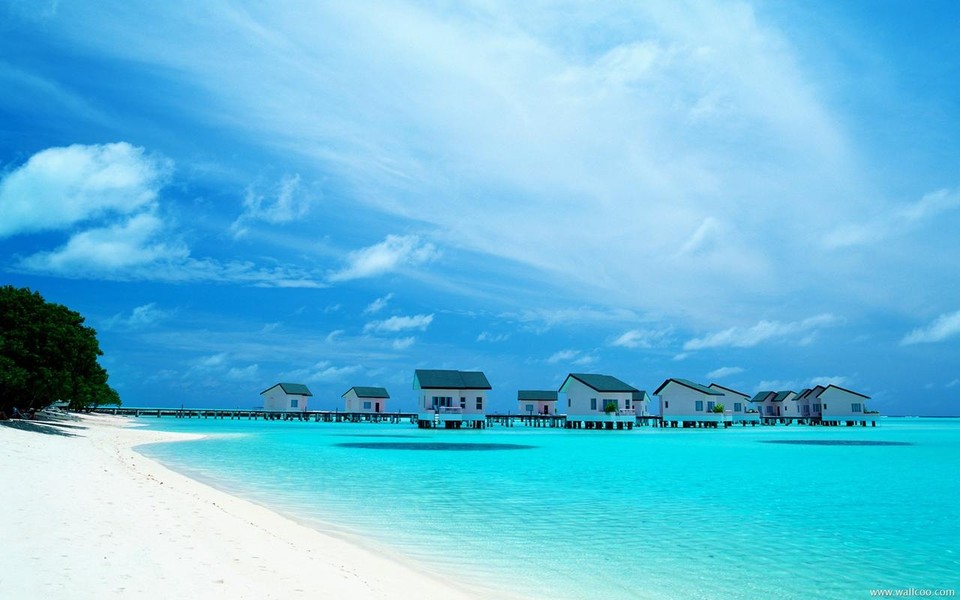
然而我爬出来的壁纸是这样的
不懂啊
解决了......
http://m.ithao123.cn/content-6589593.html
应该用 "wb" 去打开文件
import urllib2

import re

url = 'http://desk.zol.com.cn/bizhi/6377_78500_2.html'

response = urllib2.urlopen(url)

html = response.read()

reg = re.compile(r'<img id="bigImg" src="(.*?jpg)" .*>');

imgurl = reg.findall(html)[]

imgsrc = urllib2.urlopen(imgurl).read()

open("haha.jpg","wb").write(imgsrc)
然后
可以看到壁纸了,感人!!!
5.15
今天试了下李老大爬ZOL 壁纸 的代码,爬出来的文件夹里面是空的啊...而且文件名是乱码..
不过李老大说了那个只适用于linux
于是开始看 崔庆才 教程
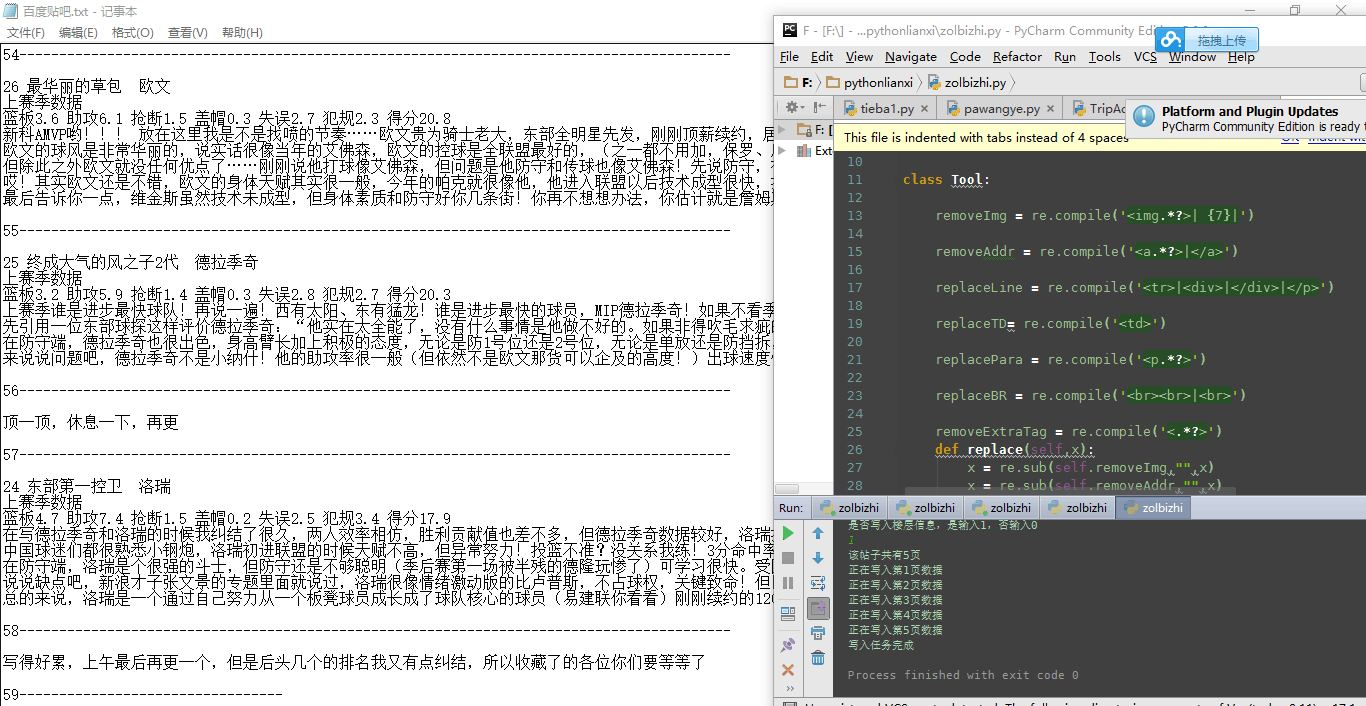
1.爬取贴吧帖子
效果图
然后在抄代码的过程中遇到三个问题
1) print 中文的时候会报错
一种解决方案是 这个
#!/usr/bin/python

 #coding:utf-
2)然后在改了上面那个问题后
会报错,像下面这样
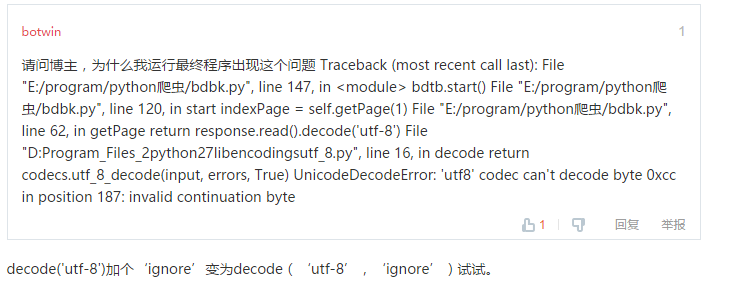
解决办法就是图里面说的这样
3.最后一个问题 就是 贴吧改版了
要换成
<h3 class="core_title_txt".*?>(.*?)</h3>

最后代码是这样的
#!/usr/bin/python

#coding:utf-

__author__ = 'CQC'

# -*- coding:utf- -*-

import urllib

import urllib2

import re

class Tool:

    removeImg = re.compile('<img.*?>| {7}|')

    removeAddr = re.compile('<a.*?>|</a>')

    replaceLine = re.compile('<tr>|<div>|</div>|</p>')

    replaceTD= re.compile('<td>')

    replacePara = re.compile('<p.*?>')

    replaceBR = re.compile('<br><br>|<br>')

    removeExtraTag = re.compile('<.*?>')

    def replace(self,x):

        x = re.sub(self.removeImg,"",x)

        x = re.sub(self.removeAddr,"",x)

        x = re.sub(self.replaceLine,"\n",x)

        x = re.sub(self.replaceTD,"\t",x)

        x = re.sub(self.replacePara,"\n    ",x)

        x = re.sub(self.replaceBR,"\n",x)

        x = re.sub(self.removeExtraTag,"",x)

        return x.strip()

class BDTB:

    def __init__(self,baseUrl,seeLZ,floorTag):

        self.baseURL = baseUrl

        self.seeLZ = '?see_lz='+str(seeLZ)

        self.tool = Tool()

        self.file = None

        self.floor =

        self.defaultTitle = u"百度贴吧"

        self.floorTag = floorTag

    def getPage(self,pageNum):

        try:

            url = self.baseURL+ self.seeLZ + '&pn=' + str(pageNum)

            request = urllib2.Request(url)

            response = urllib2.urlopen(request)

            return response.read().decode('utf-8','ignore')

        except urllib2.URLError, e:

            if hasattr(e,"reason"):

                print u"连接百度贴吧失败,错误原因",e.reason

                return None

    def getTitle(self,page):

        pattern = re.compile('<h3 class=core_title_txt.*?>(.*?)</h3>',re.S)

        result = re.search(pattern,page)

        if result:

            return result.group().strip()

        else:

            return None

    def getPageNum(self,page):

        pattern = re.compile('<li class="l_reply_num.*?</span>.*?<span.*?>(.*?)</span>',re.S)

        result = re.search(pattern,page)

        if result:

            return result.group().strip()

        else:

            return None

    def getContent(self,page):

        pattern = re.compile('<div id="post_content_.*?>(.*?)</div>',re.S)

        items = re.findall(pattern,page)

        contents = []

        for item in items:

            content = "\n"+self.tool.replace(item)+"\n"

            contents.append(content.encode('utf-8'))

        return contents

    def setFileTitle(self,title):

        if title is not None:

            self.file = open(title + ".txt","w+")

        else:

            self.file = open(self.defaultTitle + ".txt","w+")

    def writeData(self,contents):

        for item in contents:

            if self.floorTag == '':

                floorLine = "\n" + str(self.floor) + u"-----------------------------------------------------------------------------------------\n"

                self.file.write(floorLine)

            self.file.write(item)

            self.floor +=

    def start(self):

        indexPage = self.getPage()

        pageNum = self.getPageNum(indexPage)

        title = self.getTitle(indexPage)

        self.setFileTitle(title)

        if pageNum == None:

            print "URL已失效,请重试"

            return

        try:

            print "该帖子共有" + str(pageNum) + "页"

            for i in range(,int(pageNum)+):

                print "正在写入第" + str(i) + "页数据"

                page = self.getPage(i)

                contents = self.getContent(page)

                self.writeData(contents)

        except IOError,e:

            print "写入异常,原因" + e.message

        finally:

            print "写入任务完成"

print u"请输入帖子代号"

baseURL = 'http://tieba.baidu.com/p/' + str(raw_input(u'http://tieba.baidu.com/p/'))

seeLZ = raw_input("是否只获取楼主发言,是输入1,否输入0\n")

floorTag = raw_input("是否写入楼层信息,是输入1,否输入0\n")

bdtb = BDTB(baseURL,seeLZ,floorTag)

bdtb.start()
还不懂原理,再看
5.18
爬取贴吧内容的 一个类
#!/usr/bin/python

#coding:utf-

import urllib

import urllib2

import re

class bdtb:

    def __init__(self,baseurl,seelz):

        self.baseurl = baseurl

        self.seelz = '?see_lz='+str(seelz)

    def getPage(self,pagenum):

        try:

            url = self.baseurl + self.seelz + '&pn=' + str(pagenum)

            request = urllib2.Request(url)

            response = urllib2.urlopen(request)

            print response.read()

            return response

        except urllib2.URLError,e:

            if hasattr(e,"reason"):

                print u"连接百度贴吧失败,错误原因",e.reason

                return None

baseurl = 'http://tieba.baidu.com/p/3138733512'

bb = bdtb(baseurl,)

bb.getPage()
5.19
模拟登陆学校的信息门户
要用 ie 才能够看到成绩,但是看不到表单,就是 form data
这个时候再用回搜狗
#coding=utf-

import urllib

import urllib2

import cookielib

import re

class CHD:

    def __init__(self):

        self.loginUrl = 'http://bksjw.chd.edu.cn/loginAction.do'

        self.cookies = cookielib.CookieJar()

        self.postdata = urllib.urlencode({

            'dllx':dldl

            'zjh':xxxx

            'mm':xxxx

        })

        self.opener = urllib2.build_opener(urllib2.HTTPCookieProcessor(self.cookies))

    def getPage(self):

        request = urllib2.Request(

            url = self.loginUrl,

            data = self.postdata)

        result = self.opener.open(request)

        print result.read().decode('gbk')

    chd = CHD()

    chd.getPage()
...python の 学习的更多相关文章
- Python学习--04条件控制与循环结构
Python学习--04条件控制与循环结构 条件控制 在Python程序中,用if语句实现条件控制. 语法格式: if <条件判断1>: <执行1> elif <条件判断 ...
- Python学习--01入门
Python学习--01入门 Python是一种解释型.面向对象.动态数据类型的高级程序设计语言.和PHP一样,它是后端开发语言. 如果有C语言.PHP语言.JAVA语言等其中一种语言的基础,学习Py ...
- Python 学习小结
python 学习小结 python 简明教程 1.python 文件 #!/etc/bin/python #coding=utf-8 2.main()函数 if __name__ == '__mai ...
- Python学习路径及练手项目合集
Python学习路径及练手项目合集 https://zhuanlan.zhihu.com/p/23561159
- python学习笔记-python程序运行
小白初学python,写下自己的一些想法.大神请忽略. 安装python编辑器,并配置环境(见http://www.cnblogs.com/lynn-li/p/5885001.html中 python ...
- Python学习记录day6
title: Python学习记录day6 tags: python author: Chinge Yang date: 2016-12-03 --- Python学习记录day6 @(学习)[pyt ...
- Python学习记录day5
title: Python学习记录day5 tags: python author: Chinge Yang date: 2016-11-26 --- 1.多层装饰器 多层装饰器的原理是,装饰器装饰函 ...
- [Python] 学习资料汇总
Python是一种面向对象的解释性的计算机程序设计语言,也是一种功能强大且完善的通用型语言,已经有十多年的发展历史,成熟且稳定.Python 具有脚本语言中最丰富和强大的类库,足以支持绝大多数日常应用 ...
- Python学习之路【目录】
本系列博文包含 Python基础.前端开发.Web框架.缓存以及队列等,希望可以给正在学习编程的童鞋提供一点帮助!!! 目录: Python学习[第一篇]python简介 Python学习[第二篇]p ...
- python学习笔记系列----(八)python常用的标准库
终于学到了python手册的最后一部分:常用标准库.这部分内容主要就是介绍了一些基础的常用的基础库,可以大概了解下,在以后真正使用的时候也能想起来再拿出来用. 8.1 操作系统接口模块:OS OS模块 ...
随机推荐
- 汇编语言指令与debug命令符
•MOV与ADD指令 汇编指令 控制CPU完成的操作 形式化语法描述 mov ax, 18 将18送入AX (AX)=18 mov ah, 78 将78送入AH (AH)=78 add ax, 8 ...
- git各种撤销操作
撤销git add: git reset HEAD+路径 或者git reset --+路径 撤销commit: 1.回退到具体的嘻哈值 git reset --hard 2.回退后仍包含本地 ...
- javascript 键盘事件总结
原文:http://www.cnblogs.com/rubylouvre/archive/2009/08/20/1550526.html#2583814 在进入正题前,我们看一下浏览器对于键盘的一些默 ...
- D3.js 饼状图的制作
1.数据 有如下数据,需要可视化: var dataset = [ 30 , 10 , 43 , 55 , 13 ]; 这样的值是不能直接绘图的.例如绘制饼状图的一个部分,需要知道一段弧的起始角度和终 ...
- rsync同步完整配置
一.需求: 1.对于分公司访问一些服务器(如工程图纸服务器),如果通过Internet上的VPN访问总是觉得速度慢,毕竟带宽有限,为了解决此问题,可以两地建立同步镜像服务器,分公司可以访问本地的镜像服 ...
- 使用DBMS_STATS来收集统计信息【转】
overview Oracle's cost-based optimizer (COB) uses statistics to calculate the selectivity (the fract ...
- 项目中的五级地址联动效果(js)
我刚开始是的时候是是写了一个sql语句,但是写了5个函数,来联动地址的.后来请教了前段的师傅,用js来写了一个地址联动的. 我使用的是easyui的框架! 地址联动部分html代码! <tr&g ...
- http协议简述
HTTP协议 客户端连上web 服务器后,若想获得 web 服务器中的某个 web 资源,需遵守一定的通讯格式, HTTP 协议用于定义客户端与 web 服务器通迅的格式. WEB浏览器与 WEB 服 ...
- armp启动
1.启动apahcehttpd.exe -k starthttpd.exe -k restart 重启httpd.exe -k install 安装 2.php启动apache.conf文件添加:Lo ...
- Google V8扩展利器发布:v8-native-binding-generator
用C++扩展Google V8很简单,但是类比较多时还是很烦的.前段时间开发cantk-runtime-v8时,我写了一个代码产生器v8-native-binding-generator,让扩展Goo ...