
MySQL 性能优化细节
服务器层面优化(了解)
将数据保存在内存中,保证从内存读取数据
- 设置足够大的innodb_buffer_pool_size,将数据读取到内存中。
- 建议innodb_buffer_pool_size设置为总内存大小的3/4或者4/5。
- 怎样确定innodb_buffer_pool_size足够大,数据是从内存读取而不是硬盘?
show global status like 'innodb_buffer_pool_pages_%';
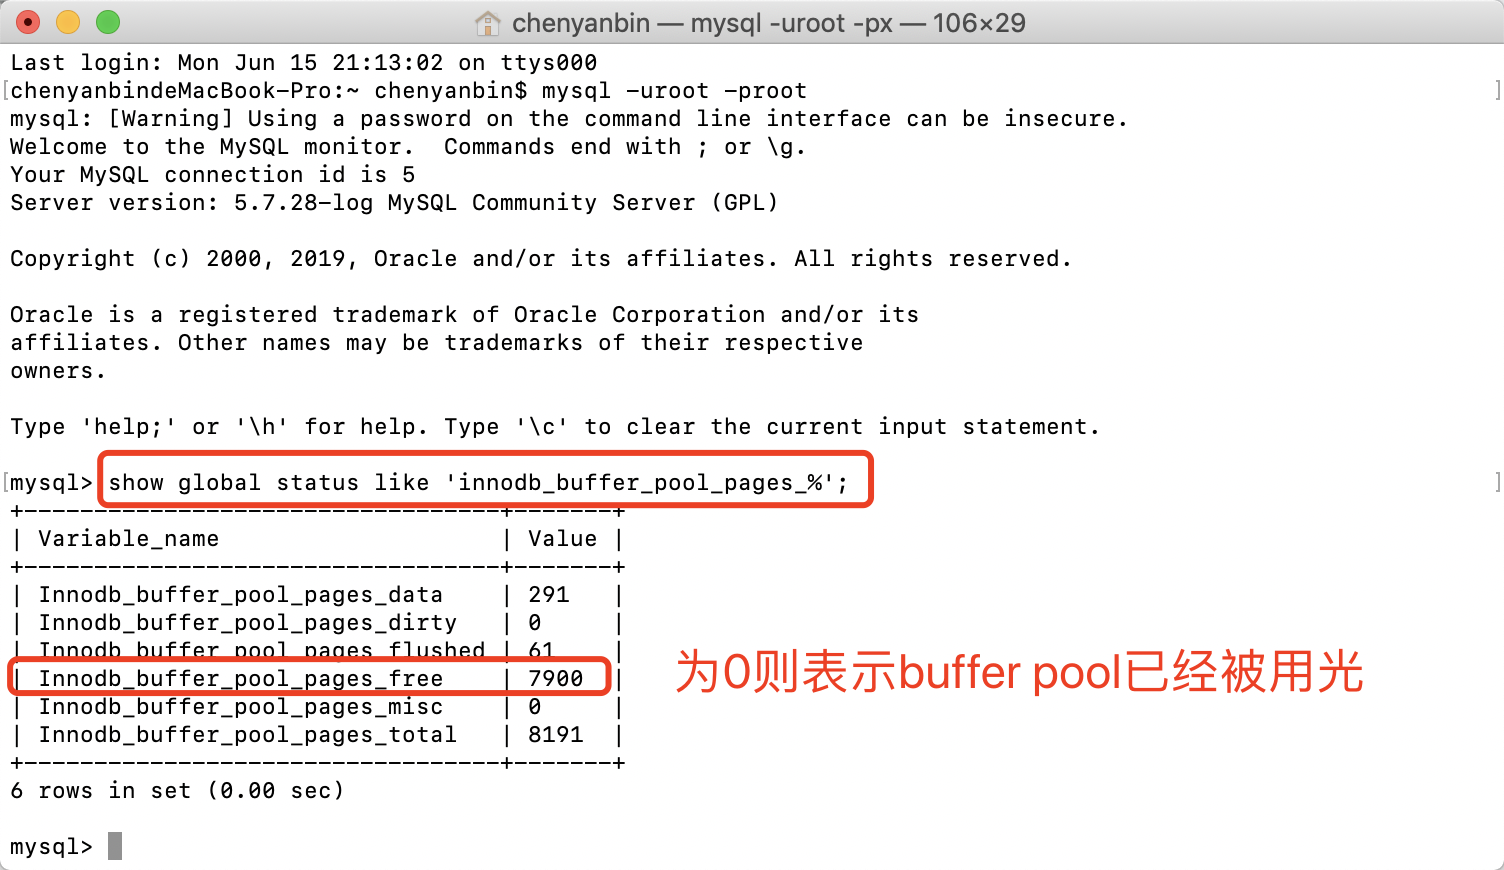
降低磁盘写入次数
- 使用足够大的写入缓存innodb_log_file_size
- 推荐innodb_log_file_size设置为0.25*innodb_buffer_pool_size
- 设置合适的innodb_flush_log_at_trx_commit
提高磁盘读写
可以考虑使用SSD硬盘,不过得考虑成本是否合适。
SQL设计优化(了解需求的人并懂技术的人)
- 设计中间表,一般针对统计分析功能,或者实时性不高的需求
- 为减少关联查询,创建合理的冗余字段
- 对于字段太多的大表,考虑拆表
- 对于表中经常不被使用的字段,考虑拆表
- 每张表都有一个主键,而且主键类型最好是int类型,建议自增主键
SQL语句优化(开发人员)
索引优化
- 为搜索字段创建索引(考虑:查询多还是增删多?)
- 尽量建立组合索引并注意组合索引的创建顺序,按照顺序组织查询条件,尽量将筛选粒度大的查询条件放到最左边
- SELECT 语句尽量不要使用*
- order by、group by语句尽量使用索引
LIMIT优化
- 如果预计SELECT 语句的查询结果是一条,最好使用LIMIT 1,可以停止全表扫描
- SELECT * FROM S_USER WHERE USERNAME='chenyanbin' LIMIT 1;
- 处理分页会使用到LIMIT,当翻页到非常靠后的页面的时候,偏移量会非常大,这时LIMIT的效率会非常差
LIMIT的优化问题,其实是OFFSET的问题,他会导致MySQL扫描大量不需要的行然后再抛弃掉。

解决方案:使用order by和索引覆盖

原sql:

SELECT user_name,age  FROM s_user LIMIT 10000,20;

优化后SQL:

SELECT user_name,age FROM s_user ORDER BY city LIMIT 20;
其他优化
- 尽量不使用count(*)、尽量使用count(主键)
- JOIN两张表的关联字段最好都建立索引,而且最好字段类型是一样的
- WHERE条件中尽量不要使用1=1、not in 语句(建议使用not exists)
- 不用MySQL内置的函数,因为内置函数不会建立查询缓存
- 合理利用慢查询日志、explain执行计划查询、show profile查询SQL执行的资源使用情况
MySQL 性能优化细节的更多相关文章
- MySQL性能优化的5个维度
面试官如果问你:你会从哪些维度进行MySQL性能优化?你会怎么回答? 所谓的性能优化,一般针对的是MySQL查询的优化.既然是优化查询,我们自然要先知道查询操作要经过哪些环节,然后思考可以在哪些环节进 ...
- Mysql - 性能优化之子查询
记得在做项目的时候, 听到过一句话, 尽量不要使用子查询, 那么这一篇就来看一下, 这句话是否是正确的. 那在这之前, 需要介绍一些概念性东西和mysql对语句的大致处理. 当Mysql Server ...
- Mysql性能优化三(分表、增量备份、还原)
接上篇Mysql性能优化二 对表进行水平划分 如果一个表的记录数太多了,比如上千万条,而且需要经常检索,那么我们就有必要化整为零了.如果我拆成100个表,那么每个表只有10万条记录.当然这需要数据在逻 ...
- [MySQL性能优化系列]提高缓存命中率
1. 背景 通常情况下,能用一条sql语句完成的查询,我们尽量不用多次查询完成.因为,查询次数越多,通信开销越大.但是,分多次查询,有可能提高缓存命中率.到底使用一个复合查询还是多个独立查询,需要根据 ...
- [MySQL性能优化系列]巧用索引
1. 普通青年的索引使用方式 假设我们有一个用户表 tb_user,内容如下: name age sex jack 22 男 rose 21 女 tom 20 男 ... ... ... 执行SQL语 ...
- MySQL性能优化:索引
MySQL性能优化:索引 索引提供指向存储在表的指定列中的数据值的指针,然后根据您指定的排序顺序对这些指针排序.数据库使用索引以找到特定值,然后顺指针找到包含该值的行.这样可以使对应于表的SQL语句执 ...
- mysql 性能优化方向
国内私募机构九鼎控股打造APP,来就送 20元现金领取地址:http://jdb.jiudingcapital.com/phone.html内部邀请码:C8E245J (不写邀请码,没有现金送)国内私 ...
- MySQL性能优化总结
一.MySQL的主要适用场景 1.Web网站系统 2.日志记录系统 3.数据仓库系统 4.嵌入式系统 二.MySQL架构图: 三.MySQL存储引擎概述 1)MyISAM存储引擎 MyISAM存储引擎 ...
- MYSQL性能优化的最佳20+条经验
MYSQL性能优化的最佳20+条经验 2009年11月27日 陈皓 评论 148 条评论 131,702 人阅读 今天,数据库的操作越来越成为整个应用的性能瓶颈了,这点对于Web应用尤其明显.关于数 ...
随机推荐
- 【Mac】anaconda自定义channels
1.查看channels conda config --show channels 输出 channels: - defaults 2.添加channels conda config --add ch ...
- SQL——AUTO INCREMENT(字段自增)
AUTO INCREMENT -- 在新记录插入表中时生成一个唯一的数字.插入表数据时,该字段不需规定值. 在每次插入新记录时,自动地创建主键字段的值.在表中创建一个 auto-incremen ...
- shiro简单的认证功能
使用静态shiro.ini文件完成认证 创建项目到爆 <dependency> <groupId>org.apache.shiro</groupId> <ar ...
- 虚拟机配置JAVA_HOME
1.cp home/fan-vm2/es/tools/jdk-8u111-linux-x64.tar.gz usr/java2.tar -zxvf jdk-8u111-linux-x64.tar.gz ...
- StringUtils、CollectionUtils工具类的常用方法
唯能极于情,故能极于剑 欢迎来到 “程序牛CodeCow” 的博客,有问题请及时关注小编公众号 “CodeCow”,大家一起学习交流 下面将为大家演示StringUtils.CollectionUti ...
- Golang源码学习:监控线程
监控线程是在runtime.main执行的时候在系统栈中创建的,监控线程与普通的工作线程区别在于,监控线程不需要绑定p来运行. 监控线程的创建与启动 简单的调用图 先给出个简单的调用图,好心里有数,逐 ...
- 百度地图结合ECharts实现复杂覆盖物(Overlay)
先来看效果图 一 前置知识 官方Overlay-覆盖物的抽象基类 方法 返回值 描述 initialize(map: Map) HTMLElement 抽象方法,用于初始化覆盖物,当调用map.add ...
- 初尝 Blazor WebAssembly
一. 前言 Blazor 的整体介绍以及特点与优势,建议翻阅 Blazor 介绍. Blazor 是一个可是使用 .NET/C# 来编写交互式客户端的 Web UI 框架,在官网有一句话概括 &quo ...
- 【图机器学习】cs224w Lecture 13 & 14 - 影响力最大化 & 爆发检测
目录 Influence Maximization Propagation Models Linear Threshold Model Independent Cascade Model Greedy ...
- Java实现 LeetCode 155 最小栈
155. 最小栈 设计一个支持 push,pop,top 操作,并能在常数时间内检索到最小元素的栈. push(x) – 将元素 x 推入栈中. pop() – 删除栈顶的元素. top() – 获取 ...