
[转载] ReLU和BN层简析
[转载] ReLU和BN层简析
来源:https://blog.csdn.net/huang_nansen/article/details/86619108
卷积神经网络中,若不采用非线性激活,会导致神经网络只能拟合线性可分的数据,因此通常会在卷积操作后,添加非线性激活单元,其中包括logistic-sigmoid、tanh-sigmoid、ReLU等。
sigmoid激活函数应用于深度神经网络中,存在一定的局限性,当数据落在左右饱和区间时,会导致导数接近0,在卷积神经网络反向传播中,每层都需要乘上激活函数的导数,由于导数太小,这样经过几次传播后,靠前的网络层中的权重很难得到很好的更新,这就是常见的梯度消失问题。这也是ReLU被使用于深度神经网络中的一个重要原因。
- Dead ReLU
若数据落在负区间中,ReLU的结果为0,导数也是0,就会导致反向传播无法将误差传递到这个神经元上,这会导致该神经元永远不会被激活,导致Dead ReLU问题。解决方法:
1)Leraning Rate
导致Dead ReLU问题的其中一个潜在因素为Learning Rate太大,假设在某次更新中,误差非常大,这时候若LR也很大,会导致权重参数更新后,神经元的数据变化剧烈,若该层中多数神经元的输出向负区间偏向很大,导致了大部分权重无法更新,会陷入Dead ReLU问题中。当然,小learning rate也是有可能会导致Dead ReLU问题的,于是出现了Leaky ReLU和PReLU。
2)Leaky ReLU
普通的ReLU为:
Leaky ReLU为:
其中取一个很小的数,作者的默认值为0.01,这样可以保证输出小于0的神经元也会进行很小幅度的更新。
3)PReLU
PReLU是Leaky ReLU的进一步优化版,公式表达为:其中是一个可以学习的参数,更新是反向传播使用的是momentum来更新,更新方式如下:
其中为动量,为学习率。文章中初始化为0.25,且不添加正则化,因为很有可能会很大可能被置0,变成ReLU。
- Batch Normalization
在SegNet网络简析的博文中,我提到过BN层的基本操作和作用。BN层的出现,主要是为了解决机器学习IID问题,即训练集和测试集保持独立同分布。如果输入的分布不能保持稳定,那么训练就会很难收敛,而在图像处理领域的白化处理,即将输入数据转换为以0为均值,1为方差的正态分布。这样能够让神经网络更快更好的收敛,而这就是BN层所要做的。
“深度神经网络之所以收敛慢,是由于输入的分布逐渐向非线性函数的两端靠拢”,而BN层的作用,就是将输入的分布,拉回到均值为0,方差为1的正态分布上,这样就使输入激活函数的值,在反向传播史能够产生更明显的梯度,更容易收敛,避免了梯度消失的问题。之所以能够在反向传播时产生更明显的变化,我们将输入分布变为标准正态分布后,输入的值靠近中心的概率会变大,若我们的激活函数为sigmoid函数,那么即使输入存在微小的变化,也能够在反向传播时产生很明显的变化。
每层神经网络在线性激活后,通过如下公式进行转换,这个转换就是BN层的操作。
公式中的x是经过该层线性变换后的值,即x = wu+b,u为上一层神经层的输出。
通过这个操作,将输入非线性激活函数的输入值,尽量拉伸到变化较大的区域,即激活函数中间区域。这样能够增大激活函数的导数值,使收敛更快速。而这样也会引入一个问题,强行变换分布后,会导致部分特征无法学习到,因此引入了另一种操作Scale,操作如下:
mean和variance是不会进行学习的,而gamma和beta两个参数是可以通过反向传播学习的,通过这两个参数对数据进行扩大和平移,恢复部分特征的分布。
BN层的主要功能总结为两点:
1)归一化scale
没有BN层时,若LR设置较大,在配合ReLU激活函数时,容易出现Dead ReLU问题。
2)数据初始化集中,缓解overfitting(这里还理解得不是很透彻)
Overfitting主要发生在一些较远的便捷点,BN操作可以使初始化数据在数据内部。
通常提到BN层,我们会想到,若使用sigmoid激活函数时,它可以将数据归一化到梯度较大的区域,便于梯度更新。
但很少有人提到BN层和ReLU的联系,https://blog.csdn.net/wfei101/article/details/79997708这篇转载文章中有提到。
在BN中的gamma对于ReLU的影响很小,因为数值的收缩,不会影响是否大于0。但是如果没有偏移量beta,就会出现数据分布在以0为中心的位置,强行将一半的神经元输出置零。因此偏移量beta是必不可少的。


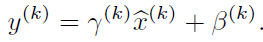
另外一篇文章中也提到了BN层的一个作用:
来源:https://blog.csdn.net/xys430381_1/article/details/85141702
首先来说归一化的问题,神经网络训练开始前,都要对数据做一个归一化处理,归一化有很多好处,原因是网络学习的过程的本质就是学习数据分布,一旦训练数据和测试数据的分布不同,那么网络的泛化能力就会大大降低,另外一方面,每一批次的数据分布如果不相同的话,那么网络就要在每次迭代的时候都去适应不同的分布,这样会大大降低网络的训练速度,这也就是为什么要对数据做一个归一化预处理的原因。另外对图片进行归一化处理还可以处理光照,对比度等影响。
网络一旦训练起来,参数就要发生更新,出了输入层的数据外,其它层的数据分布是一直发生变化的,因为在训练的时候,网络参数的变化就会导致后面输入数据的分布变化,比如第二层输入,是由输入数据和第一层参数得到的,而第一层的参数随着训练一直变化,势必会引起第二层输入分布的改变,把这种改变称之为:Internal Covariate Shift,BN就是为了解决这个问题的。

[转载] ReLU和BN层简析的更多相关文章
- [转载] Thrift原理简析(JAVA)
转载自http://shift-alt-ctrl.iteye.com/blog/1987416 Apache Thrift是一个跨语言的服务框架,本质上为RPC,同时具有序列化.发序列化机制:当我们开 ...
- 【转载】 Pytorch(1) pytorch中的BN层的注意事项
原文地址: https://blog.csdn.net/weixin_40100431/article/details/84349470 ------------------------------- ...
- 【转载】 Caffe BN+Scale层和Pytorch BN层的对比
原文地址: https://blog.csdn.net/elysion122/article/details/79628587 ------------------------------------ ...
- 【转载】 【caffe转向pytorch】caffe的BN层+scale层=pytorch的BN层
原文地址: https://blog.csdn.net/u011668104/article/details/81532592 ------------------------------------ ...
- Batch normalization简析
Batch normalization简析 What is batch normalization 资料来源:https://www.bilibili.com/video/av15997678/?p= ...
- 【HANA系列】SAP Vora(SAP HANA和Hadoop)简析
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[HANA系列]SAP Vora(SAP HAN ...
- SimpleDateFormat使用简析
title: SimpleDateFormat使用简析 date: 2016-07-11 11:48:20 tags: Java SimpleDateFormat --- [转载自博客:http:// ...
- 简析TCP的三次握手与四次分手【转】
转自 简析TCP的三次握手与四次分手 | 果冻想http://www.jellythink.com/archives/705 TCP是什么? 具体的关于TCP是什么,我不打算详细的说了:当你看到这篇文 ...
- PHP单一文件入口框架简析
<?php /** * PHP单一文件框架设计简析 * 1.MVC架构实现 * 2.URL路由原理 */ //URL路由原理 /** * 路由作用 * 获取url中的c和a变量,执行c类对应的方 ...
随机推荐
- VS2008 Qt Designer 中自定义信号槽
一.Qt Designer自定义槽函数 发现:在VS2008 +Qt4.7 中打开ui文件,所用的英文QT Designer工具,没有转到槽函数的功能,不如QtCreator自带的QtDesigne ...
- selenium 右侧滚动条操作
对于web上有右侧滚动条的操作 可用使用JS语句执行 拖到底部 js = "var q=document.documentElement.scrollTop=10000"brows ...
- 数据库 | SQL语法优化方法及实例详解
使用复合索引 如果经常执行如上查询,那么建立三个单独索引不如建立一个复合索引,因为三个单独索引通常数据库每次执行只能使用其中一个,虽然这样比不使用索引而进行全表扫描提高了很多效率,但使用复合索引因为索 ...
- lftp下载文件无法覆盖,提示" file already existst and xfer:clobber is unset" 问题解决
在 /etc/lftp.conf 文件中添加以下配置即可 set xfer:clobber on
- linux备忘和卸载
linux上网 -------------------------------------------------linux卸载------------------------------------ ...
- 九十七:CMS系统之模板抽离和个人信息页面
模板抽取,将公共的页面抽出来作为模板 {% from 'common/_macros.html' import static %}<!DOCTYPE html><html lang= ...
- Python异步IO之协程(二):使用asyncio的不同方法实现协程
引言:在上一章中我们介绍了从yield from的来源到async的使用,并在最后以asyncio.wait()方法实现协程,下面我们通过不同控制结构来实现协程,让我们一起来看看他们的不同作用吧- 在 ...
- android stdio 首次安装配置
http://www.cnblogs.com/smyhvae/p/4390905.html 不启用 加快模拟器调试 这个玩意儿打开老是报什么 android 1.0的问题 导致编译不起来 直接关了 S ...
- 从a-zA-Z0-9特殊字符中生成指定数量的随机字符密码的多层for循环跳出
师从‘百测’besttest 今日牛老师布置了一个作业,生成一个随机密码,且要包含大写字母.小写字母.数字和特殊字符,且不能重复. 想着先生成密码,然后用各字符去检查是否存在,使用for嵌套循环. i ...
- PJzhang:kali linux安装virtualbox虚拟机和chrome浏览器
猫宁!!! 参考链接: https://www.cnblogs.com/zhishuai/p/8007410.html kali linux 安装virtualbox. 查询系统的版本 apt-cac ...