
python解析库之 XPath
1. XPath (XML Path Language) XML路径语言
2. XPath 常用规则:
nodename 选取此节点的所有子节点
/ 从当前结点选取直接子节点
// 从当前结点选取子孙节点
. 选取当前结点
.. 选取当前结点的父节点
@ 选取属性
3. 实例
 from lxml import etree

 text = '''

 <div>

     <ul>

         <li class="item-0"><a href="link1.html">first item</a></li>

         <li class="item-1"><a href="link2.html">second item</a></li>

         <li class="item-inactive"><a href="link3.html">third item</a></li>

         <li class="item-1"><a href="link4.html">fourth item</a></li>

         <li class="item-0"><a href="link5.html">fifth item</a>

     </ul>

 </div>

 '''

 html = etree.HTML(text) # 初始化,构造XPath对象

 # 自动修正html代码,最后一个<li>没有闭合,tostring()方法补全html代码,返回结果是bytes类型

 result = etree.tostring(html)

 print(result.decode('utf-8'))
也可以读取文件来进行解析
 from lxml import etree

 html = etree.parse(r'C:\Users\Administrator\Desktop\test.txt', etree.HTMLParser())

 result = etree.tostring(html)

 print(result.decode('utf-8'))
4. 使用//开头的XPath规则来选取符合要求的节点
from lxml import etree

text = '''

<div>

    <ul>

        <li class="item-0"><a href="link1.html">first item</a></li>

        <li class="item-1"><a href="link2.html">second item</a></li>

        <li class="item-inactive"><a href="link3.html">爱我中华</a></li>

        <li class="item-1"><a href="link4.html">fourth item</a></li>

        <li class="item-0"><a href="link5.html">fifth item</a>

    </ul>

</div>

'''

'''匹配节点'''

html = etree.HTML(text)

result1 = html.xpath('//*')  # 使用*匹配所有节点

print(result1)

result2 = html.xpath('//li') # 获取所有的li节点

print(result2)

print(result2[0])

result3 = html.xpath('//li/a')  # 获取所有li节点的直接a子节点

print(result3)

# 首先选中href属性为link3.html的a节点,然后再获取其父亲节点,在获取其class属性的值

# result4 为['item-inactive'],这是个只有一个元素的列表

result4 = html.xpath('//a[@href="link3.html"]/../@class')

print(result4[0])

# 同时, 也可以通过parent::来获取父亲节点 如:

result5 = html.xpath('//a[@href="link3.html"]/parent::*/@class')

'''属性匹配  (选取节点时,可以用@符号进行属性过滤)'''

# 匹配属性class="item-inactive"的li节点

result6 = html.xpath('//li[@class="item-inactive"]')

print(result6)

'''文本获取 (使用XPath中的text()方法获取节点中的文本)'''

result7 = html.xpath('//li[@class="item-inactive"]/a[@href="link3.html"]/text()')

print(result7) #  打印出 ['爱我中华'] 列表

'''属性获取 使用@来获取属性'''

# 匹配属性href="link3.html"的a节点的父亲节点的class属性

result8 = html.xpath('//a[@href="link3.html"]/../@class')

print(result8) # 打印['item-inactive']

'''属性多值匹配'''

html_test = '''<li class="li item-inactive"><a href="link3.html">爱我中华</a></li>'''

# 这里li标签class属性有两个值, 如果按照上边的属性匹配 是匹配不到的,就要用到contains()函数

html_test = etree.HTML(html_test)

# 通过contains方法,第一个参数穿属性名,第二个传属性值中的任意一个,都可以匹配到

result9 = html_test.xpath('//li[contains(@class, "li")]/a/text()')

print(result9)

'''多属性匹配 (根据多个属性来确定一个节点)'''

html_test2 = '''<li class="li item-inactive" name="item"><a href="link3.html">Hello World</a></li>'''

# 这里li标签class属性有两个值, 如果按照上边的属性匹配 是匹配不到的,就要用到contains()函数

html_test = etree.HTML(html_test2)

# 通过contains方法,第一个参数穿属性名,第二个传属性值中的任意一个,都可以匹配到

result10 = html_test.xpath('//li[contains(@class, li) and @name="item"]/a[@href="link3.html"]/text()')

print(result10) # 打印['Hello World']
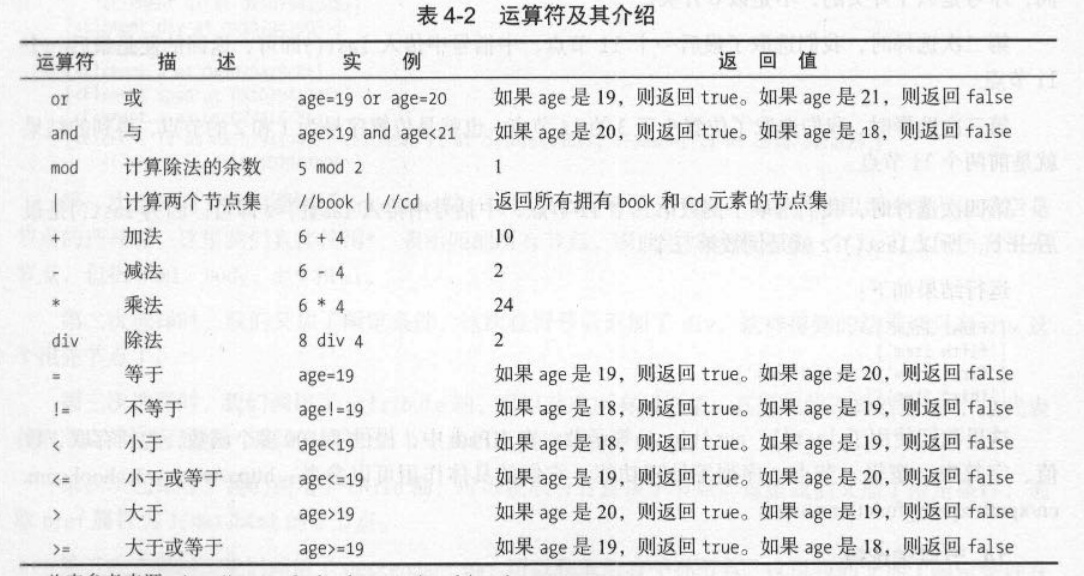
5. XPath 运算符
5. 按序选择 (同时匹配了多个节点时但又只想要其中一个节点时)
from lxml import etree

text = '''

<div>

    <ul>

        <li class="item-0"><a href="link1.html">first item</a></li>

        <li class="item-1"><a href="link2.html">second item</a></li>

        <li class="item-inactive"><a href="link3.html">爱我中华</a></li>

        <li class="item-1"><a href="link4.html">fourth item</a></li>

        <li class="item-0"><a href="link5.html">fifth item</a>

    </ul>

</div>

'''

'''匹配节点后按序选择'''

html = etree.HTML(text)

result1 = html.xpath('//li[1]/a/text()')  # 选取匹配到的li节点的第一个

print(result1)

result2 = html.xpath('//li[last()]/a/text()')  # 选取匹配到的li节点的最后一个

print(result2)

result3 = html.xpath('//li[position()<3]/a/text()')  # 选取匹配到的所有li节点中位置小于3,也就时第1,2个

print(result3)

result4 = html.xpath('//li[last()-2]/a/text()')  # 选取匹配到的li节点的倒数第三个

print(result4)

'''节点轴选择'''

html = etree.HTML(text)

result5 = html.xpath('//li[1]/ancestor::*')  # 选取匹配到的li节点的第一个的所有祖先节点

print(result5)

result6 = html.xpath('//li[1]/attribute::*')  # 选取匹配到的li节点的所有属性值

print(result6)

result7 = html.xpath('//li[1]/child::a')  # 选取匹配到的li节点的所有子节点

print(result7)

result8 = html.xpath('//li[1]/descendant::a')  # 选取匹配到的li节点的所有子孙节点

print(result8)

result9 = html.xpath('//li[1]/following::*')  # 选取获取到的当前结点后的所有节点

print(result9)

result10 = html.xpath('//li[1]/following-sibling::*')  # 选取获取到的当前结点之后的所有同级节点

print(result10)
python解析库之 XPath的更多相关文章
- python爬虫三大解析库之XPath解析库通俗易懂详讲
目录 使用XPath解析库 @(这里写自定义目录标题) 使用XPath解析库 1.简介 XPath(全称XML Path Languang),即XML路径语言,是一种在XML文档中查找信息的语言. ...
- 爬虫解析库:XPath
XPath XPath,全称 XML Path Language,即 XML 路径语言,它是一门在 XML 文档中查找信息的语言.最初是用来搜寻 XML 文档的,但同样适用于 HTML 文档的 ...
- python解析库
BeautifulSoup示例: #!/usr/bin/env python # -*- coding: utf-8 -*- # author: imcati html_doc = "&qu ...
- Python爬虫与数据分析之爬虫技能:urlib库、xpath选择器、正则表达式
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- xpath beautiful pyquery三种解析库
这两天看了一下python常用的三种解析库,写篇随笔,整理一下思路.太菜了,若有错误的地方,欢迎大家随时指正.......(conme on.......) 爬取网页数据一般会经过 获取信息-> ...
- Python3编写网络爬虫05-基本解析库XPath的使用
一.XPath 全称 XML Path Language 是一门在XML文档中 查找信息的语言 最初是用来搜寻XML文档的 但是它同样适用于HTML文档的搜索 XPath 的选择功能十分强大,它提供了 ...
- python爬虫的页面数据解析和提取/xpath/bs4/jsonpath/正则(1)
一.数据类型及解析方式 一般来讲对我们而言,需要抓取的是某个网站或者某个应用的内容,提取有用的价值.内容一般分为两部分,非结构化的数据 和 结构化的数据. 非结构化数据:先有数据,再有结构, 结构化数 ...
- (最全)Xpath、Beautiful Soup、Pyquery三种解析库解析html 功能概括
一.Xpath 解析 xpath:是一种在XMl.html文档中查找信息的语言,利用了lxml库对HTML解析获取数据. Xpath常用规则: nodename :选取此节点的所有子节点 // : ...
- python爬虫之html解析Beautifulsoup和Xpath
Beautiifulsoup Beautiful Soup 是一个HTML/XML的解析器,主要的功能也是如何解析和提取 HTML/XML 数据.BeautifulSoup 用来解析 HTML 比较简 ...
随机推荐
- Canada Cup 2016 C. Hidden Word 构造模拟题
http://codeforces.com/contest/725/problem/C Each English letter occurs at least once in s. 注意到题目有这样一 ...
- List和set集合:交集、差集、合集的区别retainAll,removeAll、addAll
set .list集合的交集(retainAll).差集(removeAll)是没有区别的都是一样的. set .list集合的合集addAll是有区别的:set可以去重复:list不去重复 publ ...
- JVM类加载机制二
类加载器与双亲委派模型 类加载器 类加载的操作不是有虚拟机完成的,而是由类加载器完成的,这样可以让程序定义决定加载哪个类. 类加载器的分类: 从虚拟机的角度有两种加载器,一种是启动类加载器Bootst ...
- 【转】pom.xml讲解
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/20 ...
- 1143 纪念品分组 2007年NOIP全国联赛普及组
1143 纪念品分组 2007年NOIP全国联赛普及组 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 白银 Silver 题解 查看运行结果 题目描述 Descri ...
- LNK1123: 转换到 COFF 期间失败: 文件无效或损坏 .NET 4.5 installed Visual Studio 2012 Release Preview
Error 'LINK : fatal error LNK1123: failure during conversion to COFF: file invalid or corrupt' after ...
- [PCL]对‘pcl::visualization::CloudViewer::CloudViewer(std::string const&)’未定义的引用
pcl::visualization::CloudViewer viewer("Cloud Viewer"); 这个时候报错. 试了很多方法,有人说,targe t_link 时候 ...
- Linux环境下mysql的root密码忘记解决方法(2种)
方法一: 1.首先确认服务器出于安全的状态,也就是没有人能够任意地连接MySQL数据库. 因为在重新设置MySQL的root密码的期间,MySQL数据库完全出于没有密码保护的 状态下,其他的用户也可以 ...
- WinForm 公共控件和属性
Button 按钮 布局 AutoSize 内容超出部分是否扩展到适应尺寸大小 Location 位置坐标 Size 控件大小 行为 Enabled 控件是否启用 visible 控件 ...
- Nginx+Keepalived负载均衡+后端LNMP网站集群
Centos6.4 x86,4台,地址是10.10.10.11-14,vip给的100,目标是在13和14安装nginx+keepalived,11和12安装nginx+mysql+php,做为web ...