
Python scrapy框架爬取瓜子二手车信息数据
项目实施依赖:
python,scrapy ,fiddler
scrapy安装依赖的包:
可以到https://www.lfd.uci.edu/~gohlke/pythonlibs/ 下载 pywin32,lxml,Twisted,scrapy然后pip安装
项目实施开始:
1、创建scrapy项目:cmd中cd到需创建的文件目录下
scrapy startproject guazi
2、创建爬虫:cd到创建好的项目下
scrapy genspider gz guazi.com
3、分析目标网址:
第一次我直接用的谷歌浏览器的抓包分析,取得UA和Cookies请求,返回的html数据完全缺失,分析可能是携带的Cookies
有问题,然后就用fiddler抓包才,得到Cookies与谷歌上得到Cookies多了UA,时间等参数,
4、将UA,Cookies添加到下载中间中去:
 class Guzi1DownloaderMiddleware(object):

     def process_request(self, request, spider):

             # 需要对得到的cookies处理成字典类型

         request.cookies={}

         request.headers["User-Agent"]=""
5、在settings中将DOWNLOADER_MIDDLEWARES打开
6、在spiders目录下找到gz.py开始编写爬虫逻辑处理
 import scrapy

 import time

 class GzSpider(scrapy.Spider):

     name = 'gz'

     allowed_domains = ['guazi.com']

     start_urls = ['https://www.guazi.com/cd/buy/0']

     def parse(self, response):

         # 得到页面上所有车辆的url

         url_list = response.xpath('//ul[@class="carlist clearfix js-top"]//li/a/@href').extract()

         url_list = [response.urljoin(url) for url in url_list]

         url_list = [url.replace("cq", "cd") for url in url_list]

         for url in url_list:

             yield scrapy.Request(url=url, callback=self.parse1, dont_filter=True)

         # 获取下一页的url

         next_url = response.urljoin(response.xpath('//span[text()="下一页"]/../@href').extract_first())

         if next_url:

             yield scrapy.Request(url=next_url, callback=self.parse, dont_filter=True)

         time.sleep(2)

     def parse1(self, response):

         # 判断是否有数据

         if response.xpath('//h2/text()').extract_first():

             print(response.xpath('//h2/text()').extract_first().strip())

             item = {}

             item["车型"] = response.xpath('//h2/text()').extract_first().strip()

             item["选车类型"] = response.xpath('//h2/span/text()').extract_first()

             item["价格/万"] = response.xpath('//div[@class="pricebox js-disprice"]/span[1]/text()').extract_first().strip()

             item["新车价格"] = response.xpath('//div[@class="pricebox js-disprice"]/span[2]/text()').extract_first().strip()

             item["上牌时间"] = response.xpath('//ul[@class="basic-eleven clearfix"]/li[1]/div/text()').extract_first().strip()

             item["公里数"] = response.xpath('//ul[@class="basic-eleven clearfix"]/li[2]/div/text()').extract_first().strip()

             item["排量"] = response.xpath('//ul[@class="basic-eleven clearfix"]/li[3]/div/text()').extract_first().strip()

             item["变速箱"] = response.xpath('//ul[@class="basic-eleven clearfix"]/li[4]/div/text()').extract_first().strip()

             item["配置信息"] = response.xpath('//span[@class="type-gray"]//text()').extract()

             item["网址"] = response.url

             yield item
7、启动爬虫并保存为csv文件
scrapy crawl gz -o guanzi.csv
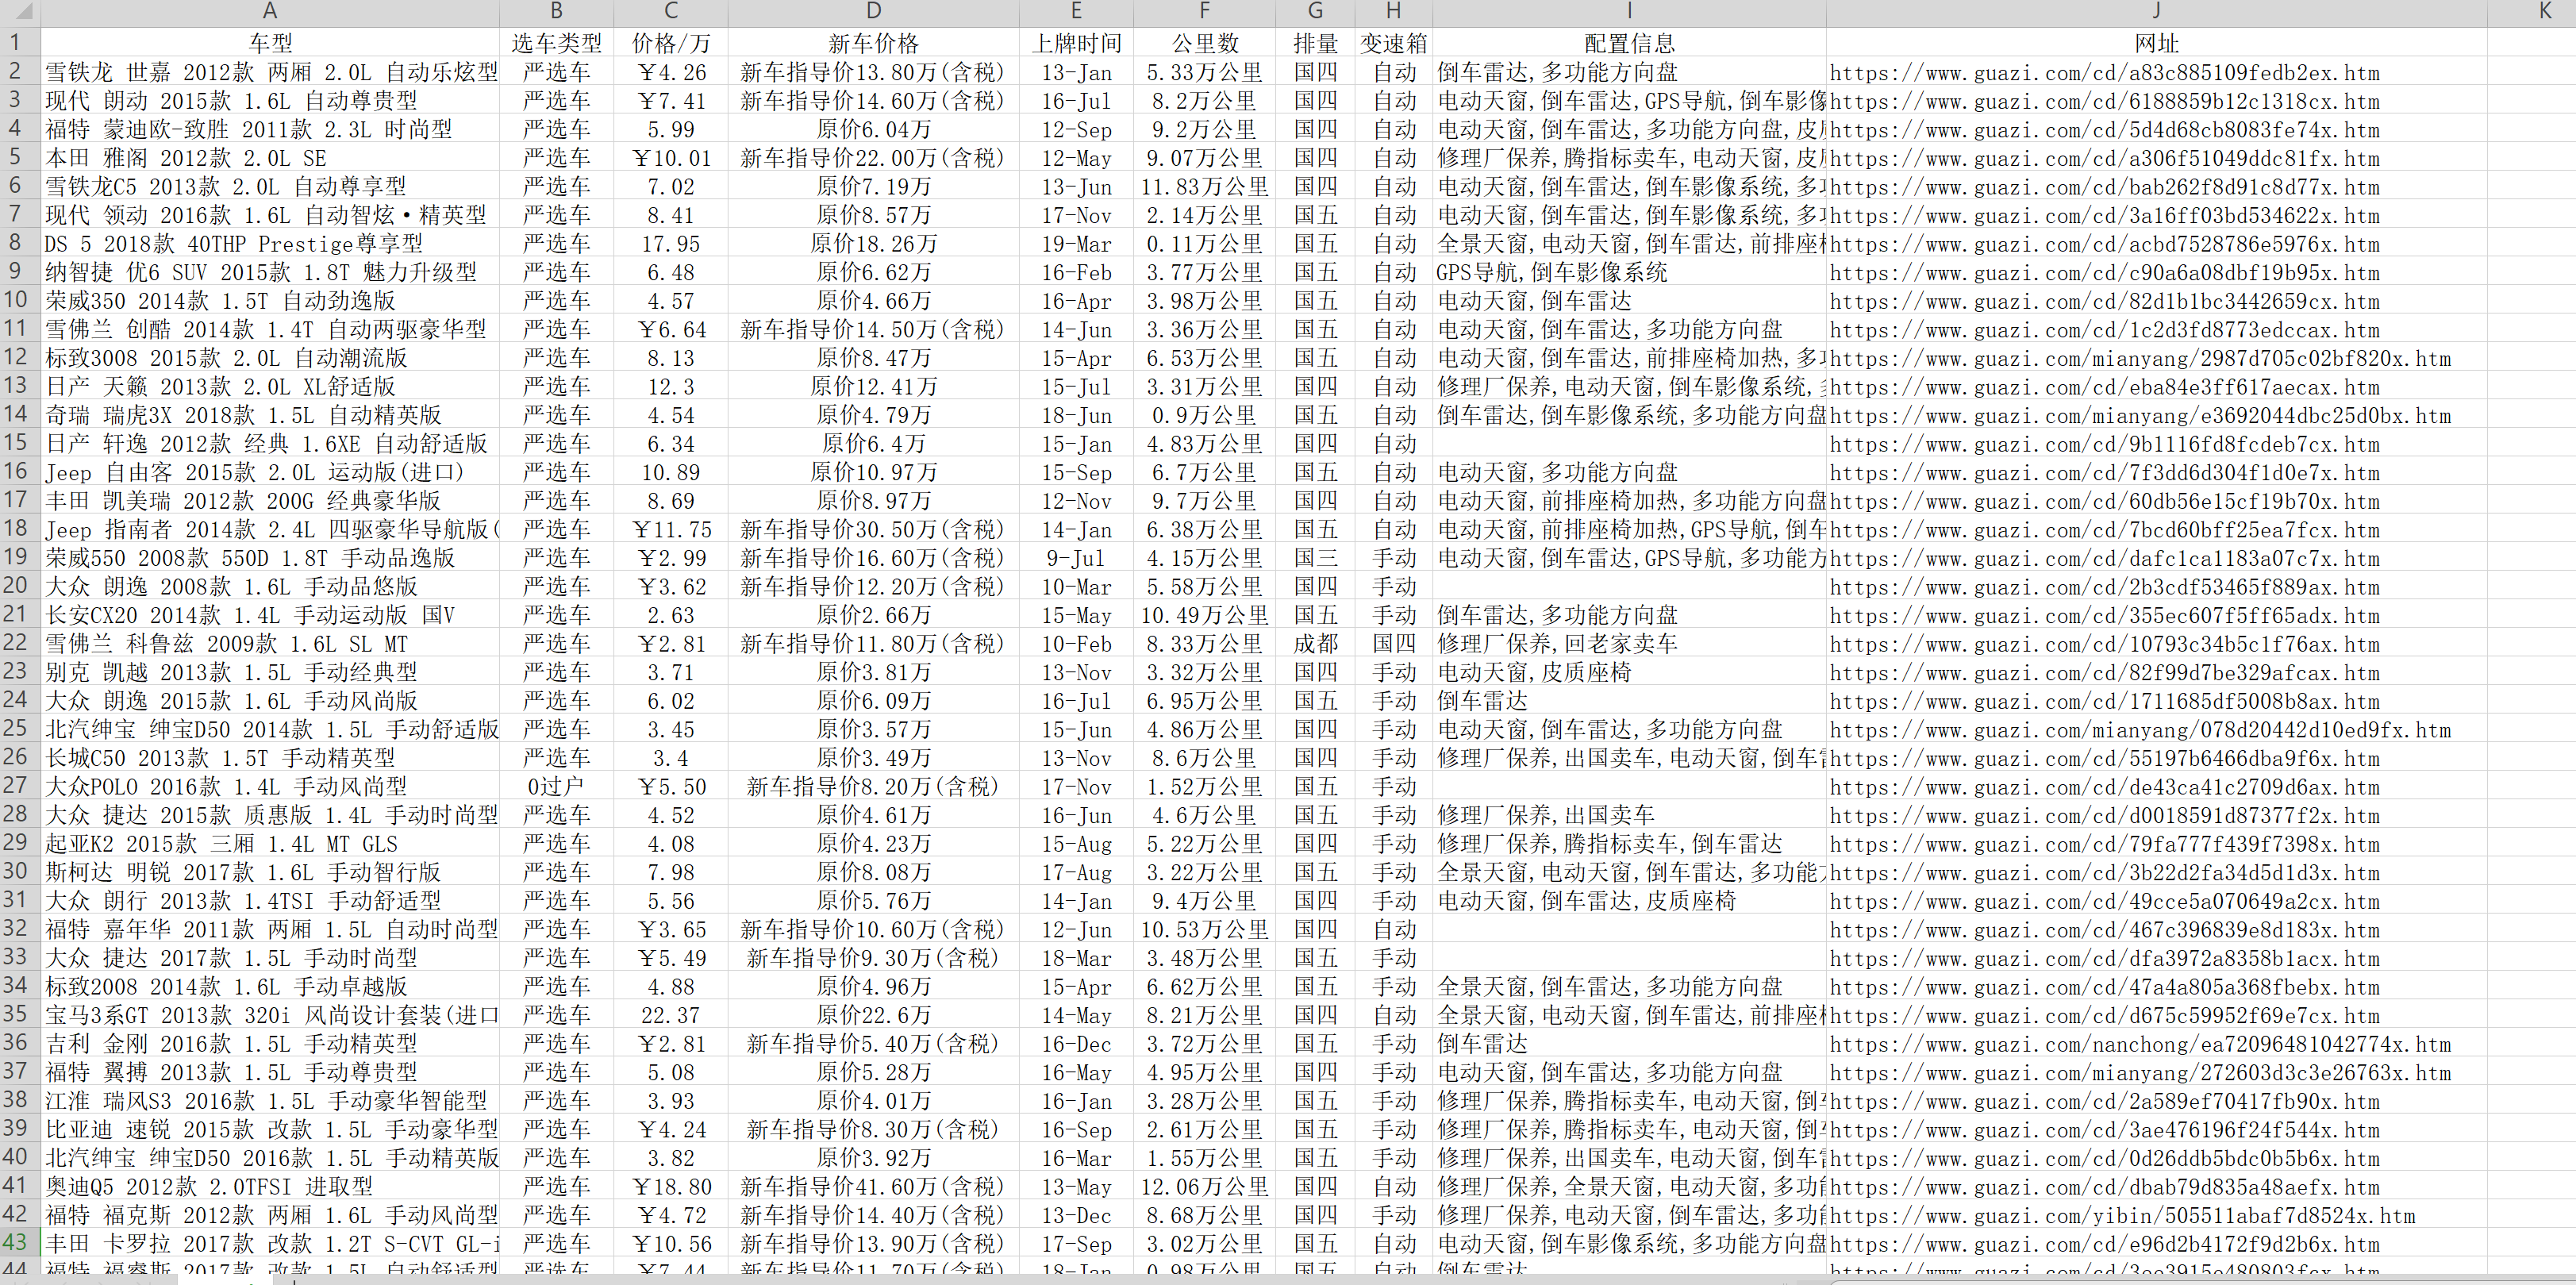
8、最后得到了想要的二手车信息,贴上部分截图
Python scrapy框架爬取瓜子二手车信息数据的更多相关文章
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- python scrapy框架爬取豆瓣
刚刚学了一下,还不是很明白.随手记录. 在piplines.py文件中 将爬到的数据 放到json中 class DoubanmoviePipelin2json(object):#打开文件 open_ ...
- Python——爬取瓜子二手车
# coding:utf8 # author:Jery # datetime:2019/5/1 5:16 # software:PyCharm # function:爬取瓜子二手车 import re ...
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- scrapy框架爬取小说信息
1.爬取目标网站:http://www.zhaoxiaoshuo.com/all.php?c=0&o=0&s=0&f=2&l=0&page=1 2.爬取目标网站 ...
- [Python学习] 简单爬取CSDN下载资源信息
这是一篇Python爬取CSDN下载资源信息的样例,主要是通过urllib2获取CSDN某个人全部资源的资源URL.资源名称.下载次数.分数等信息.写这篇文章的原因是我想获取自己的资源全部的评论信息. ...
- python之简单爬取一个网站信息
requests库是一个简介且简单的处理HTTP请求的第三方库 get()是获取网页最常用的方式,其基本使用方式如下 使用requests库获取HTML页面并将其转换成字符串后,需要进一步解析HTML ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
随机推荐
- java之选择排序
//选择排序(Select Sorting)也是一种简单的排序方法.它的基本思想是:第一次从R[0]-R[n-1]中选取最小值,与R[0]交换,第二次从R[1]-R[n-1]中选取最小值,与R[1] ...
- HTTP Status 405
分析原因: 1.doPost()和getPost()两个方法继承了父类,造成出错.
- Linux就该这么学--命令集合4(文件目录管理命令)
1.touch命令用于创建空白文件与修改文件时间:(touch [选项] [文件]) 对于在Linux中的文件有三种时间: 更改时间(mtime):内容修改时间(不包括权限的) 更改权限(ctime) ...
- Struts2中的redirect参数传递
在Action之间传递参数有如下方法: (方法一): Xml代码 1. <result name="topic" type="redirect">f ...
- Hadoop安全
kerberos-hadoop配置常见问题汇总 注意事项 常见问题如下(其中前面两点最多): 各目录属主组属性修改. 对于hadoop,需要改为yarn:hadoop/mapred:hdoop/hdf ...
- linux mount的安装配置
1.首先需要安装nfs-utils 和 portmap: yum install nfs-utils portmap (安装软件,也可直接安装 yum install nfs* portmap)chk ...
- hdu 1711 Number Sequence(kmp找子串第一次出现的位置)
题意:裸kmp 思路:kmp模板 #include<iostream> #include<stdio.h> #include<string.h> using nam ...
- css父元素背景覆盖其子元素背景
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- 树堆(Treap)
平衡树 简介: 平衡二叉树(Balanced Binary Tree)具有以下性质:它是一 棵空树或它的左右两个子树的高度差的绝对值不超过1,并且左右两个子树都是一棵平衡二叉树.平衡二叉树的常用实现方 ...
- 在WinDBG中查看调用栈的命令
命令 ========== k k命令显示的是一定数量的栈帧, 其中帧的数量是由.kframes命令来控制的, 默认值是256. kp 5 显示调用栈中前5个函数以及他们的参数. kb 5 显示调用栈 ...