
python网络爬虫之使用scrapy自动登录网站
前面曾经介绍过requests实现自动登录的方法。这里介绍下使用scrapy如何实现自动登录。还是以csdn网站为例。
Scrapy使用FormRequest来登录并递交数据给服务器。只是带有额外的formdata参数用来传送登录的表单信息(用户名和密码),为了使用这个类,需要使用以下语句导入:from scrapy.http import FormRequest
那么关于登录过程中使用cookie值,scrapy会自动为我们处理cookie,只要我们登录成功了,它就会像一个浏览器一样自动传送cookie
首先爬虫中定义start_requests
def start_requests(self):

    return [Request("http://passport.csdn.net/account/login",meta={'cookiejar':1},callback=self.post_login,method="POST")]
其中采用Requests的方法首先访问登录网站。meta属性是字典,字典格式即{‘key’:'value'},字典是一种可变容器模型,可存储任意类型对象。
request中meta参数的作用是传递信息给下一个函数,这些信息可以是任意类型的,比如值、字符串、列表、字典......方法是把要传递的信息赋值给meta字典的键. 上面start_requests中键‘cookiejar’是一个特殊的键,scrapy在meta中见到此键后,会自动将cookie传递到要callback的函数中。既然是键(key),就需要有值(value)与之对应,例子中给了数字1,也可以是其他值,比如任意一个字符串。
Callback就是连接到了登录网站后下一步需要调的函数。下面来看下post_login如何实现
def post_login(self,response):
    html=BeautifulSoup(response.text,"html.parser")
    for input in html.find_all('input'):
        if 'name' in input.attrs and input.attrs['name'] == 'lt':
            lt=input.attrs['value']
        if 'name' in input.attrs and input.attrs['name'] == 'execution':
            e1=input.attrs['value']
    data={'username':'xxxx','password':'xxxxx','lt':lt,'execution':e1,'_eventId':'submit'}
    return [FormRequest.from_response(response,
                                      meta={'cookiejar':response.meta['cookiejar']},
                                      headers=self.header,
                                      formdata=data,
                                      callback=self.after_login,)]
首先是获取lt,execution字段的值,具体在之前介绍requests的帖子中有解释。
然后调用FormRequest.from_response。 这个方法的作用是从response中返回的网页中构造表单数据,因此第一个参数是response。这里response返回的网页也就是前面Requests中调用的http://passport.csdn.net/account/login
接下来的参数是meta。Heasers,formadata以及callback。这里的callback有就是指向登录后的函数。
after_login的实现如下。
def after_login(self,response):
    print 'after login'
    print response.status
    header={'User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.80 Safari/537.36'}
    return [Request("http://my.csdn.net/my/mycsdn",meta={'cookiejar':response.meta['cookiejar']},headers=header,callback=self.parse)]
def parse(self, response):
    print response.text.decode('utf-8').encode(self.type)
运行后我们来看下记录的log。从下面的红色标红部分可以看到。在向http://passport.csdn.net/account/login发起登录请求后,scrapy紧接着
向http://passport.csdn.net/account/login;jsessionid=8B4A62EA09BBB5F1FBF4D921B64FECE6.tomcat2 发起建立请求。这也就是调用FormRequest.from_response触发的。在这里后面连接的jsessionid值也就是之前在访问登录网站的时候获取的会话ID,在这里scrapy自动给添加上了
2017-10-16 22:17:34 [scrapy] INFO: Spider opened

2017-10-16 22:17:34 [scrapy] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min)

2017-10-16 22:17:34 [scrapy] DEBUG: Telnet console listening on 127.0.0.1:6023

2017-10-16 22:17:34 [scrapy] DEBUG: Crawled (404) <GET http://passport.csdn.net/robots.txt> (referer: None)

2017-10-16 22:17:34 [scrapy] DEBUG: Crawled (200) <POST http://passport.csdn.net/account/login> (referer: None)

2017-10-16 22:17:34 [scrapy] DEBUG: Crawled (200) <POST http://passport.csdn.net/account/login;jsessionid=8B4A62EA09BBB5F1FBF4D921B64FECE6.tomcat2> (referer: http://www.csdn.net/)

2017-10-16 22:17:35 [scrapy] DEBUG: Crawled (200) <GET http://my.csdn.net/robots.txt> (referer: None)

2017-10-16 22:17:35 [scrapy] DEBUG: Crawled (200) <GET http://my.csdn.net/my/mycsdn> (referer: http://passport.csdn.net/account/login;jsessionid=8B4A62EA09BBB5F1FBF4D921B64FECE6.tomcat2)

2017-10-16 22:17:35 [scrapy] INFO: Closing spider (finished)

2017-10-16 22:17:35 [scrapy] INFO: Dumping Scrapy stats:

{'downloader/request_bytes': 2022,
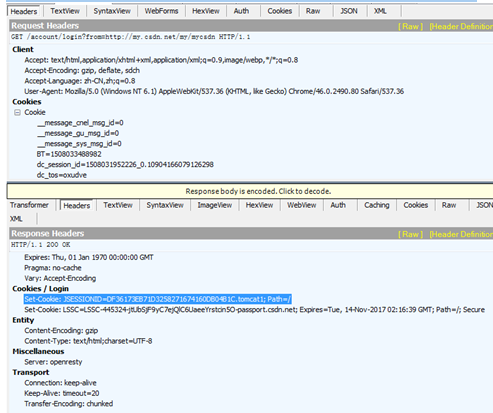
从fiddler中抓取的数据可以看到jsessionid是在访问登录网站后,网站返回的response 消息的header消息中。也就是网站设置的cookie值
完整的代码:
# -*- coding:UTF-8 -*- #
from scrapy.spiders import Spider,CrawlSpider,Rule
from scrapy.selector import Selector
from scrapy.http import Request
from scrapy import FormRequest

from test2.items import Test2Item
from scrapy.utils.response import open_in_browser
from scrapy.linkextractors import LinkExtractor
from bs4 import BeautifulSoup
import sys

class testSpider(Spider):
    name="test2"
    allowd_domains=['http://www.csdn.net/']
    header={'host':'passport.csdn.net','User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.80 Safari/537.36','Referer':'http://www.csdn.net/'}
    start_urls=["http://www.csdn.net/"]
    reload(sys)
    sys.setdefaultencoding('utf-8')
    type = sys.getfilesystemencoding()
    def start_requests(self):

        return [Request("http://passport.csdn.net/account/login",meta={'cookiejar':1},callback=self.post_login,method="POST")]

    def post_login(self,response):
        html=BeautifulSoup(response.text,"html.parser")
        for input in html.find_all('input'):
            if 'name' in input.attrs and input.attrs['name'] == 'lt':
                lt=input.attrs['value']
            if 'name' in input.attrs and input.attrs['name'] == 'execution':
                e1=input.attrs['value']
        data={'username':'xxxx','password':'xxxxx','lt':lt,'execution':e1,'_eventId':'submit'}
        return [FormRequest.from_response(response,
                                          meta={'cookiejar':response.meta['cookiejar']},
                                          headers=self.header,
                                          formdata=data,
                                          callback=self.after_login,)]
    def after_login(self,response):
        print 'after login'
        print response.status
        header={'User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.80 Safari/537.36'}
        return [Request("http://my.csdn.net/my/mycsdn",meta={'cookiejar':response.meta['cookiejar']},headers=header,callback=self.parse)]
    def parse(self, response):
        print response.text.decode('utf-8').encode(self.type)
python网络爬虫之使用scrapy自动登录网站的更多相关文章
- python网络爬虫之使用scrapy自动爬取多个网页
前面介绍的scrapy爬虫只能爬取单个网页.如果我们想爬取多个网页.比如网上的小说该如何如何操作呢.比如下面的这样的结构.是小说的第一篇.可以点击返回目录还是下一页 对应的网页代码: 我们再看进入后面 ...
- 【python 网络爬虫】之scrapy系列
网络爬虫之scripy系列 [scrapy网络爬虫]之0 爬虫与反扒 [scrapy网络爬虫]之一 scrapy框架简介和基础应用 [scrapy网络爬虫]之二 持久化操作 [scrapy网络爬虫]之 ...
- Python 网络爬虫 002 (入门) 爬取一个网站之前,要了解的知识
网站站点的背景调研 1. 检查 robots.txt 网站都会定义robots.txt 文件,这个文件就是给 网络爬虫 来了解爬取该网站时存在哪些限制.当然了,这个限制仅仅只是一个建议,你可以遵守,也 ...
- python网络爬虫之使用scrapy下载文件
前面介绍了ImagesPipeline用于下载图片,Scrapy还提供了FilesPipeline用与文件下载.和之前的ImagesPipeline一样,FilesPipeline使用时只需要通过it ...
- python网络爬虫之使用scrapy爬取图片
在前面的章节中都介绍了scrapy如何爬取网页数据,今天介绍下如何爬取图片. 下载图片需要用到ImagesPipeline这个类,首先介绍下工作流程: 1 首先需要在一个爬虫中,获取到图片的url并存 ...
- PYTHON网络爬虫与信息提取[scrapy框架应用](单元十、十一)
scrapy 常用命令 startproject 创建一个新的工程 scrapy startproject <name>[dir] genspider 创建一个爬虫 ...
- 【python网络爬虫】之requests相关模块
python网络爬虫的学习第一步 [python网络爬虫]之0 爬虫与反扒 [python网络爬虫]之一 简单介绍 [python网络爬虫]之二 python uillib库 [python网络爬虫] ...
- 《实战Python网络爬虫》- 感想
端午节假期过了,之前一直在做出行准备,后面旅游完又休息了一下,最近才恢复状态. 端午假期最后一天收到一个快递,回去打开,发现是微信抽奖中的一本书,黄永祥的<实战Python网络爬虫>. 去 ...
- 第三百四十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—cookie禁用、自动限速、自定义spider的settings,对抗反爬机制
第三百四十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—cookie禁用.自动限速.自定义spider的settings,对抗反爬机制 cookie禁用 就是在Scrapy的配置文件set ...
随机推荐
- API网关服务Zuul-Spring Cloud学习第五天(非原创)
文章大纲 一.Zuul是什么二.Zuul的基本实现三.路由配置细节四.异常处理细节五.项目源码与参考资料下载六.参考文章 一.Zuul是什么 到目前为止,我们Spring Cloud中的内容已 ...
- js 拦截全局 ajax 请求
你是否有过下面的需求:需要给所有ajax请求添加统一签名.需要统计某个接口被请求的次数.需要限制http请求的方法必须为get或post.需要分析别人网络协议等等,那么如何做?想想,如果能够拦截所有a ...
- tiny4412 解决内核编译版本号问题
内核版本: linux-3.5开发板: tiny4412作者:彭东林邮箱:pengdonglin137@163.com 问题: 由于我使用 git 管理内核代码,导致编译完成后内核版本变成了如下形式: ...
- 人工神经网络--ANN
神经网络是一门重要的机器学习技术.它是目前最为火热的研究方向--深度学习的基础.学习神经网络不仅可以让你掌握一门强大的机器学习方法,同时也可以更好地帮助你理解深度学习技术. 本文以一种简单的,循序的方 ...
- Geographical distance
Introduction Calculating the distance between geographical coordinates is based on some level of abs ...
- swfit各种Function表现形式
//: Playground - noun: a place where people can play import UIKit //多返回值函数 func countss(string: Stri ...
- java查看工具jhat-windows
Analyzes the Java heap. This command is experimental and unsupported. Synopsis jhat [ options ] heap ...
- AspectJ学习笔记2-Eclipse中AspectJ插件AJDT的正确安装方法
接着之前一篇日志. 这个事情也挺无语的.简单记录一下. 在这里:http://www.eclipse.org/ajdt/ 能够下载最新的Eclipse Plugin.下载解压之后,一般来说.直接把解压 ...
- Hibernate demo之使用注解
1.新建maven项目 testHibernate,pom.xml <?xml version="1.0" encoding="UTF-8"?> & ...
- Centos 7.0系统服务管理
从Centos7开始,不再用sysvinit管理系统服务了,而是改用了systemd,因此对系统服务管理方法已经变更,以下简述 1.查看当前所有系统服务的状态 systemctl 2.查看指定系统服务 ...