
论文笔记 - An Explanation of In-context Learning as Implicit Bayesian Inference
这位更是重量级。这篇论文对于概率论学的一塌糊涂的我简直是灾难。
由于 prompt 的分布与预训练的分布不匹配(预训练的语料是自然语言,而 prompt 是由人为挑选的几个样本拼接而成,是不自然的自然语言),作者设预训练的分布为 $p$ 而 prompt 的分布设为 $p_{prompt}$,因此作者认为这两种分布的不符可能是造成 inference 效果不佳的重要原因($S_n$ 为 context):
$$argmax_{y}\;p(y|S_n,\;x_{test})\;\neq argmax_{y}\;p_{prompt}(y|x_{test})$$
但是这种不匹配造成可以通过设置更好的 prompt 减弱,进而提出了 $singal$ 的概念,$singal$ 可以认为是一种任务的明确程度,$singal$ 越大代表任务越明确,得到的结果也准确,例如:一般情况下,One-shot 的效果要比 Few-shot 和 Zero-shot 都要差,例如下面的prompt :
> Albert Einstein was a German. Marie Curie was <token to infer>
这个 context 根本没有明确任务是什么!按照 prompt 的分布这里应该生成的是 Polish,但是按照预训练的分布这里完全可以填 brilliant 什么的,也就是两种分布不匹配的程度被大大放大了。但是如果换成 Few-shot 呢:
> Albert Einstein was German. Mahatma Gandhi was Indian. Karl Heinrich Marx was German. Marie Curie was <token to infer>
这个 context 就很好的描述了任务的目的:判断这些人所属的国家。因此,作为 context 的样本数量增加可以有效增加 $singal$,缩小两种分布的不匹配程度,进而改善效果。
作者进一步总结了几个对 $singal$ 有影响的因素
样本数量
如上文所述,样本越多任务描述越清晰,$singal$ 越大。
输入空间
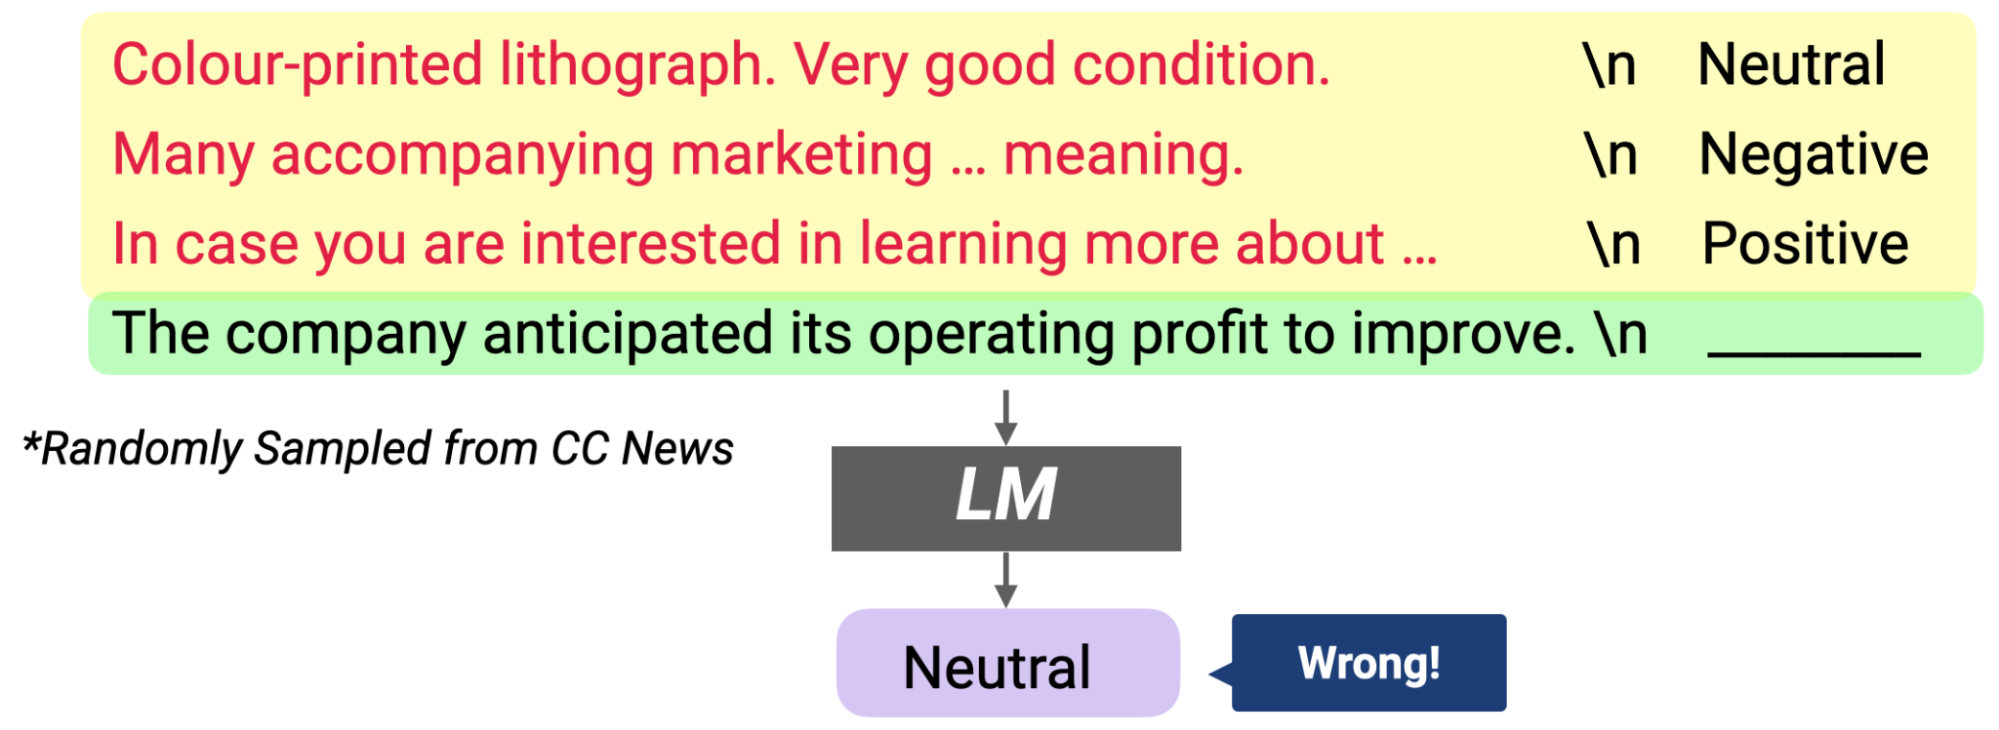
x 随便选的话会使准确率大幅度降低。
输出空间
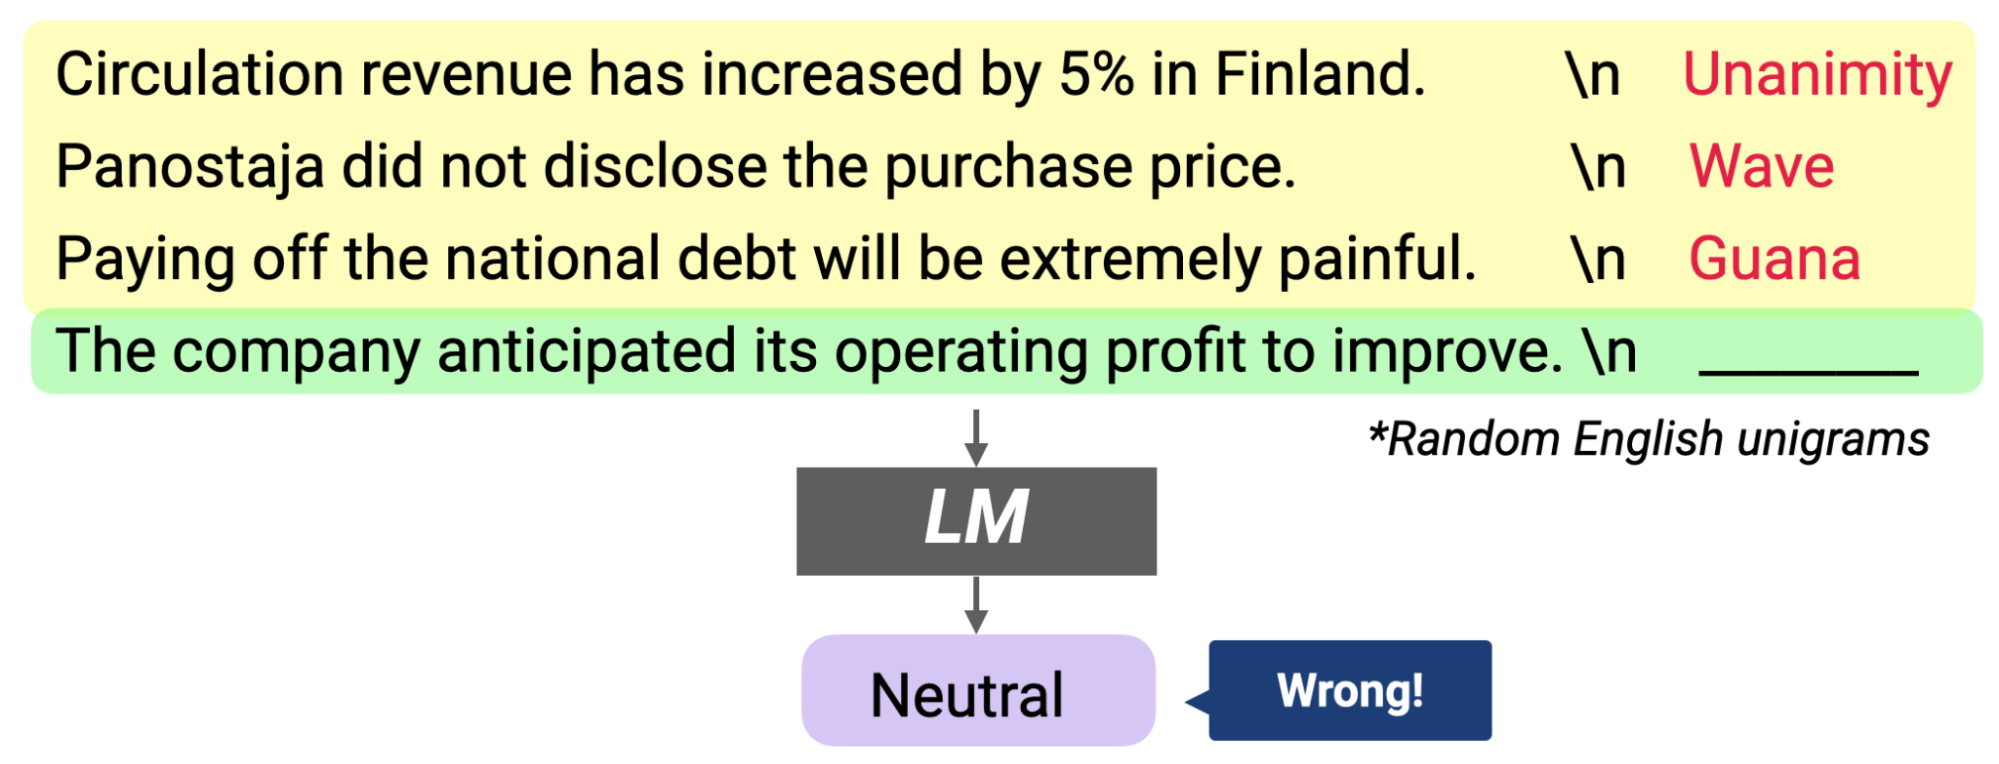
y 随便选的话也会使准确率大幅度降低。
输入输出的对应关系
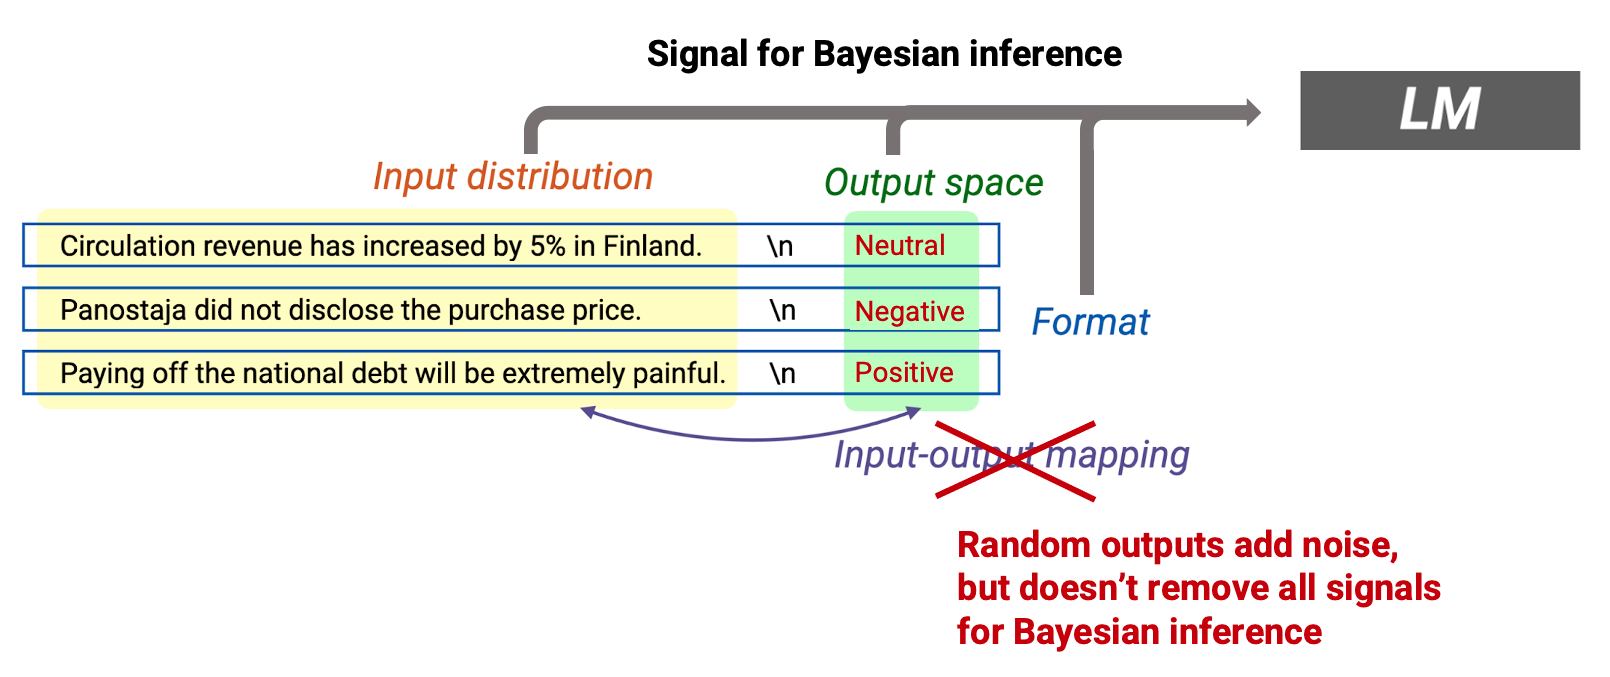
输出的标签在输出空间里面随机选取,对准确率有影响但是没有想象中那么大,进而证明了对 in-context learning 更重要的因素是任务描述,而不是提供的 prompt 是否正确(因为答案错误并没有影响这个任务的目的:情感分类)。
为了使用数学工具进行分析,作者将前文中提到的任务描述定义为 $\theta$,一篇自然语言预料可能包含多个不同的 $\theta \in \Theta$,而一个 prompt 只包含一个 $\theta^*$(例如你考虑你正在写一篇任务传记,你的任务顺序可能是:名字 $\to$ 国籍 $\to$ 职业 $\to$ 成就等包含多个任务,但是在 prompt 中任务顺序是:名字 $\to$ 国籍 $\to$ 名字 $\to$ 国籍 $\to$ 名字 $\to$ 国籍...,只在重复进行一个任务)(国籍 $\to$ 名字这个就是前文提到的分布不匹配,因为自然语言不会出现这样的分布,这种不匹配可以被有利因素补偿),同时我们认为 $\theta^* \in \Theta$(我们认为 icl 要做的任务一定在预训练的语料中出现过了)。
$$p(y|S_n,x_{test})=\int_{\theta} p(y|S_n,\;x_{test},\;\theta)p(\theta | S_n,\;x_{test})\, \mathrm{d}x$$
$$\propto\;\int_{\theta} p(y|S_n,\;x_{test},\;\theta)p(S_n,\;x_{test} | \theta)p(\theta)\, \mathrm{d}x \;\;\;\;(Bayes'\;rule,\;drop\;the\;constant\;\frac{1}{p(S_n,\;x_{test})})$$
$$\propto\; \int_{\theta} p(y|S_n,\;x_{test},\;\theta) \frac{p(S_n,\;x_{test} | \theta)}{p(S_n,\;x_{test} | \theta^*)} p(\theta)\, \mathrm{d}x\;\;\;\;(divided\;by\;a\;constant)$$
待补充。。。
论文笔记 - An Explanation of In-context Learning as Implicit Bayesian Inference的更多相关文章
- Deep Learning论文笔记之(八)Deep Learning最新综述
Deep Learning论文笔记之(八)Deep Learning最新综述 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文,但老感觉看完 ...
- 论文笔记《Spatial Memory for Context Reasoning in Object Detection》
好久不写论文笔记了,不是没看,而是很少看到好的或者说值得记的了,今天被xinlei这篇paper炸了出来,这篇被据老大说xinlei自称idea of the year,所以看的时候还是很认真的,然后 ...
- 论文笔记:A Review on Deep Learning Techniques Applied to Semantic Segmentation
A Review on Deep Learning Techniques Applied to Semantic Segmentation 2018-02-22 10:38:12 1. Intr ...
- 论文笔记 — MatchNet: Unifying Feature and Metric Learning for Patch-Based Matching
论文:https://github.com/ei1994/my_reference_library/tree/master/papers 本文的贡献点如下: 1. 提出了一个新的利用深度网络架构基于p ...
- (论文笔记Arxiv2021)Walk in the Cloud: Learning Curves for Point Clouds Shape Analysis
目录 摘要 1.引言 2.相关工作 3.方法 3.1局部特征聚合的再思考 3.2 曲线分组 3.3 曲线聚合和CurveNet 4.实验 4.1 应用细节 4.2 基准 4.3 消融研究 5.总结 W ...
- 论文笔记 Spatial contrasting for deep unsupervised learning
在我们设计无监督学习模型时,应尽量做到 网络结构与有监督模型兼容 有效利用有监督模型的基本模块,如dropout.relu等 无监督学习的目标是为有监督模型提供初始化的参数,理想情况是"这些 ...
- 论文笔记之:DualGAN: Unsupervised Dual Learning for Image-to-Image Translation
DualGAN: Unsupervised Dual Learning for Image-to-Image Translation 2017-06-12 21:29:06 引言部分: 本文提出 ...
- 【论文笔记】多任务学习(Multi-Task Learning)
1. 前言 多任务学习(Multi-task learning)是和单任务学习(single-task learning)相对的一种机器学习方法.在机器学习领域,标准的算法理论是一次学习一个任务,也就 ...
- 论文笔记——NEURAL ARCHITECTURE SEARCH WITH REINFORCEMENT LEARNING
论文地址:https://arxiv.org/abs/1611.01578 1. 论文思想 强化学习,用一个RNN学一个网络参数的序列,然后将其转换成网络,然后训练,得到一个反馈,这个反馈作用于RNN ...
随机推荐
- java中list集合的几种去重方式
public class ListDistinctExample { public static void main(String[] args) { List<Integer> list ...
- Live2d Widget
写在最前 最早的时候看别人的博客很多都有一个可爱的看板娘,然后就找了教程给自己也整了一个.因为找到的教程都是稂莠不齐的,原作者自己说的也略显含糊(其实是我自己看不懂).总之秉承着一如既往的小白风格.把 ...
- screen -中断保留-屏幕同步
工作中经常用到 screen 用处: 中断保留 和屏幕同步. yum install screen screen -S name 创建 -ls 查看 -r 恢复 -x 同屏
- C#基础_枚举
一.在学习枚举之前,首先来听听枚举的优点. 1.枚举能够使代码更加清晰,它允许使用描述性的名称表示整数值. 2.枚举使代码更易于维护,有助于确保给变量指定合法的.期望的值. 3.枚举使代码更易输入. ...
- AtCoder Beginner Contest 265(D-E)
D - Iroha and Haiku (New ABC Edition) 题意: 找一个最少含有三个点的区间,将区间分成三块,三块的和分别为p,q,r,问是否存在这样的区间 题解:先预处理一遍前缀和 ...
- 大促活动如何抵御大流量 DDoS 攻击?
每一次活动大促带来的迅猛流量,对技术人而言都是一次严峻考验.如果在活动期间遭受黑产恶意DDoS攻击,无疑是雪上加霜.电商的特性是业务常态下通常不会遭受大流量DDoS攻击,且对延迟敏感,因此只需要在活动 ...
- Python图像处理丨认识图像锐化和边缘提取的4个算子
摘要:图像锐化和边缘提取技术可以消除图像中的噪声,提取图像信息中用来表征图像的一些变量,为图像识别提供基础. 本文分享自华为云社区<[Python图像处理] 十七.图像锐化与边缘检测之Rober ...
- ProxySQL 审计
1.审计日志 ProxySQL 2.0.5 引入了审计日志.此功能允许跟踪某些连接活动.要启用此功能,需要配置变量 mysql-auditlog_filename,也就是审计日志的文件名.此变量的默认 ...
- filebeat测试output连通性
在默认的情况下,直接运行filebeat的话,它选择的默认的配置文件是当前目录下的filebeat.yml文件. filebeat.yml文件内容 filebeat.inputs: - type: l ...
- css文字超出后显示...
多行 overflow: hidden; //超出的文本隐藏 text-overflow: ellipsis; //溢出用省略号显示 display: -webkit-box; -webkit-lin ...