
MapReduce 详解
MapReduce的整个运行分为两个阶段: Map和Reduce
Map阶段由一定数量的Map Task组成
输入格式的数据格式化:InputFormat
数日数据的处理:Mapper
数据分组:Partitioner
下面流程图:
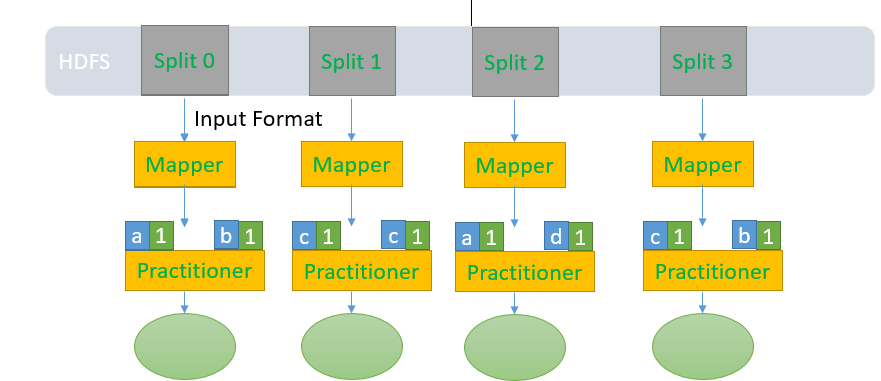
1. Map task 首先从HDFS上Read文件,通过Input Format把分件切分成一个一个的split.生成<Key,Value> key默认用行在文件中的偏移量
2.对每一个split块执行Map操作
3.
4. Maper的<Key,Value>输出到Reducer段
Redue阶段由一定数量的Reduce Task 组成
数据的远程COPY
数据按Key排序
数据处理:Reducer
数据输出格式: OutputFormat
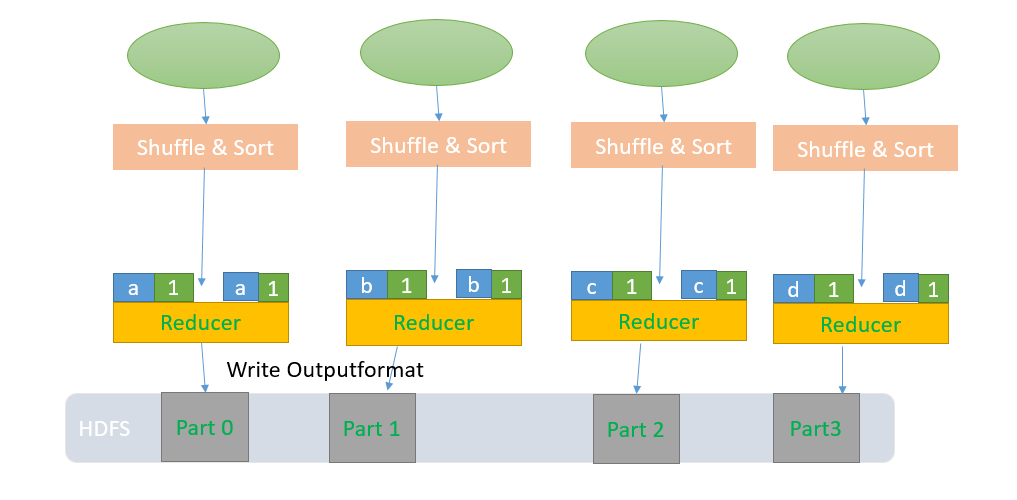
1. 拿到Mapper的ouput作为Input
2. 把patitiioner的结果远程copy到本地
3. Shffle & Sort操作。
4. Reducer操作
5.输出
MapReduce 详解的更多相关文章
- hadoop之mapreduce详解(进阶篇)
上篇文章hadoop之mapreduce详解(基础篇)我们了解了mapreduce的执行过程和shuffle过程,本篇文章主要从mapreduce的组件和输入输出方面进行阐述. 一.mapreduce ...
- 大数据入门第八天——MapReduce详解(三)MR的shuffer、combiner与Yarn集群分析
/mr的combiner /mr的排序 /mr的shuffle /mr与yarn /mr运行模式 /mr实现join /mr全局图 /mr的压缩 今日提纲 一.流量汇总排序的实现 1.需求 对日志数据 ...
- 大数据入门第七天——MapReduce详解(一)入门与简单示例
一.概述 1.map-reduce是什么 Hadoop MapReduce is a software framework for easily writing applications which ...
- hadoop之mapreduce详解(基础篇)
本篇文章主要从mapreduce运行作业的过程,shuffle,以及mapreduce作业失败的容错几个方面进行详解. 一.mapreduce作业运行过程 1.1.mapreduce介绍 MapRed ...
- hadoop之mapreduce详解(优化篇)
一.概述 优化前我们需要知道hadoop适合干什么活,适合什么场景,在工作中,我们要知道业务是怎样的,能才结合平台资源达到最有优化.除了这些我们当然还要知道mapreduce的执行过程,比如从文件的读 ...
- MapReduce:详解Shuffle过程(转)
/** * author : 冶秀刚 * mail : dennyy99@gmail.com */ Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方.要想理解MapRedu ...
- MapReduce:详解Shuffle过程
Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方.要想理解MapReduce, Shuffle是必须要了解的.我看过很多相关的资料,但每次看完都云里雾里的绕着,很难理清大致的逻辑, ...
- MapReduce详解
1.mapreduce之shuffle http://blog.csdn.net/thomas0yang/article/details/8562910 2.彻底了解mapreduce核心Shuffl ...
- [转]MapReduce:详解Shuffle过程
Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方.要想理解MapReduce, Shuffle是必须要了解的.我看过很多相关的资料,但每次看完都云里雾里的绕着,很难理清大致的逻辑, ...
- Hadoop生态集群MapReduce详解
一.概述 MapReduce是一种编程模型,这点很重要,仅仅是一种编程的模型,而不是具体的软件.在hadoop中,HDFS是分布式的文件存储系统,而MapReduce是一个分布式的计算框架.用于大规模 ...
随机推荐
- hadoop运行故障问题解决1——datanode节点启动后自动关闭
ERROR org.apache.hadoop.hdfs.server.datanode.DataNode: java.io.IOException: Incompatible namespaceID ...
- mysql双机热备份的实现步骤
MySQL 提供了数据库的同步功能,这对我们实现数据库的冗灾.备份.恢复.负载均衡等都是有极大帮助的.本文描述了常见的同步设置方法.<?xml:namespace prefix = o /> ...
- 《Effective Java》第8章 通用程序设计
第47条:了解和使用类库 Top 100 Java Libraries on Github 2016 Library Number of Projects Type % of projects jun ...
- Netty学习大纲
1.BIO.NIO和AIO2.Netty 的各大组件3.Netty的线程模型4.TCP 粘包/拆包的原因及解决方法5.了解哪几种序列化协议?包括使用场景和如何去选择6.Netty的零拷贝实现7.Net ...
- break跳出多重循环
大家都知道break只能跳出当前的一个循环语句,如果碰到要跳出多个循环体,那么我们就该在循环体开头设置一个标志位,然后使用带此标志位的break语句跳出多重循环 jump: ;i<;i++){ ...
- Spring @ResponseBody 返回乱码 的优雅解决办法
版权声明:本文为博主原创文章,未经博主允许不得转载. 目录(?)[+] 返回的结果中,中文全部被问号(?)代替的解决办法: *-servlet.xml的部分配置如下: <bean id=&quo ...
- Git相关安装包打包下载
Git相关软件偶尔需要***才能下载,故分享于此 1.Git-2.15.0-64-bit.exe 2.TortoiseGit-2.5.0.0-64bit.msi 3.TortoiseGit-Langu ...
- eclipse 链接 hadoop - 问题
问题:在没有联网时可以连接,当联网时无法链接hdfs 解决:重启hadoop各种守护进程 解析:因该跟host文件中有映射ip有关,有待继续解决......(先留个底)
- ubuntu - 常用问题解决命令
查看本机网络通畅 - 网络是否可连接(远程链接时,检验防火墙) ping -c 10 localhost 查看本机进程/端口占用情况(看某一进程是否开启) netstat -tln 具体查看某一进程 ...
- SnackBar使用
注意:build(BuildContext context)在 Scaffold.of(context)之前时,会报错,解决办法:通过build widget来解决,如下代码. import 'pac ...