
14-2-Unsupervised Learning ----Word Embedding
Introduction
词嵌入(word embedding)是降维算法(Dimension Reduction)的典型应用
那如何用vector来表示一个word呢?
1-of-N Encoding
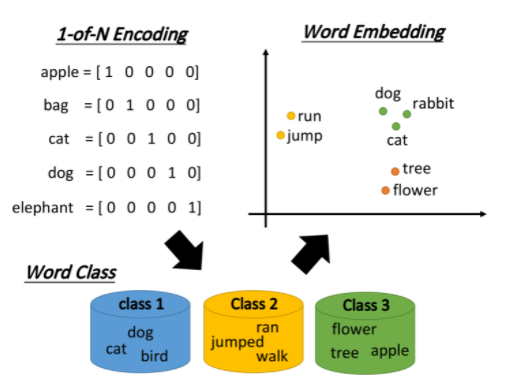
最传统的做法是1-of-N Encoding,假设这个vector的维数就等于世界上所有单词的数目,那么对每一个单词来说,只需要某一维为1,其余都是0即可;但这会导致任意两个vector都是不一样的,你无法建立起同类word之间的联系
Word Class
还可以把有同样性质的word进行聚类(clustering),划分成多个class,然后用word所属的class来表示这个word,但光做clustering是不够的,不同class之间关联依旧无法被有效地表达出来
Word Embedding
词嵌入(Word Embedding)把每一个word都投影到高维空间上,当然这个空间的维度要远比1-of-N Encoding的维度低,假如后者有10w维,那前者只需要50~100维就够了,这实际上也是Dimension Reduction的过程
类似语义(semantic)的词汇,在这个word embedding的投影空间上是比较接近的,而且该空间里的每一维都可能有特殊的含义
假设词嵌入的投影空间如下图所示,则横轴代表了生物与其它东西之间的区别,而纵轴则代表了会动的东西与静止的东西之间的差别
怎么做Word Embedding?
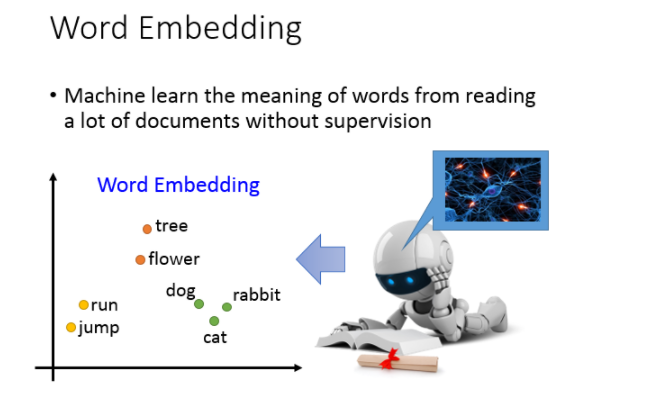
那怎么做word Embedding呢?word Embedding是Unsupervised 。我们怎么让machine知道每一个词汇的含义是什么呢,你只要透过machine阅读大量的文章,它就可以知道每一个词汇它的embeding feature vector应该长什么样子。
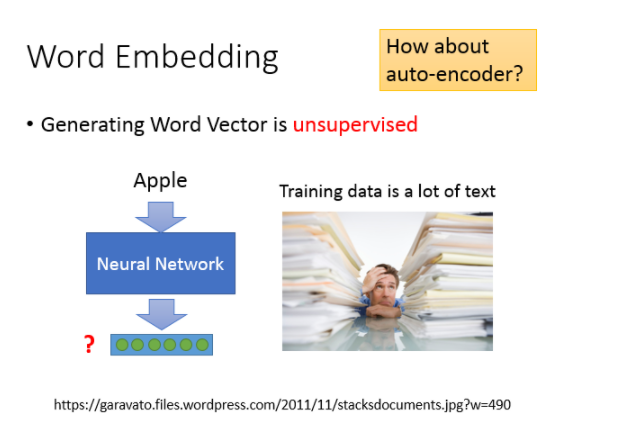
word embedding是一个无监督的方法(unsupervised approach),只要让机器阅读大量的文章,它就可以知道每一个词汇embedding之后的特征向量应该长什么样子。
我们的任务就是训练一个neural network,input是词汇,output则是它所对应的word embedding vector,实际训练的时候我们只有data的input,该如何解这类问题呢?
之前提到过一种基于神经网络的降维方法,Auto-encoder,就是训练一个model,让它的输入等于输出,取出中间的某个隐藏层就是降维的结果,自编码的本质就是通过自我压缩和解压的过程来寻找各个维度之间的相关信息;但word embedding这个问题是不能用Auto-encoder来解的,因为输入的向量通常是1-of-N编码,各维无关,很难通过自编码的过程提取出什么有用信息。
Word Embedding
basic idea
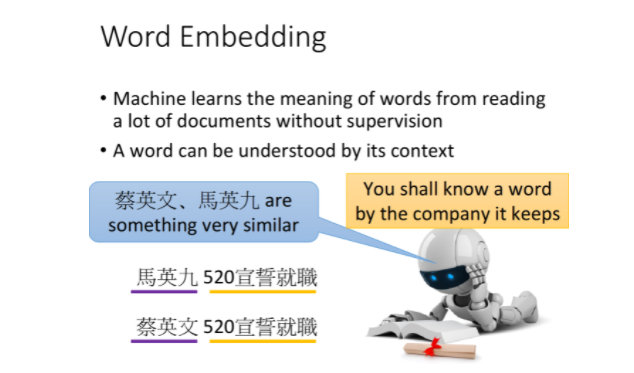
基本精神就是,每一个词汇的含义都可以根据它的上下文来得到
比如机器在两个不同的地方阅读到了“马英九520宣誓就职”、“蔡英文520宣誓就职”,它就会发现“马英九”和“蔡英文”前后都有类似的文字内容,于是机器就可以推测“马英九”和“蔡英文”这两个词汇代表了可能有同样地位的东西,即使它并不知道这两个词汇是人名
怎么用这个思想来找出word embedding的vector呢?有两种做法:
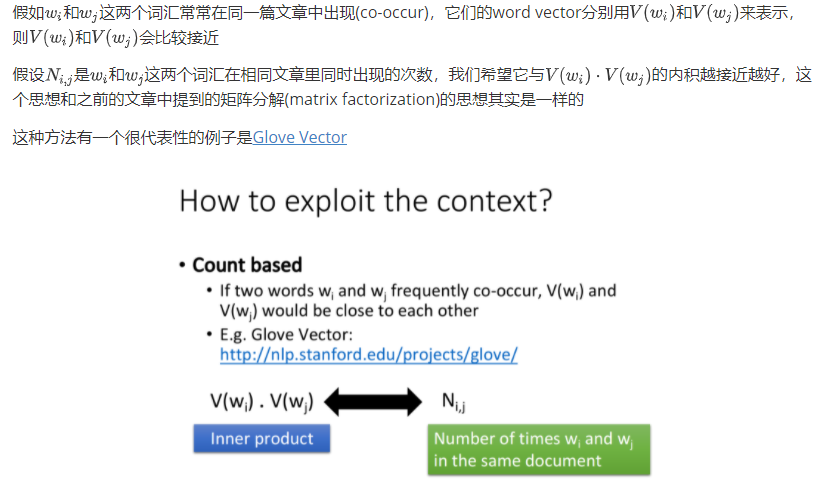
- Count based
- Prediction based
Count based
Prediction based
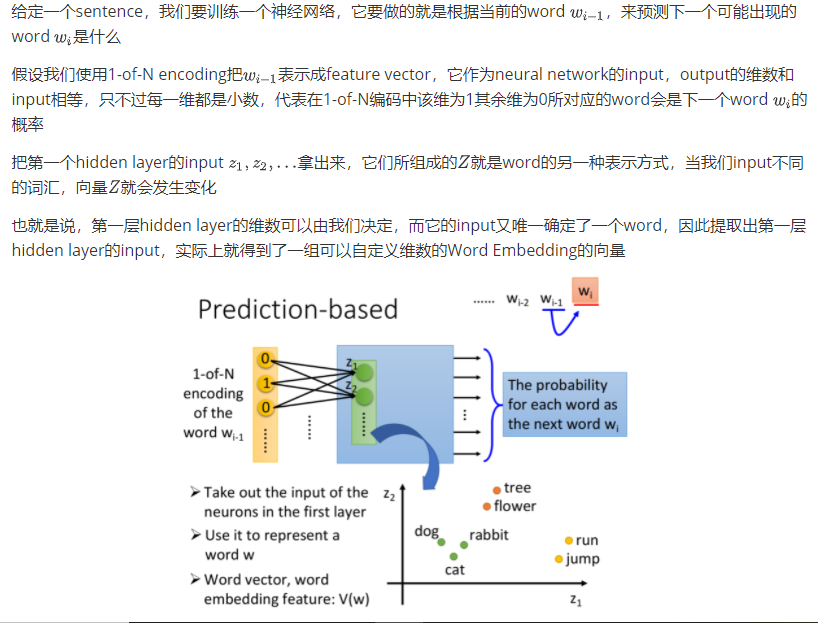
how to do perdition
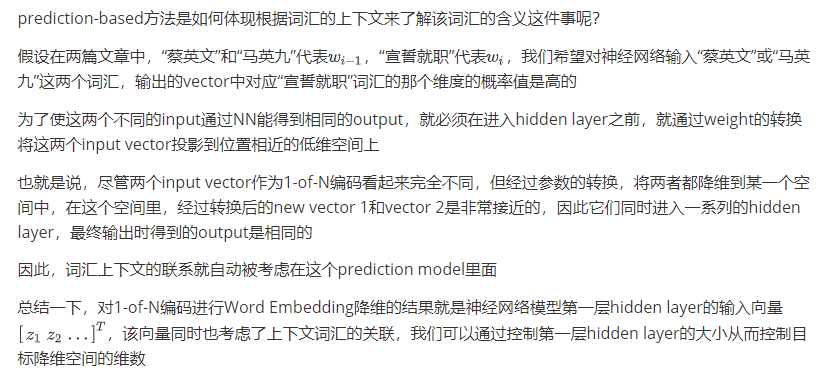
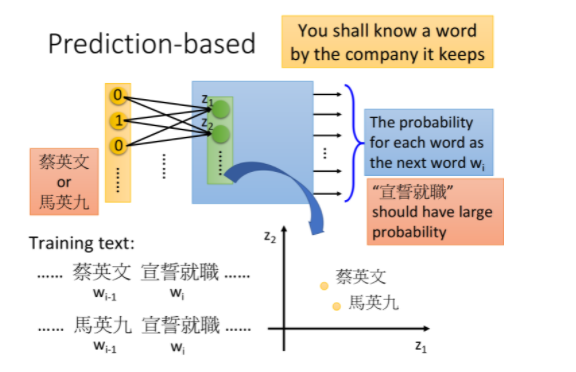
Why prediction works
Sharing Parameters
14-2-Unsupervised Learning ----Word Embedding的更多相关文章
- Unsupervised Learning: Use Cases
Unsupervised Learning: Use Cases Contents Visualization K-Means Clustering Transfer Learning K-Neare ...
- Unsupervised Learning and Text Mining of Emotion Terms Using R
Unsupervised learning refers to data science approaches that involve learning without a prior knowle ...
- 从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史(转载)
转载 https://zhuanlan.zhihu.com/p/49271699 首发于深度学习前沿笔记 写文章 从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史 张 ...
- 建模角度理解word embedding及tensorflow实现
http://www.jianshu.com/p/d44ce1e3ec2f 1. 前言 本篇主要介绍关键词的向量表示,也就是大家熟悉的word embedding.自Google 2013 年开源wo ...
- Word Embedding与Word2Vec
http://blog.csdn.net/baimafujinji/article/details/77836142 一.数学上的“嵌入”(Embedding) Embed这个词,英文的释义为, fi ...
- DeepNLP的核心关键/NLP词的表示方法类型/NLP语言模型 /词的分布式表示/word embedding/word2vec
DeepNLP的核心关键/NLP语言模型 /word embedding/word2vec Indexing: 〇.序 一.DeepNLP的核心关键:语言表示(Representation) 二.NL ...
- [DeeplearningAI笔记]序列模型2.1-2.2词嵌入word embedding
5.2自然语言处理 觉得有用的话,欢迎一起讨论相互学习~Follow Me 2.1词汇表征 Word representation 原先都是使用词汇表来表示词汇,并且使用1-hot编码的方式来表示词汇 ...
- Unsupervised learning, attention, and other mysteries
Unsupervised learning, attention, and other mysteries Get notified when our free report “Future of M ...
- 无监督学习(Unsupervised Learning)
无监督学习(Unsupervised Learning) 聚类无监督学习 特点 只给出了样本, 但是没有提供标签 通过无监督学习算法给出的样本分成几个族(cluster), 分出来的类别不是我们自己规 ...
随机推荐
- 洛谷2375 NOI2014动物园(KMP)
题目链接: 题目. 简单一点来说,这个题就是求一个字符串的\(num\)数组的和,其中有\(num[i]\)表示1~i中有多少个不交叉的相等的前缀和后缀 的数目,要求一个\(O(n)\)的做法 QwQ ...
- FastAPI 学习之路(四)
系列文章: FastAPI 学习之路(一)fastapi--高性能web开发框架 FastAPI 学习之路(二) FastAPI 学习之路(三) 之前的文章分享了如何去在请求中增加参数,本文我们将分享 ...
- 👊 Spring技术原理系列(7)带你看看那些可能你还不知道的Spring特性技巧哦!
前提介绍 本文主要介绍相关Spring框架的一些新特性问题机制,包含了一些特定注解方面的认识. @Lazy可以延迟依赖注入 @Lazy注解修饰在类层面! @Lazy @Service public c ...
- Linux Manual
man 命令用来访问存储在Linux系统上的手册页面.在想要查找的工具的名称前面输入man命 令,就可以找到那个工具相应的手册条目. 手册页不是唯一的参考资料.还有另一种叫作 info 页面的信息.可 ...
- paramiko远程控制host执行脚本的用法
import paramiko ssh = paramiko.SSHClient() print ssh.get_host_keys() ssh.set_missing_host_key_policy ...
- 更好的 java 重试框架 sisyphus 入门简介
What is Sisyphus sisyphus 综合了 spring-retry 和 gauva-retrying 的优势,使用起来也非常灵活. 为什么选择这个名字 我觉得重试做的事情和西西弗斯很 ...
- python flask1
以这个服务端代码为例,简单了解一下flask的运用. 1.app = Flask(__name__)记住就好了 2.@app.route("/")记住就好了:注意括号里的是调用这个 ...
- Tekton+Argocd实现自动化流水线
目录 什么是tekton 安装tekton 安装Dashboard Tekton提供的CRD 安装argocd 创建argocd 安装客户端 连接argocd server 创建App 集群中查看效果 ...
- python进阶(21)typing模块--类型提示支持
typing介绍 Python是一门弱类型的语言,很多时候我们可能不清楚函数参数的类型或者返回值的类型,这样会导致我们在写完代码一段时间后回过头再看代码,忘记了自己写的函数需要传什么类型的参数,返 ...
- UltraSoft - Alpha - Scrum Meeting 3
Date: Apr 15th, 2020. 会议内容为 贡献分确定与进度汇报. Scrum 情况汇报 进度情况 组员 负责 昨日进度 后两日任务 CookieLau PM.后端 学习前后端分离技术的项 ...