
spark介绍
什么是Spark
Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。其架构如下图所示:
<ignore_js_op>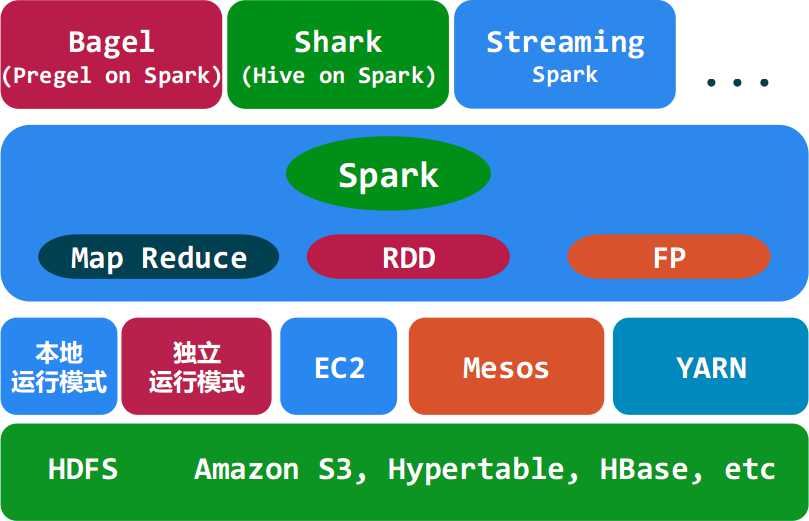
Spark与Hadoop的对比
- Spark的中间数据放到内存中,对于迭代运算效率更高。
Spark更适合于迭代运算比较多的ML和DM运算。因为在Spark里面,有RDD的抽象概念。
- Spark比Hadoop更通用
Spark提供的数据集操作类型有很多种,不像Hadoop只提供了Map和Reduce两种操作。比如map, filter, flatMap, sample, groupByKey, reduceByKey, union, join, cogroup, mapValues, sort,partionBy等多种操作类型,Spark把这些操作称为Transformations。同时还提供Count, collect, reduce, lookup, save等多种actions操作。
这些多种多样的数据集操作类型,给给开发上层应用的用户提供了方便。各个处理节点之间的通信模型不再像Hadoop那样就是唯一的Data Shuffle一种模式。用户可以命名,物化,控制中间结果的存储、分区等。可以说编程模型比Hadoop更灵活。
不过由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。
- 容错性。
在分布式数据集计算时通过checkpoint来实现容错,而checkpoint有两种方式,一个是checkpoint data,一个是logging the updates。用户可以控制采用哪种方式来实现容错。
- 可用性。
Spark通过提供丰富的Scala, Java,Python API及交互式Shell来提高可用性。
Spark与Hadoop的结合
Spark可以直接对HDFS进行数据的读写,同样支持Spark on YARN。Spark可以与MapReduce运行于同集群中,共享存储资源与计算,数据仓库Shark实现上借用Hive,几乎与Hive完全兼容。
Spark的适用场景
Spark是基于内存的迭代计算框架,适用于需要多次操作特定数据集的应用场合。需要反复操作的次数越多,所需读取的数据量越大,受益越大,数据量小但是计算密集度较大的场合,受益就相对较小(大数据库架构中这是是否考虑使用Spark的重要因素)
由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。
总的来说Spark的适用面比较广泛且比较通用。
运行模式
本地模式
Standalone模式
Mesoes模式
yarn模式
Spark生态系统
Shark ( Hive on Spark): Shark基本上就是在Spark的框架基础上提供和Hive一样的H iveQL命令接口,为了最大程度的保持和Hive的兼容性,Shark使用了Hive的API来实现query Parsing和 Logic Plan generation,最后的PhysicalPlan execution阶段用Spark代替Hadoop MapReduce。通过配置Shark参数,Shark可以自动在内存中缓存特定的RDD,实现数据重用,进而加快特定数据集的检索。同时,Shark通过UDF用户自定义函数实现特定的数据分析学习算法,使得SQL数据查询和运算分析能结合在一起,最大化RDD的重复使用。
Spark streaming: 构建在Spark上处理Stream数据的框架,基本的原理是将Stream数据分成小的时间片断(几秒),以类似batch批量处理的方式来处理这小部分数据。Spark Streaming构建在Spark上,一方面是因为Spark的低延迟执行引擎(100ms+)可以用于实时计算,另一方面相比基于Record的其它处理框架(如Storm),RDD数据集更容易做高效的容错处理。此外小批量处理的方式使得它可以同时兼容批量和实时数据处理的逻辑和算法。方便了一些需要历史数据和实时数据联合分析的特定应用场合。
Bagel: Pregel on Spark,可以用Spark进行图计算,这是个非常有用的小项目。Bagel自带了一个例子,实现了Google的PageRank算法。
spark介绍的更多相关文章
- Spark 介绍(基于内存计算的大数据并行计算框架)
Spark 介绍(基于内存计算的大数据并行计算框架) Hadoop与Spark 行业广泛使用Hadoop来分析他们的数据集.原因是Hadoop框架基于一个简单的编程模型(MapReduce),它支持 ...
- Spark介绍及安装部署
一.Spark介绍 1.1 Apache Spark Apache Spark是一个围绕速度.易用性和复杂分析构建的大数据处理框架(没有数据存储).最初在2009年由加州大学伯克利分校的AMPLab开 ...
- Spark 介绍
MapReduce给用户提供了简单的编程接口,用户只需要按照接口编写串行版本的代码,Hadoop框架会自动把程序运行到很多机器组成的集群上,并能处理某些机器在运行过程中出现故障的情况.然而,在MapR ...
- Spark记录-spark介绍
Apache Spark是一个集群计算设计的快速计算.它是建立在Hadoop MapReduce之上,它扩展了 MapReduce 模式,有效地使用更多类型的计算,其中包括交互式查询和流处理.这是一个 ...
- 大数据系列之并行计算引擎Spark介绍
相关博文:大数据系列之并行计算引擎Spark部署及应用 Spark: Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎. Spark是UC Berkeley AMP lab ( ...
- Apache Spark介绍及集群搭建
简介 Spark是一个针对于大规模数据处理的统一分析引擎.其处理速度比MapReduce快很多.其特征有: 1.速度快 spark比mapreduce在内存中快100x,比mapreduce在磁盘中快 ...
- spark介绍4(sparksql)ODBC(Windows)gc
(ODBC是open database connection开源数据连接) 在Windows控制面板的管理工具里面 GC(Garbage Collection):JAVA/.NET中的垃圾回收器 l ...
- spark介绍3
- spark介绍2
上述结果是 map 1 filter 1 map 2 filter 2 map 3 filter 3 map 4 filter 4 即说明是并行,且互不干扰,每个task运行到最后
随机推荐
- easyDialog弹窗+zTree部门选择
写一个父页面方法,将name和id赋值 function show(name,id) { $("#deptnoID").val(name); $("#deptnoId&q ...
- 关于PHP的一小段代码求解如下求解"%2\$s"
<?php$format = "The %2\$s contains %1\$d monkeys";printf($format, 8, "北京");?& ...
- servlet之过滤器(转载)
林炳文Evankaka原创作品.转载请注明出处http://blog.csdn.net/evankaka 一.Filter 1.过滤器的概念 Java中的Filter 并不是一个标准的Servlet ...
- Hibernate5-课程笔记2
单表的增删改查操作: (1)定义获取Session和SessionFactory的工具类: package com.tongji.utils; import org.hibernate.Session ...
- SQL learning
一.创建和删除数据库 1.创建用户 //创建用户且置密码,在MySQL中行,但在Oracle中行 ----必须在超级管理员身份下操作 create user hncu identified by ' ...
- UEditor+七牛,实现图片直连上传
最近做的项目,涉及到使用富文本编辑器,我选择了百度的UEditor.同时,我们的图片放在七牛云存储上.关于这两者间的集成,我写下一些个人的经验,与大家分享. 图片上传方案 目前来说,Web端基于七牛等 ...
- 《JS权威指南学习总结--8.5 作为命名空间的函数》
内容要点: 函数作用域的概念:在函数中声明的变量在整个函数体内都是可见的(包括在嵌套的函数中),在函数的外部是不可见的.不在任何函数内声明的变量是全局变量,在整个JS程序中都是可见的. 在JS中 ...
- Web安全知多少
随着Web2.0.网络社交等一系列新型的互联网产品的诞生,基于Web环境的互联网应用越来越广泛,企业信息化的过程中,越来越多的应用都架设在Web平台上.Web业务的迅速发展吸引了黑客们的强烈关注,接踵 ...
- soapui工具使用时400 Bad Request
因为项目中用json格式进行传输数据,多次确认json中的各个属性与接口中的对象属性一致,还是不能正常访问到接口.想起json数据中有中文, 在soapui的左下角将Encoding 的值设为utf- ...
- hdu 5664 Lady CA and the graph(树的点分治+容斥)
题意: 给你一个有n个点的树,给定根,叫你找第k大的特殊链 .特殊的链的定义:u,v之间的路径,经过题给的根节点. 题解:(来自BC官方题解) 对于求第k大的问题,我们可以通过在外层套一个二分,将其转 ...