
scrapy下载 大文件处理
# 一个校花网图片下载的案例,也适合大文件处理,多个文件视频,音频处理
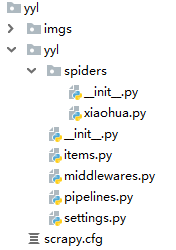
工程流程 --

scrapy startproject xx

cd xx

scrapy genspider hh www.xx.com

爬虫执行 scrapy crawl hh
import scrapy

from yyl.items import YylItem

class ExampleSpider(scrapy.Spider):

    name = 'xiaohua'

    # allowed_domains = ['example.com']

    start_urls = ['http://www.521609.com/daxuemeinv/']

    def parse(self, response):

        li_lst = response.xpath('//*[@id="content"]/div[2]/div[2]/ul/li')

        # print(li_lst)

        for li in li_lst:

            item = YylItem() #实例化

            # item['src'] = 'http://www.521609.com{}'.format(li.xpath('./a/img/@src').extract_first())

            item['src'] = 'http://www.521609.com' + li.xpath('./a/img/@src').extract_first()  # 拼接完整地址

            yield item

# 管道负责  下载url  视频 压缩包  大文件下载的机制
爬虫文件
import scrapy

class YylItem(scrapy.Item):

    # define the fields for your item here like:

    src = scrapy.Field()
items.py
import scrapy

from scrapy.pipelines.images import ImagesPipeline

class YylPipeline(object):

    def process_item(self, item, spider):

        print(item)

        return item

# 使用一个scrapy封装好的一个专门用于大文件下载的管道类

class ImgPipeline(ImagesPipeline):

    # 进行大文件的请求

    def get_media_requests(self, item, info):

        yield scrapy.Request(url=item['src'])

    # 用于指定被下载文件的名称

    def file_path(self, request, response=None, info=None):

        url = request.url

        filename = url.split('/')[-1]

        return filename

    #

    def item_completed(self, results, item, info):

        print(results)  # 结果 True,{url path checksum}

        return item  # process_item中的return item 作用一致
管道.py
BOT_NAME = 'yyl'

SPIDER_MODULES = ['yyl.spiders']

NEWSPIDER_MODULE = 'yyl.spiders'

# Crawl responsibly by identifying yourself (and your website) on the user-agent

USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36'

# Obey robots.txt rules

ROBOTSTXT_OBEY = False

# Configure maximum concurrent requests performed by Scrapy (default: 16)

#CONCURRENT_REQUESTS = 32

# Configure a delay for requests for the same website (default: 0)

# See https://doc.scrapy.org/en/latest/topics/settings.html#download-delay

# See also autothrottle settings and docs

#DOWNLOAD_DELAY = 3

# The download delay setting will honor only one of:

#CONCURRENT_REQUESTS_PER_DOMAIN = 16

#CONCURRENT_REQUESTS_PER_IP = 16

# Disable cookies (enabled by default)

#COOKIES_ENABLED = False

# Disable Telnet Console (enabled by default)

#TELNETCONSOLE_ENABLED = False

# Override the default request headers:

#DEFAULT_REQUEST_HEADERS = {

#   'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

#   'Accept-Language': 'en',

#}

# Enable or disable spider middlewares

# See https://doc.scrapy.org/en/latest/topics/spider-middleware.html

#SPIDER_MIDDLEWARES = {

#    'yyl.middlewares.YylSpiderMiddleware': 543,

#}

# Enable or disable downloader middlewares

# See https://doc.scrapy.org/en/latest/topics/downloader-middleware.html

#DOWNLOADER_MIDDLEWARES = {

#    'yyl.middlewares.YylDownloaderMiddleware': 543,

#}

# Enable or disable extensions

# See https://doc.scrapy.org/en/latest/topics/extensions.html

#EXTENSIONS = {

#    'scrapy.extensions.telnet.TelnetConsole': None,

#}

# Configure item pipelines

# See https://doc.scrapy.org/en/latest/topics/item-pipeline.html

ITEM_PIPELINES = {

   'yyl.pipelines.YylPipeline': 301,

   'yyl.pipelines.ImgPipeline': 300,

}

IMAGES_STORE = './imgs'

LOG_LEVEL = 'ERROR'
settings.py
scrapy下载 大文件处理的更多相关文章
- 转(Response.WriteFile 无法下载大文件解决方法)
以前用Response.WriteFile(filename),但当遇到大文件时无法完整下载. 该方法最大的问题,它不是直接将数据抛到客户端,而是在服务器端(IIS)上缓存.当下载文件比较大时,服务器 ...
- python下载大文件
1. wget def download_big_file_with_wget(url, target_file_name): """ 使用wget下载大文件 Note: ...
- python 下载大文件
当使用requests的get下载大文件/数据时,建议使用使用stream模式. 当把get函数的stream参数设置成False时,它会立即开始下载文件并放到内存中,如果文件过大,有可能导致内存不足 ...
- ASP.Net 下载大文件的实现
当我们的网站需要支持下载大文件时,如果不做控制可能会导致用户在访问下载页面时发生无响应,使得浏览器崩溃.可以参考如下代码来避免这个问题. 关于此代码的几点说明: 1. 将数据分成较小的部分,然后将其移 ...
- Android 开发工具类 27_多线程下载大文件
多线程下载大文件时序图 FileDownloader.java package com.wangjialin.internet.service.downloader; import java.io.F ...
- ASP.NET Core下载大文件的实现
当我们的ASP.NET Core网站需要支持下载大文件时,如果不做控制可能会导致用户在访问下载页面时发生无响应,使得浏览器崩溃.可以参考如下代码来避免这个问题. 关于此代码的几点说明: 将数据分成较小 ...
- [libcurl]_[0基础]_[使用libcurl下载大文件]
场景: 1. 在Windows编程时, 下载http页面(html,xml)能够使用winhttp库,可是并非非常下载文件,由于会失败. 由此引出了WinINet库,无奈这个库的稳定性比較低,使用样例 ...
- ASP.Net 下载大文件的实现 (转)
原文:http://www.cnblogs.com/luisliu/p/4253815.html 当我们的网站需要支持下载大文件时,如果不做控制可能会导致用户在访问下载页面时发生无响应,使得浏览器崩溃 ...
- Linux如何使用cURL分割下载大文件
Linux如何使用cURL分割下载大文件 - 51CTO.COM http://os.51cto.com/art/201508/489368.htm
随机推荐
- BZOJ3680 JSOI2004 平衡点 - 随机/近似算法
迭代乱搞了下就过了…… #include <bits/stdc++.h> using namespace std; ],y[],w[]; double xm,ym,wt,k,lambda= ...
- PHP实现微信公众号分享接口
还是一贯风格:用代码说话!!! <?php class ShareModel extends BaseModel { var $appId = APPID; var $appSecret = A ...
- 在 window 上卸载 mysql
1.停止 mysql 服务 开始——>控制面板——>管理工具——>服务,停掉 MySQL 的服务 2.卸载安装包 控制面板-添加删除程序,找到MySQL,卸载(可能会有多个安装包,需 ...
- Ecshop各个页面文件介绍,主要文件功能说明
1.模板文件说明 style.css – 模板所使用样式表activity.dwt – 活动列表article.dwt – 文章内容页article_cat.dwt – 文章列表页article_pr ...
- 数据库之六:聚合函数、group by、having、order by
1.聚合函数: 1.1.COUNT: 计算表中的记录数(行数)可以计算出所有数据行: select count(*) from table_name 可以计算出所有非空行数 select count( ...
- HTML之<meta>标签全解
一.定义 元素可提供相关页面的元信息(meta-information),比如针对搜索引擎和更新频度的描述和关键词等等. 标签位于文档的头部<head></head>标签内 ...
- 通过css修改input的边框
input{ border:1px solid #d2d2d2; background-color:transparent; } 可以看到主要是把背景色调成透明的颜色,从而来进行边框的设置
- LoadRunner使用记录
基本术语 性能测试--通过自动化的测试工具模拟多种正常.峰值以及异常负载条件来对系统的各项性能指标进行测试. 负载测试和压力测试都属于性能测试,两者可以结合进行. 负载测试,确定在各种工作负载下系统的 ...
- MYSQL获取表空间大小
SELECT table_name AS "Table", round(((data_length + index_length) / 1024 / 1024), 2) as si ...
- 2.11 webdriver中使用 FileUtils ()
http://snkcxy.iteye.com/blog/1845862 ex: 比较网页截图图片与预期是否一致 File screenshot=((TakesScreenshot)driver ). ...