
scrapy的使用-LinkExtractor
背景:
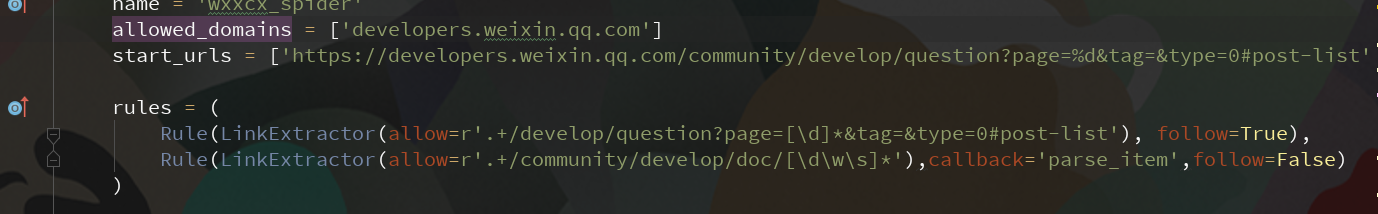
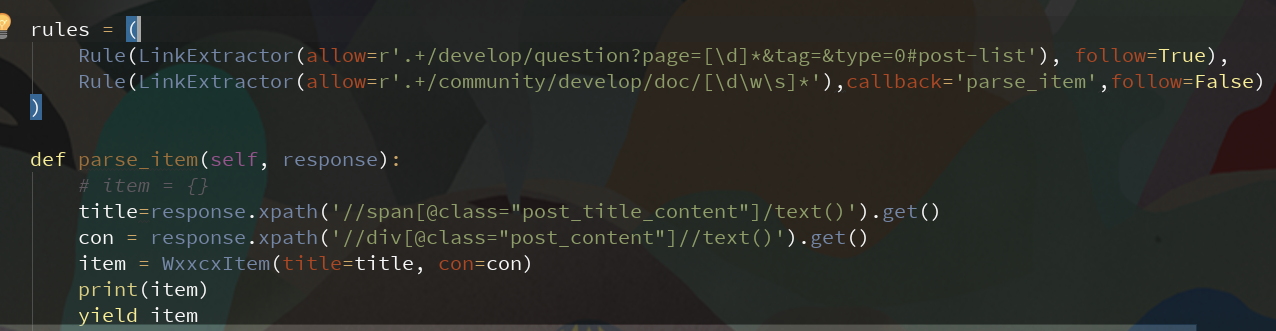
在爬取网站信息是需要获取特定标签下的某些内容,就需要获取这些标签下的链接,如果获取每一个,在通过这个获取它下面的信息,这样效率会很低,时间复杂度O(n^2),但如果先获取链接,再获取内容,则时间复杂度为O(n)+O(n),每次执行完深度为2,则时间复杂度为O(n).效率会明显提高,非常适合整站爬取。
allow() #allow(正则表达式(或的列表)) - 一个单一的正则表达式(或正则表达式列表),(绝对)urls必须匹配才能提取。如果没有给出(或为空),它将匹配所有链接。

deny() #deny(正则表达式或正则表达式列表) - 一个正则表达式(或正则表达式列表),(绝对)urls必须匹配才能排除(即不提取)。它优先于allow参数。如果没有给出(或为空),它不会排除任何链接。

allow_domains() #allow_domains(str或list) - 单个值或包含将被考虑用于提取链接的域的字符串列表

deny_domains() #deny_domains(str或list) - 单个值或包含不会被考虑用于提取链接的域的字符串列表

deny_extensions() #deny_extensions(list) - 包含在提取链接时应该忽略的扩展的单个值或字符串列表。如果没有给出,它将默认为IGNORED_EXTENSIONS在scrapy.linkextractors包中定义的 列表 。

restrict_xpaths() # restrict_xpaths(str或list) - 是一个XPath(或XPath的列表),它定义响应中应从中提取链接的区域。如果给出,只有那些XPath选择的文本将被扫描链接。参见下面的例子。

restrict_css() # restrict_css(str或list) - 一个CSS选择器(或选择器列表),用于定义响应中应提取链接的区域。有相同的行为restrict_xpaths。 标签(str或list) - 标签或在提取链接时要考虑的标签列表。默认为。('a', 'area')

attrs() # attrs(list) - 在查找要提取的链接时应该考虑的属性或属性列表(仅适用于参数中指定的那些标签tags )。默认为('href',)

canonicalize() #  canonicalize(boolean) - 规范化每个提取的url(使用w3lib.url.canonicalize_url)。默认为True。

unique() # unique(boolean) - 是否应对提取的链接应用重复过滤。

process_value() # process_value(callable) -

接收从标签提取的每个值和扫描的属性并且可以修改值并返回新值的函数,或者返回None以完全忽略链接。如果没有给出,process_value默认为。lambda x: x
scrapy的使用-LinkExtractor的更多相关文章
- scrapy之使用LinkExtractor提取链接
一.概述: 在页面含有少量链接时,使用selector来提取信息就可以,但如果链接特别多时,就需要用LinkExtractor来提取. 二.LinkExtractor构造器的各个参数: 1.allow ...
- scrapy中使用LinkExtractor提取链接
le = LinkExtractor(restrict_css='ul.pager li.next') links = le.extract_links(response) 使用LinkExtra ...
- Scrapy爬取自己的博客内容
python中常用的写爬虫的库有urllib2.requests,对于大多数比较简单的场景或者以学习为目的,可以用这两个库实现.这里有一篇我之前写过的用urllib2+BeautifulSoup做的一 ...
- 爬虫的入门以及scrapy
一.简介 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用的名字还有蚂蚁.自动索引.模拟 ...
- 教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http://www.xiaohuar.com/,让你体验爬取校花的成就感. Scr ...
- 爬虫之scrapy框架
解析 Scrapy解释 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓 ...
- 爬虫--Scrapy
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- scrapy 爬取自己的博客
定义项目 # -*- coding: utf-8 -*- # items.py import scrapy class LianxiCnblogsItem(scrapy.Item): # define ...
- 爬虫入门scrapy
Python之路[第十九篇]:爬虫 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用 ...
随机推荐
- cgo 和 Go 语言是两码事
cgo不是Go 借用 JWZ的一句话 有些人,当他们面临一个问题时,认为“我知道,我会使用 cgo ”.那么现在,他们有了两个问题. 最近有人在 Gopher 的 Slack Channel 上使用 ...
- jenkins的api操作
jenkins-client 实现方式 jenkins-client 底层是使用 HttpClient HttpPost 发送post 请求实现的,是将 REST API 封装了一下 添加依赖 < ...
- Openstack贡献者须知 — OpenPGP/SSH/CLA贡献者协议
目录 目录 前言 Openstack基金委员会 Openstack贡献者须知 注册Openstack In Launchpad 生成并上传OpenPGP密钥 生成并上传SSH公钥 Join The O ...
- Java学习之集合(LinkedList链表集合)
一.什么是链表集合,通过图形来看,比如33只知道它下一个是55 如果:现在要删除33的话,就是把55赋值给45,这样看它操作集合速度会非常快. 二.LinkedList特有方法 1.添加 addFir ...
- jeecg随笔 -- 实体关联属性的设计
转载:https://www.iteye.com/blog/1868620 在jeecg 里 ,是根据数据库生成实体的,很多关联关系需要自己进行进一步整理才能满足我们的业务需求 例如外键关系 由于很多 ...
- 使用U盘或在本地电脑作为git远程仓库进行托管
情景描述: 当有两台电脑需要共同维护一段代码,其中一台电脑不希望(或者不能)通过网络的方式进行访问git仓库(即不使用github),那么可以使用U盘作为介质将其作为远程仓库,或者使用局域网中一台电脑 ...
- Hyperledger:常见加密算法分类列表
算法原理查询:http://mathworld.wolfram.com 加密散列函数 (消息摘要算法,消息认证码,MD算法) Keyed-hash message authentication c ...
- cesium中divPoint展示数据
cesium中divPoint展示数据 在用点击面获取位置信息的时候,会弹出一个divPoint框,用来展示这个面的属性信息:或者位置信息. 代码如下: var handlerClick = new ...
- socket API CSocket CAsyncSocket 用法及区别
要进行网络编程就要和Socket打交道,Socket有同步阻塞方式和异步非阻塞方式两种使用,事实上同步和异步在我们编程的生涯中可能遇到了很多,而Socket也没什么特别.虽然同步好用,不费劲,但不能满 ...
- Java 并发理论简述
一:为什么需要多线程? 线程是Java语言中不可或缺的重要部分,它们能使复杂的异步代码变得简单,简化复杂系统的开发:能充分发挥多处理器系统的强大计算能力.多线程和多进程的区别与选择可以参考我的另一篇博 ...