
HBase数据快速导入之ImportTsv&Bulkload
导入数据最快的方式,可以略过WAL直接生产底层HFile文件
(环境:centos6.5、Hadoop2.6.0、HBase0.98.9)
1.SHELL方式
1.1 ImportTsv直接导入
命令:bin/hbase org.apache.hadoop.hbase.mapreduce.ImportTsv
Usage: importtsv -Dimporttsv.columns=a,b,c <tablename> <inputdir>
测试:
1.1.1在HBase中创建好表
create ‘testImport1’,’cf’
1.1.2准备数据文件sample1.csv,并上传到HDFS,内容为:
1,"tom"
2,"sam"
3,"jerry"
4,"marry"
5,"john
1.1.3使用导入命令导入
bin/hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.separator="," -Dimporttsv.columns=HBASE_ROW_KEY,cf testImport1 /sample1.csv
1.1.4结果

1.2先通过ImportTsv生产HFile文件,再通过completeBulkload导入HBase
1.2.1使用刚才的源数据并创建新表
create ‘testImport2’,’cf’
1.2.2使用命令生产HFile文件
bin/hbase org.apache.hadoop.hbase.mapreduce.ImportTsv -Dimporttsv.separator="," -Dimporttsv.bulk.output=hfile_tmp -Dimporttsv.columns=HBASE_ROW_KEY,cf testImport2 /sample1.csv
1.2.3在HDFS上的中间结果

1.2.4使用命令将HFile文件导入HBase
hadoop jar lib/hbase-server-0.98.9-hadoop2.jar completebulkload hfile_tmp testImport2
1.2.5结果
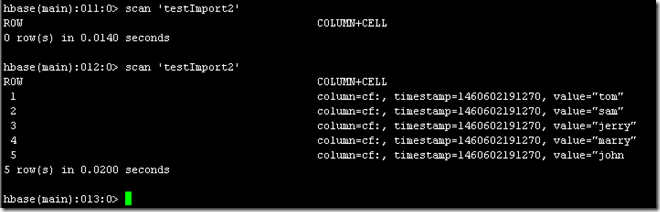
注:1.如果出现缺包错误提示,则把HBase的jar包包含到hadoop的classpath中;2.运行该命令的本质是一个hdfs的mv操作,并不会启动MapReduce。
2.API代码方式
代码的方式更灵活一点,许多东西可以自定义。
直接贴代码吧:
import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FsShell;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.hbase.HBaseConfiguration;

import org.apache.hadoop.hbase.KeyValue;

import org.apache.hadoop.hbase.client.HTable;

import org.apache.hadoop.hbase.io.ImmutableBytesWritable;

import org.apache.hadoop.hbase.mapreduce.HFileOutputFormat2;

import org.apache.hadoop.hbase.mapreduce.LoadIncrementalHFiles;

import org.apache.hadoop.hbase.util.Bytes;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.GenericOptionsParser;

import org.slf4j.Logger;

import org.slf4j.LoggerFactory;

import java.io.IOException;

public class BulkLoadJob {

	static Logger logger = LoggerFactory.getLogger(BulkLoadJob.class);

	public static class BulkLoadMap extends Mapper<LongWritable, Text, ImmutableBytesWritable, KeyValue> {

		public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

			String[] valueStrSplit = value.toString().split("\t");

			String hkey = valueStrSplit[0];

			String family = valueStrSplit[1].split(":")[0];

			String column = valueStrSplit[1].split(":")[1];

			String hvalue = valueStrSplit[2];

			final byte[] rowKey = Bytes.toBytes(hkey);

			final ImmutableBytesWritable HKey = new ImmutableBytesWritable(rowKey);

			// Put HPut = new Put(rowKey);

			// byte[] cell = Bytes.toBytes(hvalue);

			// HPut.add(Bytes.toBytes(family), Bytes.toBytes(column), cell);

			KeyValue kv = new KeyValue(rowKey, Bytes.toBytes(family), Bytes.toBytes(column), Bytes.toBytes(hvalue));

			context.write(HKey, kv);

		}

	}

	public static void main(String[] args) throws Exception {

		Configuration conf = HBaseConfiguration.create();

		conf.set("hbase.zookeeper.property.clientPort", "2182");

		conf.set("hbase.zookeeper.quorum", "msg801,msg802,msg803");

		conf.set("hbase.master", "msg801:60000");

		String[] dfsArgs = new GenericOptionsParser(conf, args).getRemainingArgs();

		String inputPath = dfsArgs[0];

		System.out.println("source: " + dfsArgs[0]);

		String outputPath = dfsArgs[1];

		System.out.println("dest: " + dfsArgs[1]);

		HTable hTable = null;

		try {

			Job job = Job.getInstance(conf, "Test Import HFile & Bulkload");

			job.setJarByClass(BulkLoadJob.class);

			job.setMapperClass(BulkLoadJob.BulkLoadMap.class);

			job.setMapOutputKeyClass(ImmutableBytesWritable.class);

			job.setMapOutputValueClass(KeyValue.class);

			// speculation

			job.setSpeculativeExecution(false);

			job.setReduceSpeculativeExecution(false);

			// in/out format

			job.setInputFormatClass(TextInputFormat.class);

			job.setOutputFormatClass(HFileOutputFormat2.class);

			FileInputFormat.setInputPaths(job, inputPath);

			FileOutputFormat.setOutputPath(job, new Path(outputPath));

			hTable = new HTable(conf, dfsArgs[2]);

			HFileOutputFormat2.configureIncrementalLoad(job, hTable);

			if (job.waitForCompletion(true)) {

				FsShell shell = new FsShell(conf);

				try {

					shell.run(new String[] { "-chmod", "-R", "777", dfsArgs[1] });

				} catch (Exception e) {

					logger.error("Couldnt change the file permissions ", e);

					throw new IOException(e);

				}

				// 加载到hbase表

				LoadIncrementalHFiles loader = new LoadIncrementalHFiles(conf);

				// 两种方式都可以

				// 方式一

				String[] loadArgs = { outputPath, dfsArgs[2] };

				loader.run(loadArgs);

				// 方式二

				// loader.doBulkLoad(new Path(outputPath), hTable);

			} else {

				logger.error("loading failed.");

				System.exit(1);

			}

		} catch (IllegalArgumentException e) {

			e.printStackTrace();

		} finally {

			if (hTable != null) {

				hTable.close();

			}

		}

	}

}
2.1创建新表
create ‘testImport3’,’fm1’,’fm2’
2.2创建sample2.csv,并上传到HDFS,内容为:
key1 fm1:col1 value1
key1 fm1:col2 value2
key1 fm2:col1 value3
key4 fm1:col1 value4
使用命令:
hadoop jar BulkLoadJob.jar hdfs://msg/sample2,csv hdfs://msg/HFileOut testImport3
注:1.mapper中使用KeyValue和Put都可以;2.注意jar包的classpath;3.如果Hadoop是HA,则需要使用HA的名字,比如我们的active namenode名称为msg801,但是HA的nameservice为msg,则HDFS的路径必须使用hdfs://msg而不能使用hdfs://msg801:9000(WHY?)。
具体报错为:
| IllegalArgumentException: Wrong FS: hdfs://msg801:9000/HFileOut/fm2/bbab9d883a574d518cdcb304d1e681e9, expected: hdfs://msg |
HBase数据快速导入之ImportTsv&Bulkload的更多相关文章
- 54.超大数据快速导入MySQL
超大数据快速导入MySQL ----千万级数据只需几十分钟本地测试方法1.首先需要修改本地mysql的编码和路径,找到my.ini.2.在里面添加或修改 character-set-server=u ...
- HBase数据的导入和导出
查阅了几篇中英文资料,发现有的地方说的不是很全部,总结在此,共有两种命令行的方式来实现数据的导入导出功能,即备份和还原. 1 HBase本身提供的接口 其调用形式为: 1)导入 ./hbase org ...
- Mysql百万数据量级数据快速导入Redis
前言 随着系统的运行,数据量变得越来越大,单纯的将数据存储在mysql中,已然不能满足查询要求了,此时我们引入Redis作为查询的缓存层,将业务中的热数据保存到Redis,扩展传统关系型数据库的服务能 ...
- [DJANGO] excel十几万行数据快速导入数据库研究
先贴原来的导入数据代码: 8 import os os.environ.setdefault("DJANGO_SETTINGS_MODULE", "www.setting ...
- excel十几万行数据快速导入数据库研究(转,下面那个方法看看还是可以的)
先贴原来的导入数据代码: 8 import os os.environ.setdefault("DJANGO_SETTINGS_MODULE", "www.setting ...
- Mysql --学习:大量数据快速导入导出
声明:此文供学习使用,原文:https://blog.csdn.net/xiaobaismiley/article/details/41015783 [实验背景] 项目中需要对数据库中一张表进行重新设 ...
- Mysql 千万数据快速导入
最近碰到个项目,需要 千万条数据入库的问题,有原本的 类 csv 文件导入, 统计了下 数据行大概有 1400W 行之多 二话不说, 建表,直接 load LOAD DATA LOCAL INFIL ...
- SQLSERVER大批量数据快速导入Redis
目的 把单表近5千万的某单个字段导入到Redis,作为一个list存储. 方案一: 使用sqlcmd工具(sqlserver自带),直接生成命令在Redis-cli中执行. 方案一. 使用sqlcmd ...
- 使用MySQL的SELECT INTO OUTFILE ,Load data file,Mysql 大量数据快速导入导出
使用MySQL的SELECT INTO OUTFILE .Load data file LOAD DATA INFILE语句从一个文本文件中以很高的速度读入一个表中.当用户一前一后地使用SELECT ...
随机推荐
- .net EventHandler 事件处理
通常定义事件 都是通过自定义委托的方式来实现, 今天使用EventHandler 委托来定义事件: public class NewMailEventArgs : EventArgs { priv ...
- Android-ListView-(BaseAdapter初步)
在Android中就提供了专门列表显示条目的控件,ListView控件,ListView控件不是一次性加载全部数据,他是只加载用户在屏幕看得到的数据,当用户滑动的过程中在去加载新的数据,同时会自动销毁 ...
- java-设计模式汇总整理
最近,对各种模式做了一个整理,便于后续自用. 1.工厂模式 总结:很好理解,一个接口,2个类实现这个接口,那么可以用“接口 变量=new 接口实现类”的方式调用不同的实现类,调用方式直接使用接口的方法 ...
- Arduino I2C + 温湿度传感器AM2321
(2015.5.17:本日志的内容有所更新,参见<使用Arduino Wire Library读取温湿度传感器AM2321>.) AM2321是广州奥松电子生产的数字式温湿度传感器.虽是国 ...
- 转:javascript判断IE浏览器
http://blog.csdn.net/ranbolwb/article/details/18555847 function isIE() { //ie? if (!!window.ActiveXO ...
- Robot Framework资料
https://www.cnblogs.com/pachongshangdexuebi/category/981644.html 虫师 :http://www.cnblogs.com/fnng/ ...
- javaScript prototype实例(正则) 自定义日期格式化方法
一个JS自定义日期格式化方法,包括了不少知识点,以下方法来自jQuery DataTable中文的官方参考 //return (new Date(data)).Format("yyyy-MM ...
- Performance profile of a typical interior scene
------------------------------- Num faces: 7000k+ Num lights: 38 Num textures: 79 Textures on disk: ...
- oracle所有的乱码解决方案
oracle所有的乱码解决方案 是不是经常看见各式各样的乱码,看见头就大了,大家别怕,所有的问题都会有一个甚至不止一个的解决方案,有句名言说的好:万法不离其踪.网上大部分把工具的乱码和代码操作的乱码混 ...
- react-dnd使用介绍
核心API 想要灵活使用,就先知道几个核心API DragSource 用于包装你需要拖动的组件,使组件能够被拖拽(make it draggable) DropTarget 用于包装接收拖拽元素的组 ...