
Python网络爬虫实战(二)数据解析
上一篇说完了如何爬取一个网页,以及爬取中可能遇到的几个问题。那么接下来我们就需要对已经爬取下来的网页进行解析,从中提取出我们想要的数据。
根据爬取下来的数据,我们需要写不同的解析方式,最常见的一般都是HTML数据,也就是网页的源码,还有一些可能是Json数据,Json数据是一种轻量级的数据交换格式,相对来说容易解析,它的格式如下。
{

    "name": "中国",

    "province": [{

        "name": "黑龙江",

        "cities": {

            "city": ["哈尔滨", "大庆"]

        }

    }, {

        "name": "广东",

        "cities": {

            "city": ["广州", "深圳", "珠海"]

        }

    }, {

        "name": "台湾",

        "cities": {

            "city": ["台北", "高雄"]

        }

    }, {

        "name": "新疆",

        "cities": {

            "city": ["乌鲁木齐"]

        }

    }]

}
上一篇说到的爬取携程加载不出来的那部分数据就是异步请求Json返回给我们的,对于这类数据,Python有着十分便捷的解析库,所以我们相对不用写多少代码。
但是对于爬取下来是一个HTML数据,其中标签结构可能十分复杂,而且不同HTML的结构可能存在差异,所以解析方式也需要看情况而定。
相对方便的解析方式有正则表达式,xPath和BeautifulSoup4库。
三者的运行速度相比当然是正则表达式最快,xPath其次,Bs4最慢了,因为Bs4是经过封装的库,相对于另外两个,无疑是重装坦克一般,但Bs4确实使用最简单的一个,而正则表达式是最麻烦的一个。
正则表达式几乎所有编程语言都支持,每一种语言的正则表达式都存在一点差异但大同小异。如果你是在设计一个复杂系统,就不要考虑正则表达式了,因为这种方法太过于不稳定,你永远不敢保证你写的正则规则是对应当前系统完全不会报错的。
xPath 是一门在XML文档中查找信息的语言。xPath可用来在XML文档中对元素和属性进行遍历。
关于正则表达式和xPath在之后的实战中再做详解,现在主要是掌握Bs4的使用。
我们首先需要下载Bs4的库。
pip install lxml

pip install beautifulsoup4
当我们爬取下来一整个网页的HTML之后,Bs4就可以根据标签的相对定位来找准你要爬取的数据了。
这个相对定位类似于如下:
body > div.banner > div > div.celeInfo-right.clearfix > div.movie-stats-container > div > div > span > span
可以理解把HTML页面当做洋葱一层一层剥开。
这种定位叫做selector,我们可以不用自己编写它,比较HTML结构可能比较复杂,很容易写错。
我们可以打开浏览器的控制台(F12),然后Elements里面找到我们想要爬取之后解析的内容,这时候你鼠标放上去的位置对应页面内容会变成蓝色让你来对比,如下图。
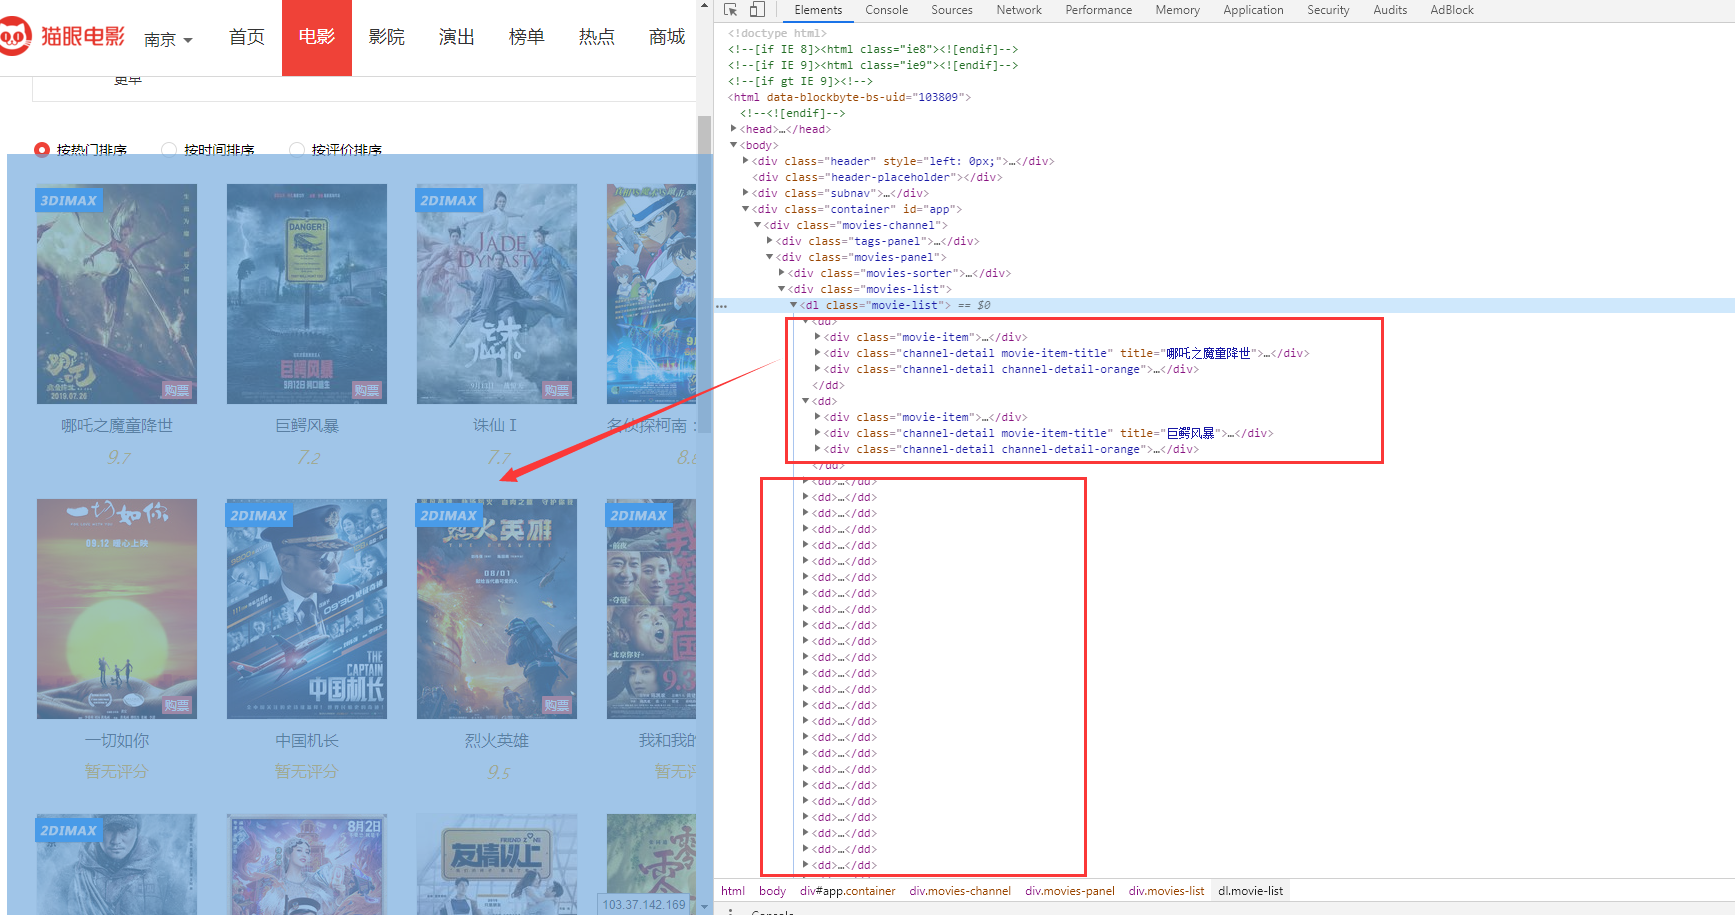
可以发现,这些dd标签里面就是当前页面所有的电影信息了。哪吒之魔童降世你可以理解为dd-1,巨鳄风暴可以当做dd-2,以此类推。
然后你把鼠标放在dd标签上右键,会有一个copy选项,里面有一个selector,就是将它的selector复制下来。
下面分别是哪吒之魔童降世和巨鳄风暴的selector,可以发现,只有最后的dd:nth-child不同。
#app > div > div.movies-panel > div.movies-list > dl > dd:nth-child(1)

#app > div > div.movies-panel > div.movies-list > dl > dd:nth-child(2)
有了这个规律,我们就可以很容易的一次性解析那种列表型网页了。
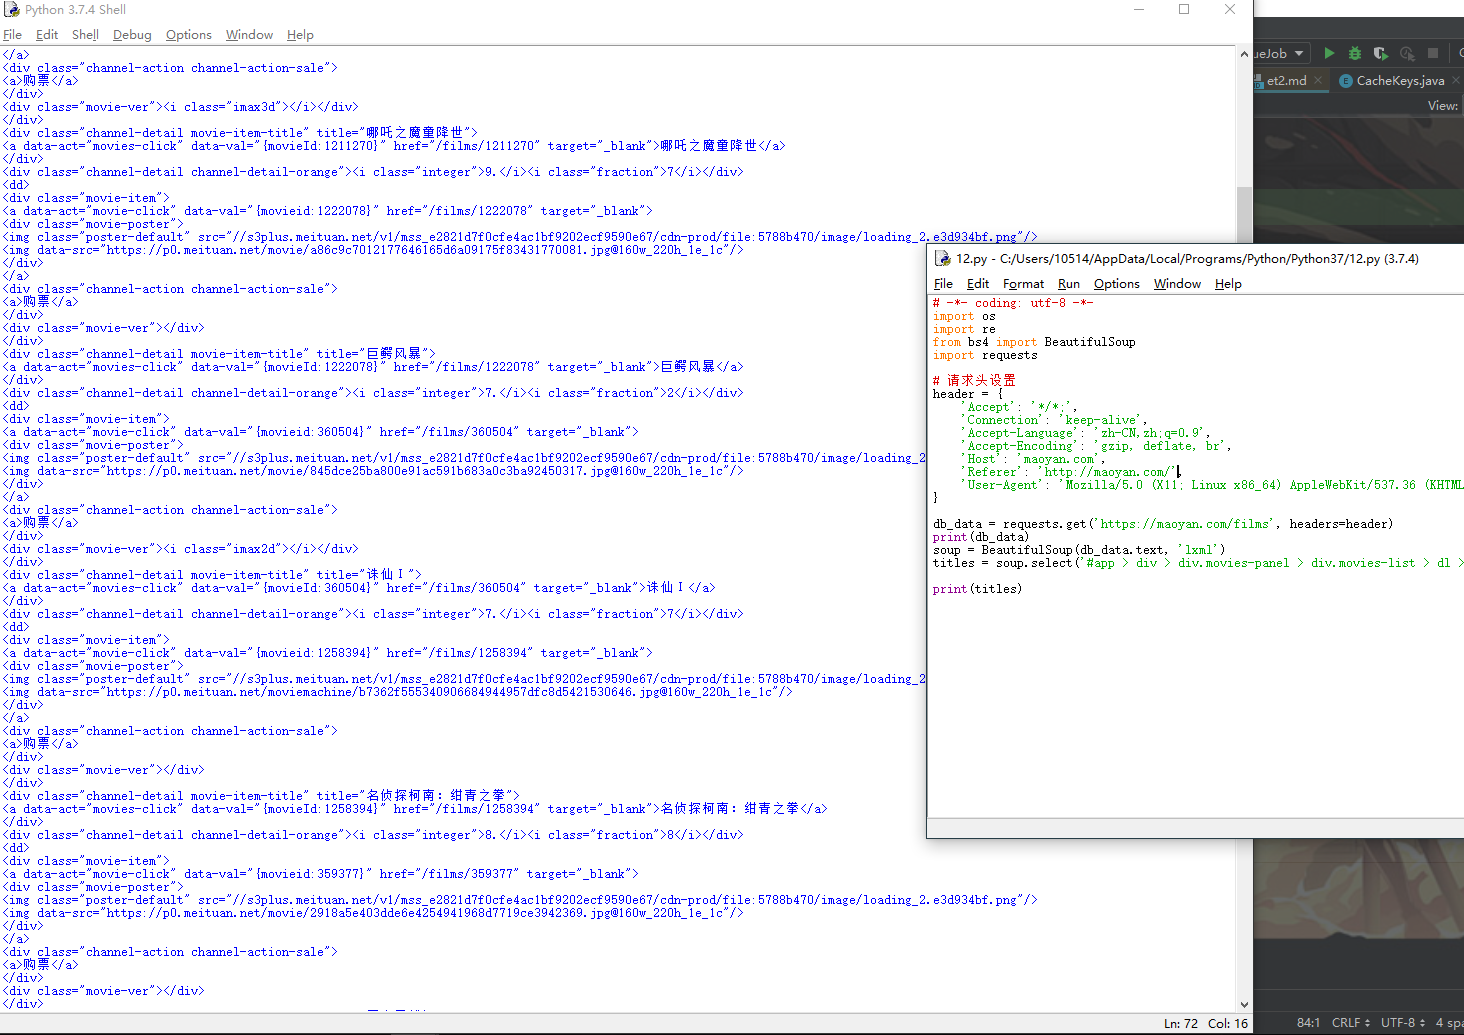
# -*- coding: utf-8 -*-

import os

import re

from bs4 import BeautifulSoup

import requests

# 请求头设置

header = {

    'Accept': '*/*;',

    'Connection': 'keep-alive',

    'Accept-Language': 'zh-CN,zh;q=0.9',

    'Accept-Encoding': 'gzip, deflate, br',

    'Host': 'maoyan.com',

    'Referer': 'http://maoyan.com/',

    'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.87 Safari/537.36'

}

data = requests.get('https://maoyan.com/films', headers=header)

soup = BeautifulSoup(data.text, 'lxml')

titles = soup.select('#app > div > div.movies-panel > div.movies-list > dl > dd ')

print(titles)
来仔细讲解一下上面这些代码。
request.get(url,headers)是昨天说过的了,headers就是请求头信息,里面包含了我们客户端的信息以及请求方式是Get还是Post等。
返回的data就是响应了,你可以直接print这个数据,但是这个响应体里面不止包含网页的HTML,还有这次请求的相关数据,比如响应码,200说明成功,404说明没有找到资源等。
data.text就是从响应体中拿到网页HTML代码了。
BeautifulSoup就是我们的主要解析对象,lxml是相应的解析方式。
通过调用BeautifulSoup的select选择器方法,来从之前传入的HTML中获取相应的标签。
这么一看其实Bs4还是很简单的,但这只是Bs4的基础应用了,对于我们普通解析一个网页已经足够用了,如果感兴趣可以去深入去了解一下,不过这个这么说也只是工具库,如果你不嫌麻烦可以自己解析。
看完代码,如果现在我要拿到这个页面的电影名称,这时候上面这个selector就不能用了,因为它不够精确,它只到了'
用这个selector。

#app > div > div.movies-panel > div.movies-list > dl > dd:nth-child(1) > div.channel-detail.movie-item-title > a
其它方式几乎都大同小异了。
以上是HTML的解析,我们爬取的数据有时还会是Json数据,这类数据相对来说十分规则,我倒是很希望目标数据会是Json格式。
比如上篇中的携程。
它的航班信息就是请求Json返回的。
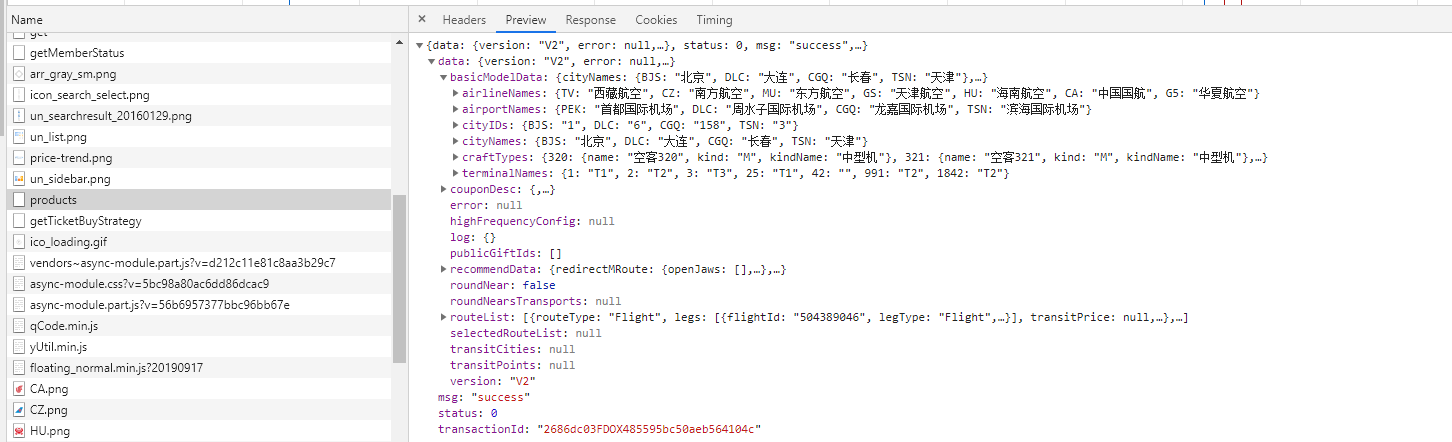
Python中正则表达式的解析十分简单,你把它当做字典数据类型就可以了。
最开始你获得的Json是一串字符串,通过Python的Json.loads(jsonData)之后,返回的其实就是字典数据类型,直接操作就可以了。
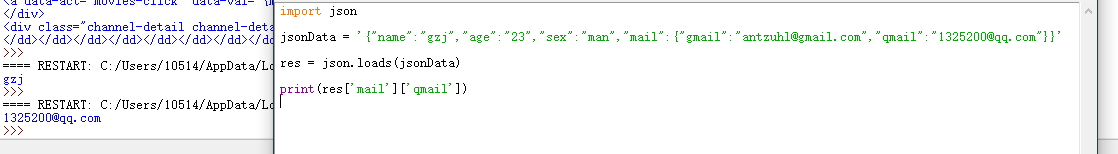
import json

jsonData = '{

        "name":"gzj",

        "age":"23",

        "sex":"man",

        "mail":{

            "gmail":"antzuhl@gmail.com",

            "qmail":"1325200@qq.com"

            }

        }'

res = json.loads(jsonData)

print(res['mail']['qmail'])
(最近在想实战部分要不要录视频和文章两部分,欢迎关注公众号来康康!)
Python网络爬虫实战(二)数据解析的更多相关文章
- 05.Python网络爬虫之三种数据解析方式
引入 回顾requests实现数据爬取的流程 指定url 基于requests模块发起请求 获取响应对象中的数据 进行持久化存储 其实,在上述流程中还需要较为重要的一步,就是在持久化存储之前需要进行指 ...
- 05,Python网络爬虫之三种数据解析方式
回顾requests实现数据爬取的流程 指定url 基于requests模块发起请求 获取响应对象中的数据 进行持久化存储 其实,在上述流程中还需要较为重要的一步,就是在持久化存储之前需要进行指定数据 ...
- 《Python网络爬虫之三种数据解析方式》
引入 回顾requests实现数据爬取的流程 指定url 基于requests模块发起请求 获取响应对象中的数据 进行持久化存储 其实,在上述流程中还需要较为重要的一步,就是在持久化存储之前需要进行指 ...
- Python网络爬虫之三种数据解析方式 (xpath, 正则, bs4)
引入 回顾requests实现数据爬取的流程 指定url 基于requests模块发起请求 获取响应对象中的数据 进行持久化存储 其实,在上述流程中还需要较为重要的一步,就是在持久化存储之前需要进行指 ...
- Python网络爬虫之三种数据解析方式
1. 正则解析 正则例题 import re # string1 = """<div>静夜思 # 窗前明月光 # 疑是地上霜 # 举头望明月 # 低头思故乡 ...
- python网络爬虫实战PDF高清完整版免费下载|百度云盘|Python基础教程免费电子书
点击获取提取码:vg1y python网络爬虫实战帮助读者学习Python并开发出符合自己要求的网络爬虫.网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动地抓取互联网信息的程序或者脚 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- Python网络爬虫实战(一)快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
- python网络爬虫实战之快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
随机推荐
- JS DOM(文档对象模型)与BOM(浏览器对象模型)
在JS中,对DOM(Document Object Model)对象和BOM(Browser Object Model )对象的操作是非常重要的内容.DOM主要包括HTML文档的属性和方法,像对HTM ...
- JavaWeb——JSP开发2
使用JSP+Servlet实现文件的上传和下载功能 1.文件模型 首先是文件本身,这里创建一个类记录文件的名字和内容: public class Attachment { private String ...
- exe4j打包--jar打包exe
本文重点介绍如何将我们写的java代码打包成在电脑上可以运行的exe文件.这里只介绍直接打包成exe的方法,至于打包成exe安装包下节介绍 test 软件准备 exe4j集合包下载地址(下节内容也在这 ...
- CMake入门-02-HelloWorld扩展
工作环境 系统:macOS Mojave 10.14.6 CMake: Version 3.15.0-rc4 Hello,World! 扩展-同一目录,多个源文件 (1) 新建 hello 目录,创建 ...
- 《机器学习技法》---GBDT
1 对决策树使用adaboost 对决策树使用adaboost时,有以下几个问题: (1)adaboost每次更新的样本权重如何应用到决策树中? 由于我们不知道决策树的err目标是什么,因此通常的方法 ...
- https理论及实践
什么是https协议? http协议以明文的方式在网络中传输,安全性难以保证,https在http协议的基础上加入SSL/TLS层.TLS是SSL协议的最新版本,SSL使用SSL数字证书在通信两端建立 ...
- SQL Server检索存储过程的结果集
目的:检索过滤执行存储过程的结果集 如下介绍两个常用的方法,但是都需要申明表结构:不知道是否有更简便的方法,如有更好的方法,请不吝赐教. 以系统存储过程sp_who2为例: 方法1:使用临时表 --1 ...
- 【改革春风吹满地 HDU - 2036 】【计算几何-----利用叉积计算多边形的面积】
利用叉积计算多边形的面积 我们都知道计算三角形的面积时可以用两个邻边对应向量积(叉积)的绝对值的一半表示,那么同样,对于多边形,我们可以以多边形上的一个点为源点,作过该点并且过多边形其他点中的某一个的 ...
- pip3 Traceback (most recent call last)错误调试
百度找的答案不知道是否正确反正不适用于deepin,就手动调试了一下,结果修复了原理不清楚. 调试环境: OS:deepin 15.11 Python3-pip 错误提示: python@python ...
- C# NAudio录音和播放音频文件-实时绘制音频波形图(从音频流数据获取,而非设备获取)
NAudio的录音和播放录音都有对应的类,我在使用Wav格式进行录音和播放录音时使用的类时WaveIn和WaveOut,这两个类是对功能的回调和一些事件触发. 在WaveIn和WaveOut之外还有对 ...