
Python之Beautiful Soup 4使用实例
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库,它能够通过你喜欢的转换器实现惯用的文档导航、查找、修改文档的方式。
Beautiful Soup 4 官方文档:https://www.crummy.com/software/BeautifulSoup/bs4/doc.zh/
一、安装Beautiful Soup
运行cmd,cd切换到python安装目录下的Scripts目录,执行命令
pip3 install beautifulsoup4
二、安装解析器lxml
Beautiful Soup支持Python标准库中的HTML解析器,也支持一些第三方的解析器,推荐用lxml,速度快,文档容错能力强,需要安装。
pip3 install lxml
三、使用实例
下面测试抓取博客园首页一些信息
1、简单信息的抓取
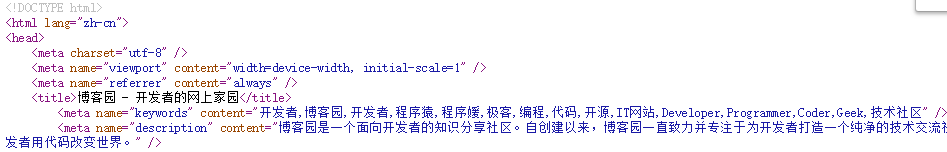
import re

import requests

from bs4 import BeautifulSoup

r = requests.get('https://www.cnblogs.com')

soup = BeautifulSoup(r.text, 'lxml') #lxml为解析器

print(soup.title, soup.title.string) #获取指定标签,获取指定标签里面的内容

print(soup('title'), soup('title')[0].string) #获取指定标签也可以写成这样

print(soup.meta.get('charset')) #获取指定标签的属性

print(soup.meta['charset']) #获取指定标签的属性也可写成这样

print(soup.meta) #获取第一个标签(多个只取第一个)

print(soup.find('meta')) #获取第一个标签,结果和上面一样

print(soup.find('meta', attrs={'name':'viewport'})) #获取第一个标签,根据属性过滤获取

print(soup.find_all('meta', attrs={'charset':True})) #获取所有标签的列表,同时根据是否含有属性charset过滤获取
运行结果:
<title>博客园 - 开发者的网上家园</title> 博客园 - 开发者的网上家园

[<title>博客园 - 开发者的网上家园</title>] 博客园 - 开发者的网上家园

utf-8

utf-8

<meta charset="utf-8"/>

<meta charset="utf-8"/>

<meta content="width=device-width, initial-scale=1" name="viewport"/>

[<meta charset="utf-8"/>]
2、抓取首页的导航条信息

print('抓取导航,实现方法1')

for item in soup.select('div#nav_menu a'):

    print(item.get('href'), item.string)

print('抓取导航,实现方法2')

for item in soup.find('div', {'id':'nav_menu'}).children:

    print(item['href'], item.string)
运行结果:
抓取导航,实现方法1

https://home.cnblogs.com/ 园子

https://news.cnblogs.com 新闻

https://q.cnblogs.com/ 博问

https://ing.cnblogs.com/ 闪存

https://group.cnblogs.com/ 小组

https://wz.cnblogs.com/ 收藏

https://job.cnblogs.com/ 招聘

https://edu.cnblogs.com/ 班级

http://zzk.cnblogs.com/ 找找看

抓取导航,实现方法2

https://home.cnblogs.com/ 园子

https://news.cnblogs.com 新闻

https://q.cnblogs.com/ 博问

https://ing.cnblogs.com/ 闪存

https://group.cnblogs.com/ 小组

https://wz.cnblogs.com/ 收藏

https://job.cnblogs.com/ 招聘

https://edu.cnblogs.com/ 班级

http://zzk.cnblogs.com/ 找找看
3、抓取网站分类
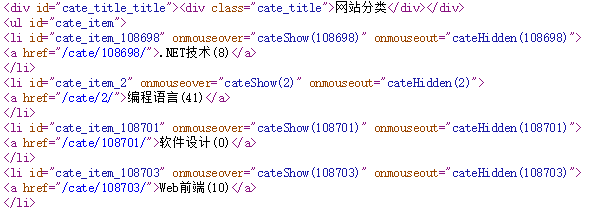
print('抓取网站分类,实现方法1')

for item in soup.select('ul#cate_item li'):

    print(item.find('a').get('href'),item.find('a').string)

print('抓取网站分类,实现方法2')

for item in soup.find_all(id=re.compile('^cate_item_')):

    print(item.find('a').get('href'),item.find('a').string)
运行结果:
抓取网站分类,实现方法1

/cate/108698/ .NET技术(8)

/cate/2/ 编程语言(41)

/cate/108701/ 软件设计(0)

/cate/108703/ Web前端(10)

/cate/108704/ 企业信息化(0)

/cate/108705/ 手机开发(3)

/cate/108709/ 软件工程(0)

/cate/108712/ 数据库技术(9)

/cate/108724/ 操作系统(9)

/cate/4/ 其他分类(16)

/cate/all/ 所有随笔(1571)

/comment/ 所有评论(491)

抓取网站分类,实现方法2

/cate/108698/ .NET技术(8)

/cate/2/ 编程语言(41)

/cate/108701/ 软件设计(0)

/cate/108703/ Web前端(10)

/cate/108704/ 企业信息化(0)

/cate/108705/ 手机开发(3)

/cate/108709/ 软件工程(0)

/cate/108712/ 数据库技术(9)

/cate/108724/ 操作系统(9)

/cate/4/ 其他分类(16)

/cate/all/ 所有随笔(1571)

/comment/ 所有评论(491)
4、抓取首页的所有随笔信息
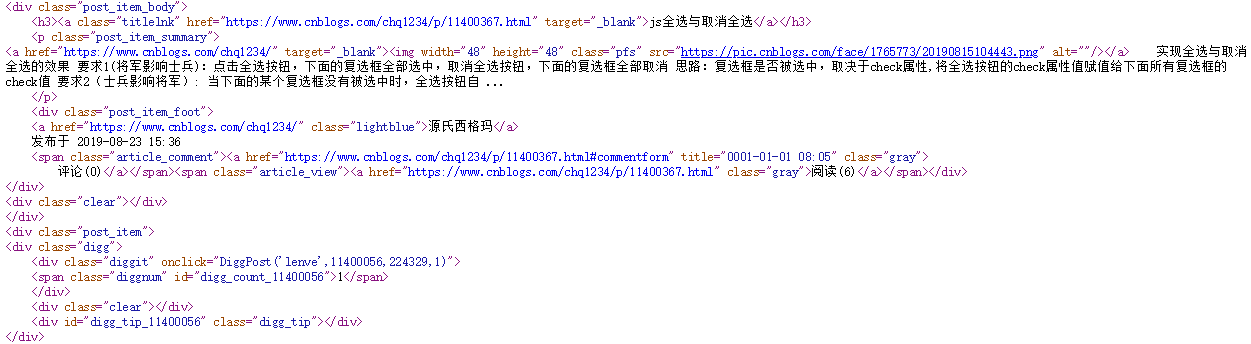
print('抓取随笔信息')

post_item_body = soup.find_all('div', 'post_item_body')

for item in post_item_body:

    print(item.h3.a['href'])

    print(item.h3.a.string)

    print(item.p.get_text().strip())

    print(item.div.a.string)

    print(item.div.a.next_sibling.replace('发布于','').strip())
运行结果:
抓取随笔信息

https://www.cnblogs.com/chq1234/p/11400367.html

js全选与取消全选

实现全选与取消全选的效果 要求1(将军影响士兵):点击全选按钮,下面的复选框全部选中,取消全选按钮,下面的复选框全部取消 思路:复选框是否被选中,取决于check属性,将全选按钮的check属性值赋值给下面所有复选框的check值 要求2(士兵影响将军): 当下面的某个复选框没有被选中时,全选按钮自 ...

源氏西格玛

2019-08-23 15:36

https://www.cnblogs.com/lenve/p/11400056.html

40 篇原创干货,带你进入 Spring Boot 殿堂!

两个月前,松哥总结过一次已经完成的 Spring Boot 教程,当时感受到了小伙伴们巨大的热情。 两个月过去了,松哥的 Spring Boot 教程又更新了不少,为了方便小伙伴们查找,这里再给大家做一个索引参考。 需要再次说明的是,这一系列教程不是终点,而是一个起点,松哥后期还会不断完善这个教程, ...

江南一点雨

2019-08-23 14:58

.....................后面内容太长了省略....................
Python之Beautiful Soup 4使用实例的更多相关文章
- python爬虫之Beautiful Soup基础知识+实例
python爬虫之Beautiful Soup基础知识 Beautiful Soup是一个可以从HTML或XML文件中提取数据的python库.它能通过你喜欢的转换器实现惯用的文档导航,查找,修改文档 ...
- Python之Beautiful Soup的用法
1. Beautiful Soup的简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.pyt ...
- Python的Beautiful Soup简单使用
Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据 Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索.修改分析树等功能 它是一个工具箱, ...
- 【python】Beautiful Soup的使用
1. Beautiful Soup的简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.pyt ...
- python之Beautiful Soup库
1.简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索 ...
- 20181223 python 使用Beautiful Soup
(这篇,没什么营养价值) 怎么说呢! 爬虫吧!把html页面进行解析得到有效数据,而beautiful soup 能快速格式化页面再进行方法对数进行提取,存入想要存入的DB中. from bs4 im ...
- Python爬虫利器:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.使用它来处理HTML页面就像JavaScript代码操作HTML DOM树一样方便.官方中文文档地址 1. 安 ...
- Python爬虫之Beautiful Soup解析库的使用(五)
Python爬虫之Beautiful Soup解析库的使用 Beautiful Soup-介绍 Python第三方库,用于从HTML或XML中提取数据官方:http://www.crummv.com/ ...
- 吴裕雄--天生自然python学习笔记:Beautiful Soup 4.2.0模块
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时 ...
随机推荐
- Spring Boot 2.2.2.RELEASE 版本中文参考文档
写在前面 在我初次接触MongoDB的时候,是为了做一个监控系统和日志分析系统.当时在用Java操作MongoDB数据里的数据的时候,都是在网上查找Demo示例然后完成的功能,相信大家也同样的体会,网 ...
- 关于vue-detools chorme创建安装完成,但是控制台不显示问题
搜了一下发现挺多人遇到这个问题的,绝大多数的回答都是在main.js中添加下面代码 Vue.config.devtools = true; 但是发现并不行. 后来看到有人说刷新然后在按F12就好了,居 ...
- Android Gradle 学习笔记(三):Gradle 日志
在第一节,我们使用到了gradle -q hello命令行来运行Hello World,并对Hello World进行了简单的分析,了解到 gradle -q hello 的意思是要执行的build. ...
- NTP and Chrony在RHEL
在RHEL7上,Chrony已经代替了NTP来做时间同步服务. 1 服务器上操作 yum -y install chrony vim /etc/chrony.conf # Allow NTP clie ...
- ubuntu 安装精简桌面; VNC; vncserver 配置
安装最简单的环境: apt-get install gnome-shell apt-get install gnome-panel apt-get install gnome-menus ...
- 二、ITK例子-jpg图像读写
一.ITK的读写工作原理 在ITK里面,我们需要设置读取图像的像素类型,图像类型. 然后设置读取指针,将读取参数传入. 同时设置写指针,也将写入文件参数传入. 为了实现读写动作,我们需要构造一个IO工 ...
- Java实战|Tomcat+Servlet+Sql开发简单网站,从配置环境开始
课题描述: Java实验五 Servlet (继续使用实验四中创建的students数据库和其中的scores表) 使用Tomcat作为Web服务器和Servlet容器,使用SQL Server/My ...
- vue项目搭建及创建、目录结构、项目启动、全局配置
Vue项目环境搭建 """ node ~~ python:node是用c++编写用来运行js代码的 npm(cnpm) ~~ pip:npm是一个终端应用商城,可以换国内 ...
- 《3D_Deep_Learning_for_Robot_Perception.pdf》
https://github.com/PrincetonVision/marvin
- Java并发编程:Java中的锁和线程同步机制
锁的基础知识 锁的类型 锁从宏观上分类,只分为两种:悲观锁与乐观锁. 乐观锁 乐观锁是一种乐观思想,即认为读多写少,遇到并发写的可能性低,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新 ...