
flume安装配置
1 下载安装包并解压
下载地址:http://flume.apache.org/download.html
解压:tar zxvf apache-flume-1.8.0-bin.tar.gz
2 配置环境变量
vi ~/.bashrc
配置环境变量:
export FLUME_HOME=/hmaster/flume/apache-flume-1.8.0-bin
export FLUME_CONF_DIR=$FLUME_HOME/con
export PATH=$PATH:$FLUME_HOME/bin
让配置生效
source ..bashrc
配置flume-env.sh文件的JavaHome
export JAVA_HOME=/hmaster/javaenv/jdk1.8.0_181
3 Flume部署示例
1 Avro
在/hmaster/flume/apache-flume-1.8.0-bin/conf目录下新建netcat.conf配置文件
Flume可以通过Avro监听某个端口并捕获传输的数据,具体配置示例如下:
#那么我们也给这个三个组件分别取名字
a2.sources = r1
a2.channels = c1
a2.sinks = k1
#定义具体的source内容
#这里是执行命令以及下面对应的具体命令
#这个命令执行后的数据返回给这个source
a1.sources.r1.type = netcat
a1.sources.r1.bind = localhost
a1.sources.r1.port = 44444
#定义具体的channel信息
#我们source定义好了,就要来定义我们的channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 10000
a2.channels.c1.transactionCapacity = 100
#定义具体的sink信息
#这个logger sink,就是将信息直接打印到控制台
#就是打印日志
a2.sinks.k1.type = logger
#最后来组装我们之前定义的channel和sink
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
运行FlumeAgent,监听本机的44444端口
-n 后面对应agent名称
-c 配置文件目录
-f 配置文件地址
flume-ng agent -n a1 -c conf -f ../conf/netcat.conf

// 打开另一终端,通过telnet登录localhost的44444,输入测试数据
$ telnet localhost 44444
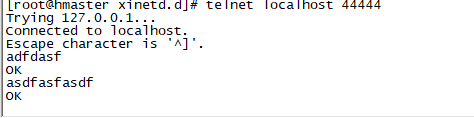
// 查看flume收集数据情况

2 Spool
1 配置spool.conf用于监控目录userlogs 的文件,将文件内容发送到本地60000端口
Spool用于监测配置的目录下新增的文件,并将文件中的数据读取出来。需要注意两点:拷贝到spool目录下的文件不可以再打开编辑、spool目录下不可包含相应的子目录。具体配置文件示例如下
#定义agent名称,source,channel,sink的名称
#a1就是我们给agent起的名字,我们知道有多个agent,那么我们就是通过这个来进行区别
#我们知道agent包含了三个重要的组件,有source,channel,sink
#那么我们也给这个三个组件分别取名字
a2.sources = r1
a2.channels = c1
a2.sinks = k1
#定义具体的source内容
#这里是执行命令以及下面对应的具体命令
#这个命令执行后的数据返回给这个source
a2.sources.r1.type = spooldir
a2.sources.r1.spoolDir = /home/hadoop/hadoop-2.9.0/userlogs
#定义具体的channel信息
#我们source定义好了,就要来定义我们的channel
a2.channels.c1.type = memory
a2.channels.c1.capacity = 10000
a2.channels.c1.transactionCapacity = 100
#定义具体的sink信息
#就是将数据转换成Avro Event 然后发送到配置的rpc端口上
a2.sinks.k1.type = avro
a2.sinks.k1.hostname= localhost
a2.sinks.k1.port= 60000
#最后来组装我们之前定义的channel和sink
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
2 配置spool2.conf用于从本地60000端口获取数据并写入HDFS
#定义agent名称,source,channel,sink的名称
a3.sources = r1
a3.channels = c1
a3.sinks = k1
#定义具体的source内容
a3.sources.r1.type= avro
a3.sources.r1.bind= localhost
a3.sources.r1.port= 60000
#定义具体的channel信息
#我们source定义好了,就要来定义我们的channel
a3.channels.c1.type = memory
a3.channels.c1.capacity = 10000
a3.channels.c1.transactionCapacity = 100
#定义具体的sink信息
a3.sinks.k1.type = hdfs
a3.sinks.k1.hdfs.path = hdfs://192.168.79.2:9000/flume/event2
a3.sinks.k1.hdfs.filePrefix = events-
a3.sinks.k1.hdfs.fileType = DataStream
#最后来组装我们之前定义的channel和sink
a3.sources.r1.channels = c1
a3.sinks.k1.channel = c1
flume安装配置的更多相关文章
- Flume篇---Flume安装配置与相关使用
一.前述 Copy过来一段介绍Apache Flume 是一个从可以收集例如日志,事件等数据资源,并将这些数量庞大的数据从各项数据资源中集中起来存储的工具/服务,或者数集中机制.flume具有高可用, ...
- 具体图解 Flume介绍、安装配置
写在前面一: 本文总结"Hadoop生态系统"中的当中一员--Apache Flume 写在前面二: 所用软件说明: 一.什么是Apache Flume 官网:Flume is a ...
- Flume简介与使用(一)——Flume安装与配置
Flume简介与使用(一)——Flume安装与配置 Flume简介 Flume是一个分布式的.可靠的.实用的服务——从不同的数据源高效的采集.整合.移动海量数据. 分布式:可以多台机器同时运行采集数据 ...
- flume安装及配置
Flume安装 介绍 Flume本身的安装比较简单(flume的介绍请参考http://blog.csdn.net/rzhzhz/article/details/7448633),安装前先说明几个概念 ...
- 01 Flume系列(一)安装配置
01 Flume系列(一)安装配置 Flume(http://flume.apache.org/) is a distributed, reliable, and available service ...
- CentOS6安装各种大数据软件 第七章:Flume安装与配置
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- 3.flume安装以及环境配置
1.安装jdk 我这里已经安装过了,这里就不演示了 2.安装flume 安装cdh版本的,http://archive.cloudera.com/cdh5/cdh/5/ 安装完毕之后,配置环境变量. ...
- FLUME安装&环境(一):netcat类型配置
1.下载软件 在 /opt/deploy 下新建 flume 文件夹: # mkdir / opt/deploy / flume 到Flume官网上http://flume.apache.org/do ...
- Linux安装配置Flume
概述 Apache Flume是一个分布式,可靠且可用的系统,用于高效地收集,汇总和将来自多个不同源的大量日志数据移动到集中式数据存储.Apache Flume的使用不仅限于日志数据聚合.由于数据源是 ...
随机推荐
- HFun.快速开发平台(二)=》自定义列表实例
应用系统中数据列表的展现是开发内容之一,实现的方式基本是通过编号具体的访问列表页实现,通过检索条件进行数据源的获取,列字段的描述,还可能会有检索条件的实现,列表数据的导出等功能. 为了将重复工作进行简 ...
- mongodb数据迁移到hbase
mongodb数据迁移到hbase 导入包 # encoding: utf-8 ''' @author: zcc @license: (C) Copyright 2013-2017, Node Sup ...
- Python随笔--Pickle
遇到问题:不能文件名为pickle.py
- BatchPreparedStatementSetter,用法
spring批量更新数据 ---- BatchPreparedStatementSetter (2007-04-15 15:41:29) 转载▼ 标签: spring batchpreparedsta ...
- 实训任务04 MapReduce编程入门
实训任务04 MapReduce编程入门 1.实训1:画图mapReduce处理过程 使用有短句“A friend in need is a friend in deed”,画出使用MapReduce ...
- Echarts扩展地图文字位置错乱的问题
最近在弄echarts 因为要用到扩展地图,所以在官网下载了相应的json文件 ,引入之后发现文字位置错乱 于是查找网上资料 发现 textFixed : { ...
- hbase 概念
在hbase里面有几个通俗的名称会经常出现 1)Hregion = region 2)Hregionserver = regionserver 3)Hmaster = master 4)Hmamsto ...
- VGG网络结构
这个结构其实不难,但是它里面训练的一些东西我还没有搞清楚,打算把昨天写的代码传上来,方便日后来看,发现了一个很有意思的库叫TF-slim打算哪天看看有没有好用的东西 from datetime imp ...
- Tensorflow实战系列之五:
打算写实例分割的实战,类似mask-rcnn. Tensorflow实战先写五个系列吧,后面新的技术再添加~~
- BluePrism初尝2
在接近三周的自学中,初步体验到了RPA的甜头. 在对BP这个工具慢慢的深入接触中,从0 到1的探索式学习,从最开始的一个个的小功能模块的用途,每一个的属性的功能,到现在自己能初步尝试组织一些简单的流程 ...