
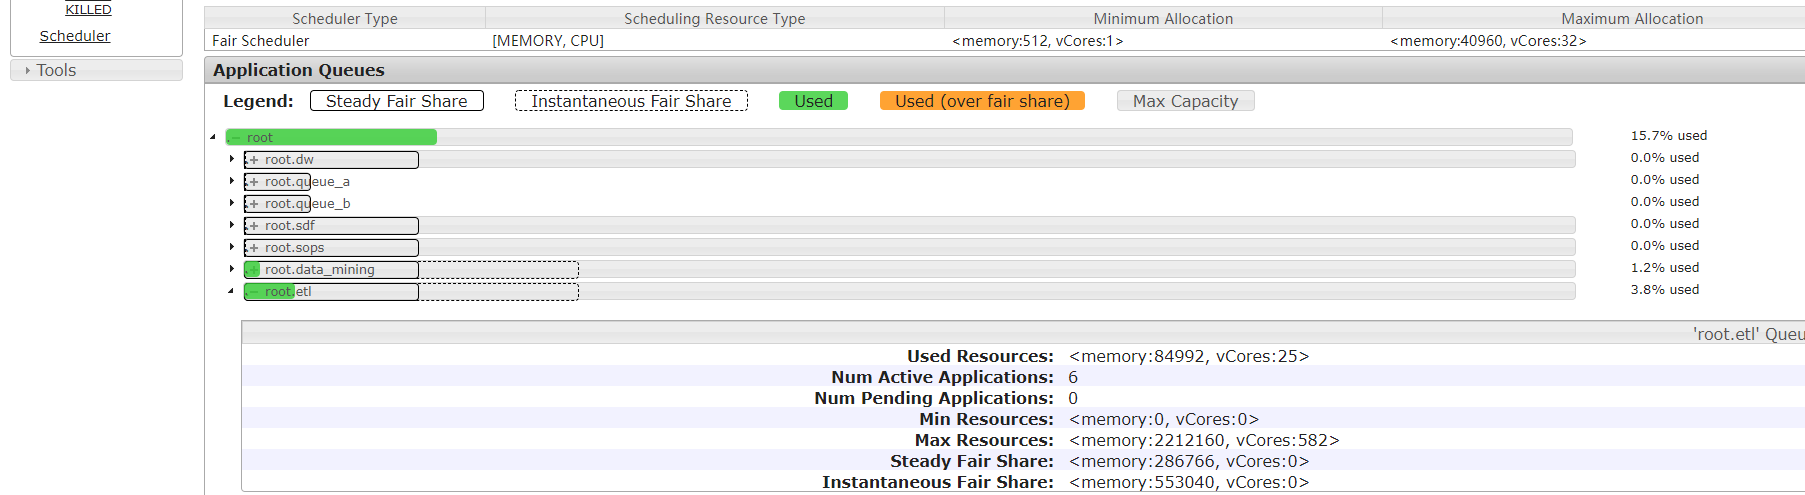
Hadoop记录-fair公平调度队列管理
<?xml version="1.0"?>

<allocations>

  <queue name="root">

      <queue name="default">

        <minResources>2048 mb,4 vcores</minResources>

        <maxResources>2000000 mb,660 vcores</maxResources>

        <maxRunningApps>80</maxRunningApps>

        <aclSubmitApps>*</aclSubmitApps>

        <weight>2.0</weight>

        <schedulingMode>fair</schedulingMode>

      </queue>

      <queue name="queue_a">

        <minResources>2048 mb,4 vcores</minResources>

        <maxResources>102400 mb,148 vcores</maxResources>

        <maxRunningApps>50</maxRunningApps>

        <aclSubmitApps>*</aclSubmitApps>

        <weight>2.0</weight>

        <schedulingMode>fair</schedulingMode>

      </queue>

      <queue name="queue_b">

        <minResources>2048 mb,4 vcores</minResources>

        <maxResources>102400 mb,148 vcores</maxResources>

        <maxRunningApps>50</maxRunningApps>

        <aclSubmitApps>*</aclSubmitApps>

        <weight>2.0</weight>

        <schedulingMode>fair</schedulingMode>

      </queue>

  </queue>

</allocations>
beeline -u " jdbc:hive2://10.202.77.201:10000" -n hive -p hive
set hive.execution.engine=tez;
nohup hive --service hiveserver2 &
nohup hive --service metastore &
hive -S -e "select * from xxx" --S静音模式不打印MR2的进度信息 e加载hql查询语句
hive -f test.hql --加载一个hql文件
source test.hql
for f in 'rpm -qa | grep xxx';do rpm -e --nodeps ${f} done;
磁盘空间满了,kill超时太长的job
cd hive/yarn/local1/usercache/hive/appcache
su yarn
yarn application -kill job名
Hadoop记录-fair公平调度队列管理的更多相关文章
- Hadoop记录-MRv2(Yarn)运行机制
1.MRv2结构—Yarn模式运行机制 Client---客户端提交任务 ResourceManager---资源管理 ---Scheduler调度器-资源分配Containers ----在Yarn ...
- hadoop记录-Hadoop参数汇总
Hadoop参数汇总 linux参数 以下参数最好优化一下: 文件描述符ulimit -n 用户最大进程 nproc (hbase需要 hbse book) 关闭swap分区 设置合理的预读取缓冲区 ...
- hadoop学习笔记肆--元数据管理机制
1.首先,认识几个名词 (1).NameNode中读.写.以及DataNode映射等信息叫做“元数据” ,NameNode元数据存放位置有.内存.fsimage.edits log三个位置. (2). ...
- Hadoop记录-hdfs转载
Hadoop 存档 每个文件均按块存储,每个块的元数据存储在namenode的内存中,因此hadoop存储小文件会非常低效.因为大量的小文件会耗尽namenode中的大部分内存.但注意,存储小文件所需 ...
- Hadoop记录-hadoop介绍
1.hadoop是什么? Hadoop 是Apache基金会下一个开源的大数据分布式计算平台,它以分布式文件系统HDFS和MapReduce算法为核心,为用户提供了系统底层细节透明的分布式基础架构. ...
- spark的task调度器(FAIR公平调度算法)
FAIR 调度策略的树结构如下图所示: FAIR 调度策略内存结构 FAIR 模式中有一个 rootPool 和多个子 Pool, 各个子 Pool 中存储着所有待分配的 TaskSetMagage ...
- hadoop记录-hive常见设置
分区表 set hive.exec.dynamic.partition=true; set hive.exec.dynamic.partition.mode=nonstrict;create tabl ...
- Hadoop记录-JMX参数
Yarn metrics参数说明 获取Yarn jmx信息:curl -i http://xxx:8088/jmx Hadoop:service=ResourceManager,name=FSOpDu ...
- Hadoop记录-日常运维操作
1.Active NameNode hang死,未自动切换 #登录当前hang死 Active namenode主机,停止Namenode,触发自动切换.hadoop-daemon.sh stop n ...
随机推荐
- MT【300】余弦的三倍角公式
2017清华大学THUSSAT附加学科测试数学(二测)$\cos^5\dfrac{\pi}{9}+\cos^5\dfrac{5\pi}{9}+\cos^5\dfrac{7\pi}{9}$ 的值为___ ...
- 洛谷CF1071E Rain Protection(计算几何,闵可夫斯基和,凸包,二分答案)
洛谷题目传送门 CF题目传送门 对于这题,我无力吐槽. 虽然式子还是不难想,做法也随便口胡,但是一些鬼畜边界情况就是判不对. 首先显然二分答案. 对于每一个雨滴,它出现的时刻我们的绳子必须落在它上面. ...
- Leetcode 167. 两数之和 II - 输入有序数组 By Python
给定一个已按照升序排列 的有序数组,找到两个数使得它们相加之和等于目标数. 函数应该返回这两个下标值 index1 和 index2,其中 index1 必须小于 index2. 说明: 返回的下标值 ...
- 【BZOJ5288】[HNOI2018]游戏(拓扑排序)
[BZOJ5288][HNOI2018]游戏(拓扑排序) 题面 BZOJ 洛谷 题解 去年省选的时候这题给我乱搞整过去整过去了,也是虐心了.... 所以当然是来讲正儿八经的正确做法啦. 很明显,我们需 ...
- 每天一个Linux命令(03):du命令
du命令 今天找开发定位问题,看到他使用了这个命令,查看文件,之前知道df,所以今天的每天系列把这命令 du命令也是查看使用空间的,但是与df命令不同的是Linux du命令是对文件和目录磁盘使用的空 ...
- 仓鼠找sugar(LCA)
小仓鼠的和他的基(mei)友(zi)sugar住在地下洞穴中,每个节点的编号为1~n.地下洞穴是一个树形结构.这一天小仓鼠打算从从他的卧室(a)到餐厅(b),而他的基友同时要从他的卧室(c)到图书馆( ...
- gradle配置统一管理
配置全局参数 根目录build.gradle文件: 主要关注ext部分 // Top-level build file where you can add configuration options ...
- 【SFA官方译文】:Spring Cloud Data Flow中的ETL
原创: 影宸风洛 SpringForAll社区 昨天 原文链接:https://www.baeldung.com/spring-cloud-data-flow-etl 作者:Norberto Ritz ...
- 洛谷P4070 生成魔咒
题意:给定字符串,求每个前缀的本质不同的子串数量.字符集1e9. 解:在线构造后缀自动机并统计答案. 答案就是∑len[i] - len[fail[i]] 每次增加的时候,至多对三个节点有影响.然而把 ...
- 外显子分析思路总结(Exome Sequencing Analysis review)
趁着周末,大好的日子,总结了一下外显子分析的思路(套路)