
Apache Spark简单介绍、安装及使用
Apache Spark安装及配置(OS X下的Ubuntu虚拟机)
安装 Anaconda
bash Anaconda2-4.1.1-Linux-x86_64.sh
$ sudo apt-get install software-properties-common

$ sudo add-apt-repository ppa:webupd8team/java

$ sudo apt-get update

$ sudo apt-get install oracle-java8-installer
设置JAVA_HOME
gedit .bashrc
JAVA_HOME=/usr/lib/jvm/java-8-oracle

export JAVA_HOME

PATH=$PATH:$JAVA_HOME

export PATH
$ tar -zxvf spark-2.0.0-bin-hadoop2.7.tgz

$ rm spark-2.0.0-bin-hadoop2.7.tgz
gedit .bashrc
export PYSPARK_DRIVER_PYTHON=ipython

export PYSPARK_DRIVER_PYTHON_OPTS=notebook
cd ~/spark-2.0.0-bin-hadoop2.7

./bin/pyspark
Apache Spark简单使用
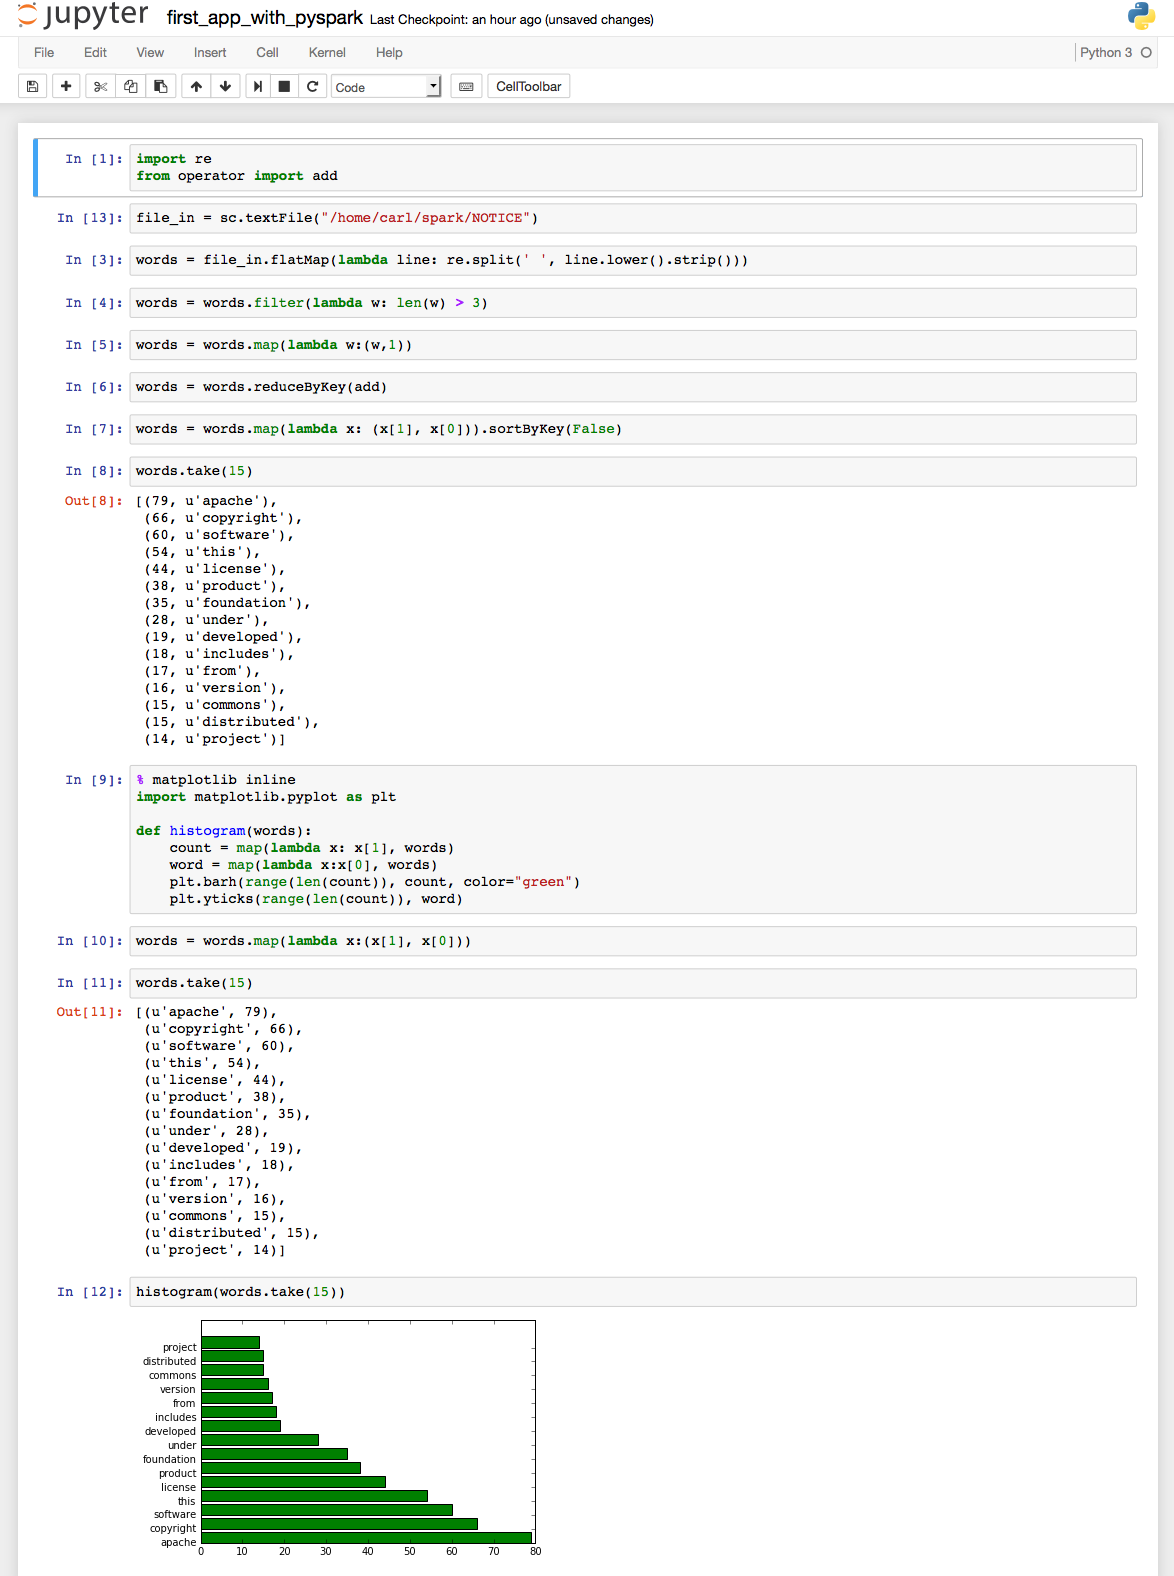
# coding: utf-8

# In[1]:

import re

from operator import add

# In[13]:

file_in = sc.textFile("/home/carl/spark/NOTICE")

# In[3]:

words = file_in.flatMap(lambda line: re.split(' ', line.lower().strip()))

# In[4]:

words = words.filter(lambda w: len(w) > 3)

# In[5]:

words = words.map(lambda w:(w,1))

# In[6]:

words = words.reduceByKey(add)

# In[7]:

words = words.map(lambda x: (x[1], x[0])).sortByKey(False)

# In[8]:

words.take(15)

# In[9]:

get_ipython().magic(u'matplotlib inline')

import matplotlib.pyplot as plt

def histogram(words):

    count = map(lambda x: x[1], words)

    word = map(lambda x:x[0], words)

    plt.barh(range(len(count)), count, color="green")

    plt.yticks(range(len(count)), word)

# In[10]:

words = words.map(lambda x:(x[1], x[0]))

# In[11]:

words.take(15)

# In[12]:

histogram(words.take(15))
如果你对网络爬虫感兴趣,请查看另一篇随笔: 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
Apache Spark简单介绍、安装及使用的更多相关文章
- Spark简单介绍,Windows下安装Scala+Hadoop+Spark运行环境,集成到IDEA中
一.前言 近几年大数据是异常的火爆,今天小编以java开发的身份来会会大数据,提高一下自己的层面! 大数据技术也是有很多: Hadoop Spark Flink 小编也只知道这些了,由于Hadoop, ...
- Mongodb简单介绍安装
具体详细内容,请查阅 Mongodb官方文档 一.简单介绍 MongoDB 是由C++语言编写的,是一个基于分布式文件存储的开源数据库系统. 在高负载的情况下,添加更多的节点,可以保证服务器性能. M ...
- Apache Flume的介绍安装及简单案例
概述 Flume 是 一个高可用的,高可靠的,分布式的海量日志采集.聚合和传输的软件.Flume 的核心是把数据从数据源(source)收集过来,再将收集到的数据送到指定的目的地(sink).为了保证 ...
- 在linux上安装elasticsearch简称ES 简单介绍安装步骤
1.简介 Elasticsearch 是一个分布式可扩展的实时搜索和分析引擎,一个建立在全文搜索引擎 Apache Lucene(TM) 基础上的搜索引擎.当然 Elasticsearch 并不仅仅是 ...
- Spark(二) -- Spark简单介绍
spark是什么? spark开源的类Hadoop MapReduce的通用的并行计算框架 spark基于map reduce算法实现的分布式计算 拥有Hadoop MapReduce所具有的优点 但 ...
- Apache Shiro简单介绍
1. 概念 Apache Shiro 是一个开源安全框架,提供身份验证.授权.密码学和会话管理.Shiro 框架具有直观.易用等特性,同时也能提供健壮的安全性,虽然它的功能不如 SpringSecur ...
- web服务的简单介绍及apache服务的安装
一,web服务的作用: 是指驻留于因特网上某种类型计算机的程序,可以向浏览器等Web客户端提供文档.可以放置网站文件,让全世界浏览: 可以放置数据让全世界下载.目前最主流的三个Web服务器是Ap ...
- 3.如何安装Apache Spark
如何安装Apache Spark 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹 ...
- 分享一个.NET平台开源免费跨平台的大数据分析框架.NET for Apache Spark
今天早上六点半左右微信群里就看到张队发的关于.NET Spark大数据的链接https://devblogs.microsoft.com/dotnet/introducing-net-for-apac ...
随机推荐
- Ubuntu 14.04中Elasticsearch集群配置
Ubuntu 14.04中Elasticsearch集群配置 前言:本文可用于elasticsearch集群搭建参考.细分为elasticsearch.yml配置和系统配置 达到的目的:各台机器配置成 ...
- redux-undo
简介 通过包装reducer,创建一个state History,保留历史state,可以做退一步,进一步操作 1.install npm install --save redux-undo@beta ...
- .Net Core MVC 网站开发(Ninesky) 2.3、项目架构调整-控制反转和依赖注入的使用
再次调整项目架构是因为和群友dezhou的一次聊天,我原来的想法是项目尽量做简单点别搞太复杂了,仅使用了DbContext的注入,其他的也没有写接口耦合度很高.和dezhou聊过之后我仔细考虑了一下, ...
- ASP.NET MVC5+EF6+EasyUI 后台管理系统(66)-MVC WebApi 用户验证 (2)
系列目录 前言: 回顾上一节,我们利用webapi简单的登录并进行了同域访问与跨域访问来获得Token,您可以跳转到上一节下载代码来一起动手. 继续上一篇的文章,我们接下来演示利用拿到的Token来访 ...
- B样条基函数的定义和性质
定义:令U={u0,u1,…,um}是一个单调不减的实数序列,即ui≤ui+1,i=0,1,…,m-1.其中,ui称为节点,U称为节点矢量,用Ni,p(u)表示第i个p次(p+1阶)B样条基函数,其定 ...
- [WARNING] Using platform encoding (GBK actually) to copy filtered resources, i.e. build is platform
eclipse maven clean install 报错 1. 修改properties-->resource-->utf-8仍然报错 2.修改项目pom.xml文件,增加: < ...
- 【Python五篇慢慢弹】快速上手学python
快速上手学python 作者:白宁超 2016年10月4日19:59:39 摘要:python语言俨然不算新技术,七八年前甚至更早已有很多人研习,只是没有现在流行罢了.之所以当下如此盛行,我想肯定是多 ...
- Java类变量和成员变量初始化过程
一.类的初始化 对于类的初始化:类的初始化一般只初始化一次,类的初始化主要是初始化静态成员变量. 类的编译决定了类的初始化过程. 编译器生成的class文件主要对定义在源文件中的类进行了如下的更改: ...
- JavaScript学习笔记(二)——闭包、IIFE、apply、函数与对象
一.闭包(Closure) 1.1.闭包相关的问题 请在页面中放10个div,每个div中放入字母a-j,当点击每一个div时显示索引号,如第1个div显示0,第10个显示9:方法:找到所有的div, ...
- BPM SharePoint解决方案分享
一.需求分析 SharePoint作为微软推出的协同类平台产品,为客户提供了门户.内容.文档.流程.社区.搜索.BI等一系列的解决方案,然而其流程功能由于设计理念差异,不能完全满足客户的需求,主要原因 ...