
Kafaka高可用集群环境搭建
zk集群环境搭建:https://www.cnblogs.com/toov5/p/9897868.html
三台主机每台的Java版本1.8
下面kafka集群的搭建:
3台虚拟机均进行以下操作:
// 解压下载好的kafka压缩包并重命名
cd /home
wget http://mirror.bit.edu.cn/apache/kafka/1.1.1/kafka_2.11-1.1.1.tgz
tar -xzvf kafka_2.11-1.1.1.tgz
mv kafka_2.11-1.1.1 kafka
// 修改配置文件
vi ./kafka/config/server.properties
修改如下:
主机1的:(其他主机类似)
broker.id=0 #做标记的哦 其他的主机 1 2 与Zookeeper的data目录下的myId一致!
listeners=PLAINTEXT://192.168.91.1:9092 #监听的IP地址和端口号 这其实是个协议 要写全! 监听的本机的ip端口号哈 其他的主机ip地址更改
zookeeper.connect=192.168.91.1:2181,192.168.91.3:2181,192.168.91.4:2181 #zk的集群地址
然后修改系统环境中配置kafka的路径
vi /etc/profile
// 在文件最下方添加kafka路径
export KAFKA_HOME=/home/kafaka/kafka
// PATH的修改 多路径PATH写法为PATH=${ZOOKEEPER_HOME}/bin:${KAFKA_HOME}/bin:$PATH
$PATH:${KAFKA_HOME}/bin
我的配置后:
export PATH=$PATH:${KAFKA_HOME}/bin:$JAVA_HOME/bin:$ZOOKEEPER_HOME/bin:$PATH

// 使修改完的环境变量生效
source /etc/profile
此时 其他的两台
scp -r ./kafaka/ root@192.168.91.3:/home
scp -r ./kafaka/ root@192.168.91.4:/home
然后分别修改server.properties
broker.id=X #做标记的哦 其他的主机 X =1 和 2
listeners=PLAINTEXT://192.168.91.X:9092 #监听的IP地址和端口号 这其实是个协议 要写全! 监听的本机的ip端口号哈 其他的主机ip地址更改
,修改 /etc/profile 与第一台一致
此时的环境便搭建完毕!
先启动Zookeeper集群,
逐个主机启动: /home/zookeeper/zookeeper-3.4.6/bin/zkServer.sh start
查看启动状态: /home/zookeeper/zookeeper-3.4.6/bin/zkServer.sh status
再启动kafka集群
2、在后台开启3台虚拟机的kafka程序
/home/kafaka/kafka
./bin/kafka-server-start.sh -daemon config/server.properties
启动成功!
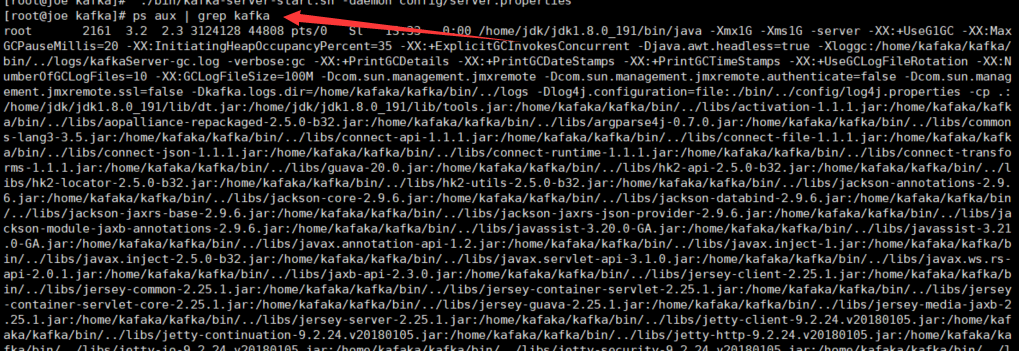
注意每个服务器要关闭防火墙!!
Kafka 没有后台图形化 不跟rabbitmq似的哈哈
查看Zookeeper:
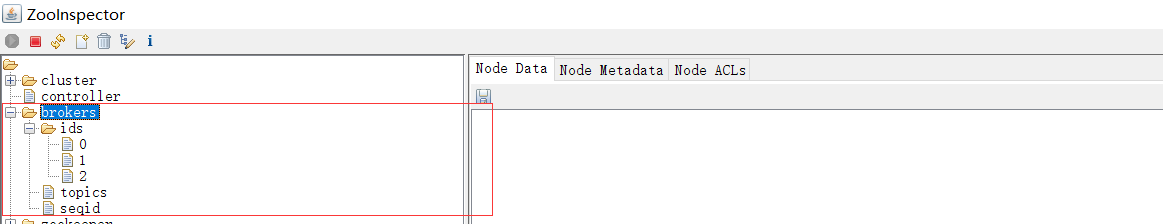
每个broker启动后 会去zk注册信息,创建节点信息

下面创建个topic试试:
参考官网:http://kafka.apachecn.org/quickstart.html
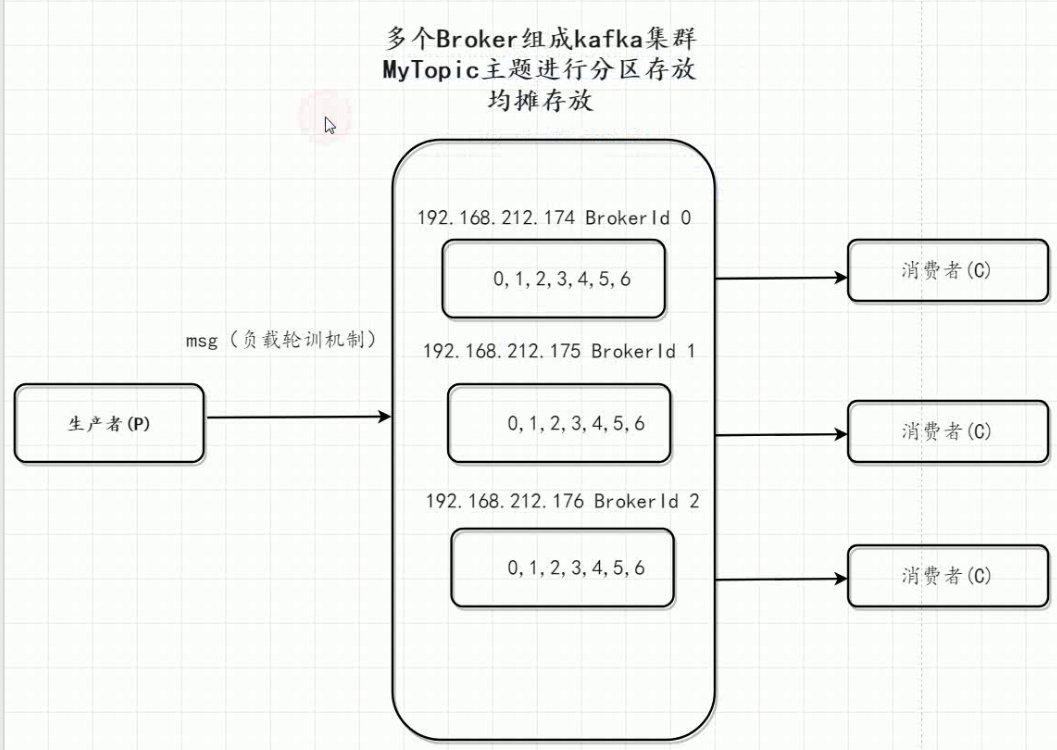
创建topic时候 需要指定分区partition 1 表示只在一个broker里面存放。(单节点存放)
3 表示三个broker里面存放 。生产者投递消息时候 均摊存放!
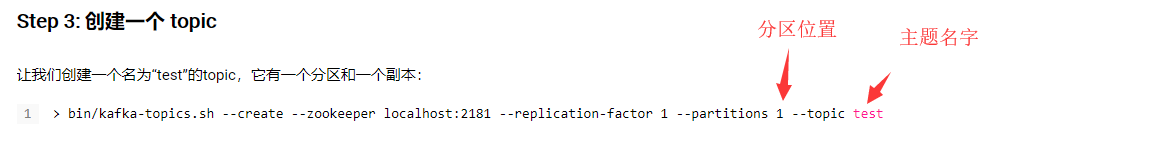
只会在1个broker进行创建
在某一台服务器上创建 topic:
/home/kafaka/kafka/bin/kafka-topics.sh --create --zookeeper 192.168.91.1:2181 --replication-factor 1 --partitions 1 --topic test # 创建topic时候 会向zk进行连接 1表示在单机上存储创建

zk查看:
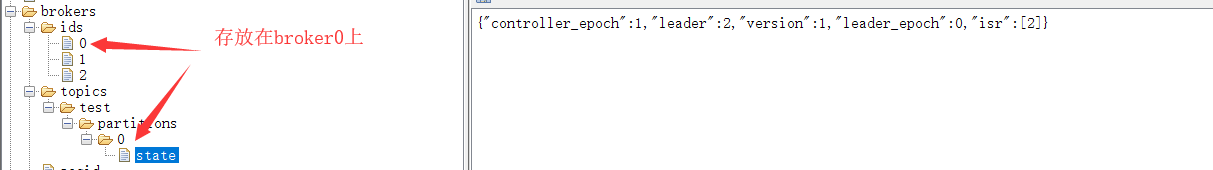
broker就是我们指定的这台服务器上 partition是1 的话每次都投递到 0这个broker上哦
下面介绍下日志查看:
kafka的日志存放是在配置中的 server.properties:

创新topic后发送消息
往指定的broker发送消息
bin/kafka-console-producer.sh --broker-list 192.168.91.1:9092 --topic test
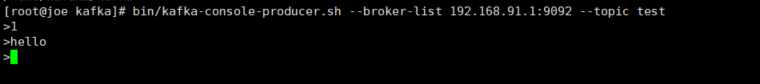
启动consumer进行消费:连接的不是同一台主机,也可以进行消费
bin/kafka-console-consumer.sh --bootstrap-server 192.168.91.3:9092 --topic test --from-beginning

同是一个集群。互通的 ,只是消息存放的地方有别而已。
继续创建topic,存放到三个broker:
/home/kafaka/kafka/bin/kafka-topics.sh --create --zookeeper 192.168.91.1:2181 --replication-factor 1 --partitions 3 --topic my_test_topic
创建成功后查看日志目录:
broker0

broker1

broker2

通过test-0 my_test_topic_x 可以看出编号是有自己的算法的
得出的结论是 topic 在三台不同的节点进行存放的,生产者投递消费进行均摊。
Kafaka高可用集群环境搭建的更多相关文章
- ElasticSearch高可用集群环境搭建和分片原理
1.ES是如何实现分布式高并发全文检索 2.简单介绍ES分片Shards分片技术 3.为什么ES主分片对应的备分片不在同一台节点存放 4.索引的主分片定义好后为什么不能做修改 5.ES如何实现高可用容 ...
- SpringCloud之Eureka高可用集群环境搭建
注册中心集群 在微服务中,注册中心非常核心,可以实现服务治理,如果一旦注册出现故障的时候,可能会导致整个微服务无法访问,在这时候就需要对注册中心实现高可用集群模式. Eureka集群相当简单:相互注册 ...
- rabbitmq+haproxy+keepalived高可用集群环境搭建
1.先安装centos扩展源: # yum -y install epel-release 2.安装erlang运行环境以及rabbitmq # yum install erlang ... # yu ...
- CentOS下RabbitMq高可用集群环境搭建
准备工作 1,准备两台或多台安装有rabbitmq-server服务的服务器 我这里准备了两台,分别如下: 192.168.40.130 rabbitmq01192.168.40.131 rabbit ...
- Mysql高可用集群环境介绍
MySQL高可用集群环境搭建 01.MySQL高可用环境方案 02.MySQL主从复制原理 03.MySQL主从复制作用 04.在Linux环境上安装MySQL 05.在MySQL集群环境上配置主从复 ...
- Apache httpd和JBoss构建高可用集群环境
1. 前言 集群是指把不同的服务器集中在一起,组成一个服务器集合,这个集合给客户端提供一个虚拟的平台,使客户端在不知道服务器集合结构的情况下对这一服务器集合进行部署应用.获取服务等操作.集群是企业应用 ...
- Flink的高可用集群环境
Flink的高可用集群环境 Flink简介 Flink核心是一个流式的数据流执行引擎,其针对数据流的分布式计算提供了数据分布,数据通信以及容错机制等功能. 因现在主要Flink这一块做先关方面的学习, ...
- centos HA高可用集群 heartbeat搭建 heartbeat测试 主上停止heartbeat服务 测试脑裂 两边都禁用ping仲裁 第三十二节课
centos HA高可用集群 heartbeat搭建 heartbeat测试 主上停止heartbeat服务 测试脑裂 两边都禁用ping仲裁 第三十二节课 heartbeat是Linu ...
- Mysql双主双从高可用集群的搭建且与MyCat进行整合
1.概述 老话说的好:瞻前顾后.患得患失只会让我们失败,下定决心,干就完了. 言归正传,之前我们聊了Mysql的一主一从读写分离集群的搭建,虽然一主一从或一主多从集群解决了并发读的问题,但由于主节点只 ...
随机推荐
- js创建对象的最佳方式
1.对象的定义 ECMAScript中,对象是一个无序属性集,这里的“属性”可以是基本值.对象或者函数 2.数据属性与访问器属性 数据属性即有值的属性,可以设置属性只读.不可删除.不可枚举等等 访问器 ...
- CodeIgniter框架——CI中视图路径问题
答: 视图中的所有路径全部和 index.php 同级,也就是和 index.php 属于一个目录下,也就是网站根目录. 因为 index.php 后面看似是路径的东西其实那只是一种 URL 参数而已 ...
- HDU1688(Sightseeing)
题目链接:传送门 题目大意:给你一幅图(单向边),找出从起点到终点有多少条不同路径(最短路或者比最短路长度大1) 题目思路:二维dijkstra,真的是要对dijkstra理解非常透彻才行,距离数组d ...
- 爬虫入门【8】Python连接MongoDB的用法简介
MongoDB的连接和数据存取 MongoDB是一种跨平台,面向文档的NoSQL数据库,提供高性能,高可用性并且易于扩展. 包含数据库,集合,文档等几个重要概念. 我们在这里不介绍MongoDB的特点 ...
- golang 面向对象
深入理解GO语言的面向对象_Golang_脚本之家 https://www.jb51.net/article/94030.htm 深入理解GO语言的面向对象 更新时间:2016年10月04日 10:4 ...
- python系列十一:python3数据结构
#!/usr/bin/python #Python3 数据结构'''Python中列表是可变的,这是它区别于字符串和元组的最重要的特点,一句话概括即:列表可以修改,而字符串和元组不能.''' '''将 ...
- QBuffer简单操作(被看做一个标准的可随机访问的文件,支持信号)
Qt中通过QBuffer类我们可以使用io的方式访问.操作QByteArray中的内容.此时,QByteArray被看做一个标准的可随机访问的文件.例如: QBuffer buffer; char c ...
- java switch case 枚举类型的反编译结果
package com.example.demo; import java.io.PrintStream; // Referenced classes of package com.example ...
- 【AWS】AWS云计算赋能数字化转型专题研讨会
点我查看详情 欢迎莅临
- 4.6 基于STM32+MC20地图显示路径功能
需要准备的硬件 MC20开发板 1个 https://item.taobao.com/item.htm?id=562661881042 GSM/GPRS天线 1根 https://item.taoba ...